关于 AI 的讨论,几乎总会落到同一个争论上:它是继蒸汽机、电力和计算机之后的又一场工业革命,还是一项只会把人换掉、却谈不上真正提高生产力的技术?前一种看法的依据是能力成本断崖式下降和任务效率的大幅提升;后一种看法的依据是迟迟没有出现在宏观统计里的增长,以及越来越多被挤出的岗位。
这两种看法并不像表面上那样对立:历史上每一场工业革命都是从“替代”开始的。一项技术配不配得上“革命”二字,不取决于它替代了多少人,而取决于替代之后能否催生足够多的新任务、新组织和新需求,以及这些收益最终流向了谁。
要判断哪一方更接近事实,需要先回到一个更基本的问题:经济史上的“工业革命”究竟是按什么标准认定的。
判断一场工业革命,标准到底是什么?
“工业革命”不是发明那一刻就能宣布的称号,而是事后从数据里追认的结果。经济学家通常用“通用目的技术”(General Purpose Technology)来描述蒸汽机、电力和计算机这类技术,并据此判断一项技术能否带来革命性的变化。这类技术一般有三个特征:
- 渗透性:不局限于某个行业,而是进入几乎所有生产环节;
- 持续改进:性能不断提升、成本不断下降,适用范围随之扩大;
- 催生互补创新:围绕它会长出新的设备、组织方式、商业模式乃至职业。
满足这三点,只是成为革命的必要条件。真正让后人称之为“革命”的,是长期、持续的生产率提升,也就是同样的投入能换来明显更多的产出。
这里有一个常被忽略的历史细节。英国工业革命的头几十年,并不是一个“人人受益”的时期。经济史学家 Robert Allen 的研究显示,19 世纪上半叶英国的人均产出持续增长,实际工资却长期停滞,利润率翻了一倍,利润在国民收入中的占比上升,劳动者和土地所有者的份额相应下降。直到 19 世纪中叶以后,工资才开始与生产率同步上涨(来源)。这一现象后来被称为“恩格斯停顿”。
换句话说,“生产率提高”和“劳动者被替代、没有分享收益”,在历史上曾经同时成立。例如,动力织机普及后,英国的手摇织布工收入大幅下滑、整个职业走向消失,而棉纺织业的总产出却在快速扩张。站在当时织布工的位置,这场“革命”看起来就是一场替代。
由此可以看出,今天关于 AI 的争论其实混在一起讨论了两个问题:一是效率问题,AI 能不能让同样的投入产出更多;二是分配问题,产出增加之后,好处由谁获得。很多看似针锋相对的观点,只是各自在回答其中一个问题。
认为这是一场革命的人,看到了什么?
支持“新工业革命”说法的一方,依据并不只是对技术的乐观,而是几组相当硬的事实。
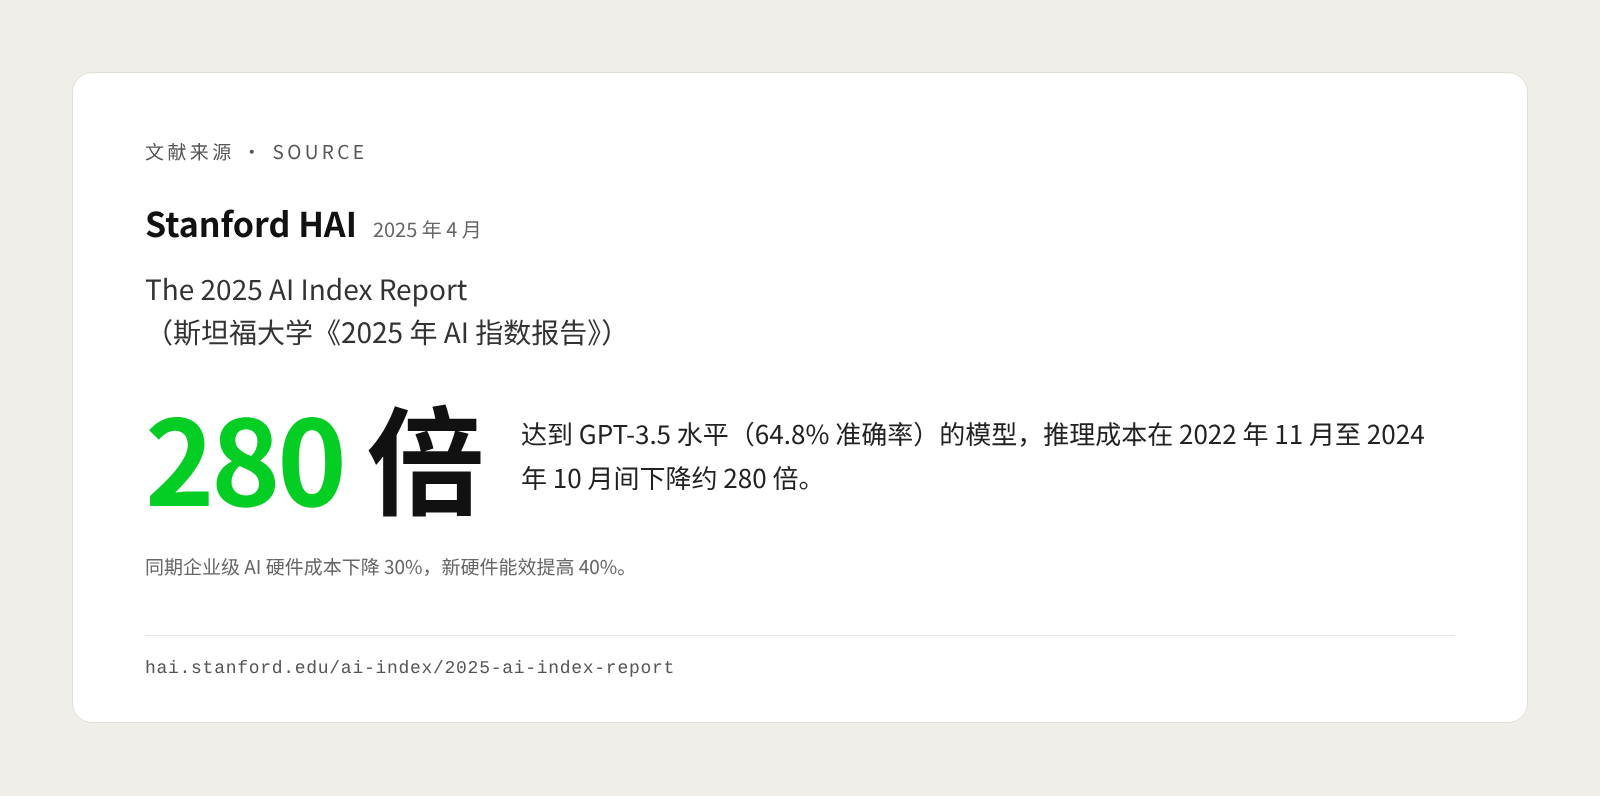
第一,能力的成本正在以罕见的速度下降。斯坦福大学《2025 年 AI 指数报告》统计,达到 GPT-3.5 水平的模型,推理成本在 2022 年 11 月到 2024 年 10 月间下降了约 280 倍(来源)。蒸汽动力、电力和算力的扩散,都以单位成本大幅下降为前提。一种能力一旦便宜到可以随处使用,就会被嵌进原本不值得自动化的环节里,这正是“渗透性”的来源。
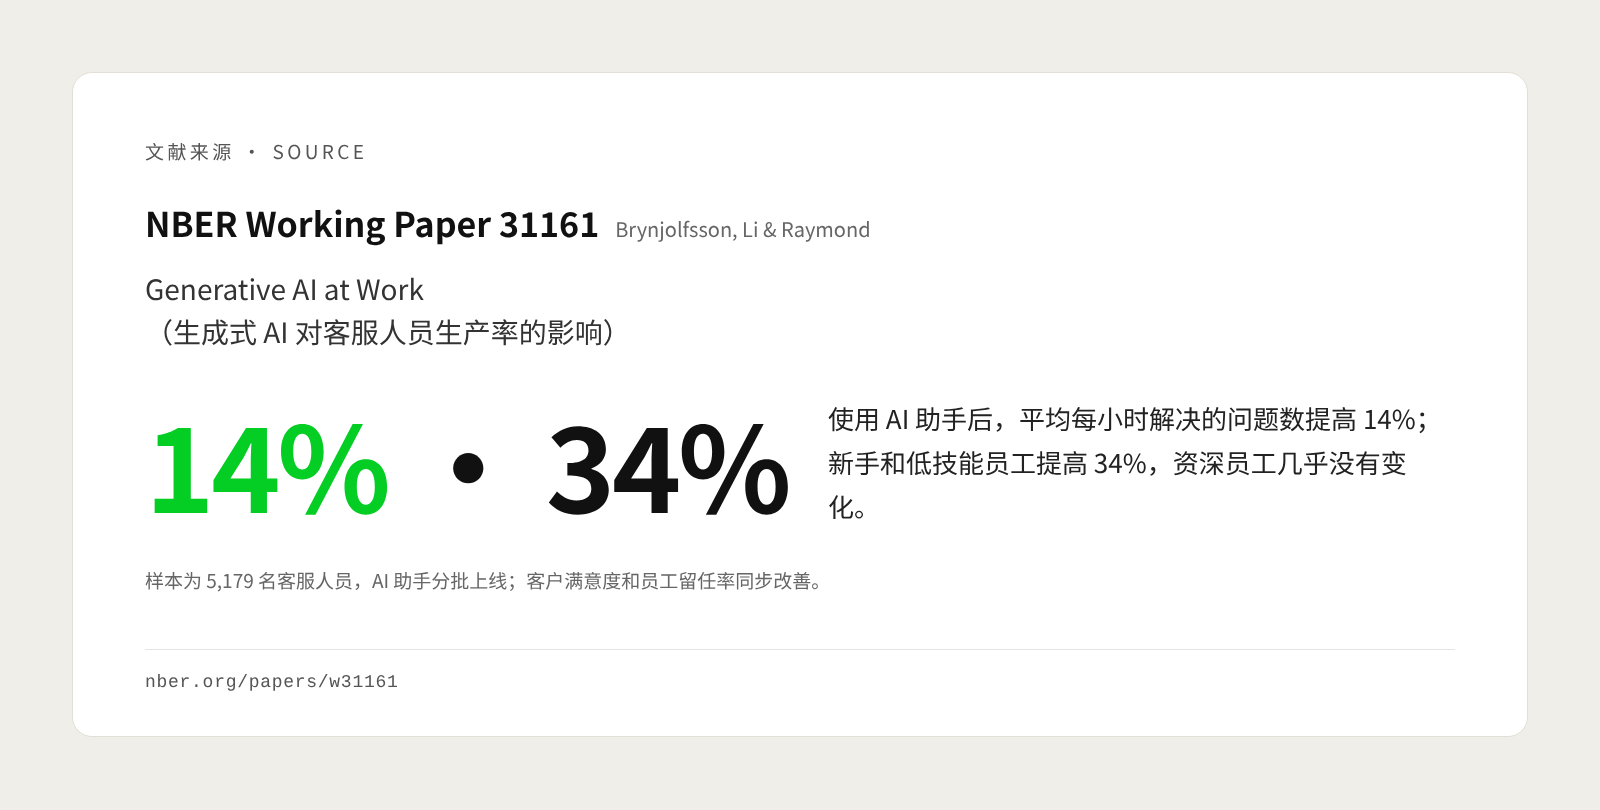
第二,在受控实验里,效率提升是可以测量的。Erik Brynjolfsson 等人追踪了 5,179 名客服人员分批使用生成式 AI 助手的过程:平均每小时解决的问题数提高 14%,新手和低技能员工提高 34%,资深员工则几乎没有变化;客户满意度和员工留任率也有所改善(来源)。
这组数据里有一个值得细读的地方。AI 给新手带来的帮助最大,意味着它实际上把资深员工的隐性经验“打包”给了新人。过去几十年的信息技术大多更偏向高技能者,而生成式 AI 在这个场景里的作用方向恰好相反,收窄了技能差距。支持者认为,这正是“解放人”的具体含义:普通人用更短的时间达到过去需要多年经验才能达到的水平。
第三,宏观推算的量级足以和历史上的大技术相比。高盛研究部门 2023 年估算,生成式 AI 有望在十年内使全球 GDP 提高约 7%(接近 7 万亿美元),并使生产率年增速提高 1.5 个百分点;美国约三分之二的职业在不同程度上暴露于 AI 自动化,其中 25% 到 50% 的工作量可能被替代(来源)。
第四,这是自动化第一次大规模进入认知劳动。蒸汽机和电力释放的主要是体力,计算机主要处理规则明确的信息任务。生成式 AI 第一次大规模触及写作、分析、编码、设计这类需要理解语境的工作。例如,一份合同初审、一版市场文案、一段数据清洗脚本,过去都以“人天”计价,现在的边际成本已经接近一次模型调用。支持者的逻辑是:知识工作在发达经济体中占据了最大的劳动份额,影响这一部分的技术,其潜在影响面自然不会小于以往。
为什么也有人认为 AI “配不上”革命这个词?
怀疑派并不否认 AI 能完成大量工作。他们质疑的是:完成了这些工作,是否就等于生产力的显著提高。
宏观账算下来,数字可能小得多。MIT 经济学家 Daron Acemoglu 用任务层面的证据反推宏观影响,得出未来十年 AI 对全要素生产率的提升不超过 0.66%;如果考虑到难以学习的任务,这一数字会降到 0.53% 以下(来源)。它和高盛“生产率年增速提高 1.5 个百分点”的估算相差了一个数量级。
差异主要来自一个假设。Acemoglu 指出,目前的实验证据大多来自“容易学习”的任务,结果好坏有客观标准,比如客服工单是否解决。而大量高价值工作依赖语境判断,缺少可以直接对照的“正确答案”。把易学任务上的提升直接外推到整个经济,很可能高估了总效果。
“马马虎虎的自动化”只替代,不增效。Acemoglu 与 Pascual Restrepo 提出过“so-so automation”的概念:有些技术的效率刚刚好到足以替换工人,却没有好到能显著降低成本、带动产品扩张。结果是劳动份额下降,生产率却几乎没有改善(来源)。例如,超市自助结账把收银工作转移给了顾客,商家省下了人工,整个购物流程却并没有变得更快。怀疑派担心,大量“AI 取代一个岗位”的部署属于同一类型。
感觉变快了,不等于真的变快了。非营利研究机构 METR 在 2025 年进行了一项随机对照试验:16 名资深开源开发者在自己熟悉的大型代码库中完成 246 项真实任务,使用 AI 工具时平均反而多花了 19% 的时间。他们事前预期 AI 会让自己快 24%,事后仍然相信自己快了约 20%(来源)。样本很小,场景也很特殊,不能推广到所有工作。但它揭示了一个重要的测量问题:企业很多关于“AI 提效”的判断来自员工的自评,而自评与客观结果之间可能存在系统性偏差。
新任务的创造正在放慢。MIT 经济学家 David Autor 等人的研究发现,美国今天约 60% 的工作属于 1940 年之后才出现的新型工作,这是“技术创造就业”的有力证据。但同一项研究也发现,1980 年到 2018 年间自动化对就业的负面冲击是 1940 年到 1980 年间的两倍多,而创造新任务的“增强”效应增长得更慢(来源)。如果这一趋势延续到 AI 时代,“替代”就会跑在“创造”前面。
从分配角度看,Acemoglu 还认为,AI 对不同人群的影响比以往的自动化更均匀,未必会大幅拉大劳动者内部的收入差距,却很可能拉大资本收入与劳动收入之间的差距。这正是“AI 是在替代人”这一直觉背后更精确的经济学表述:生产力也许提高了,增加的产出却主要变成了资本的回报。
任务层面的效率那么明显,为什么宏观数据里还看不到?
这并不是 AI 独有的困惑。1987 年,诺贝尔经济学奖得主 Robert Solow 留下了一句被反复引用的话:“计算机时代随处可见,唯独在生产率统计里看不到。”这就是后来所说的“生产率悖论”。直到 1990 年代中后期,信息技术带来的生产率加速才在美国的数据中清晰地显现出来。
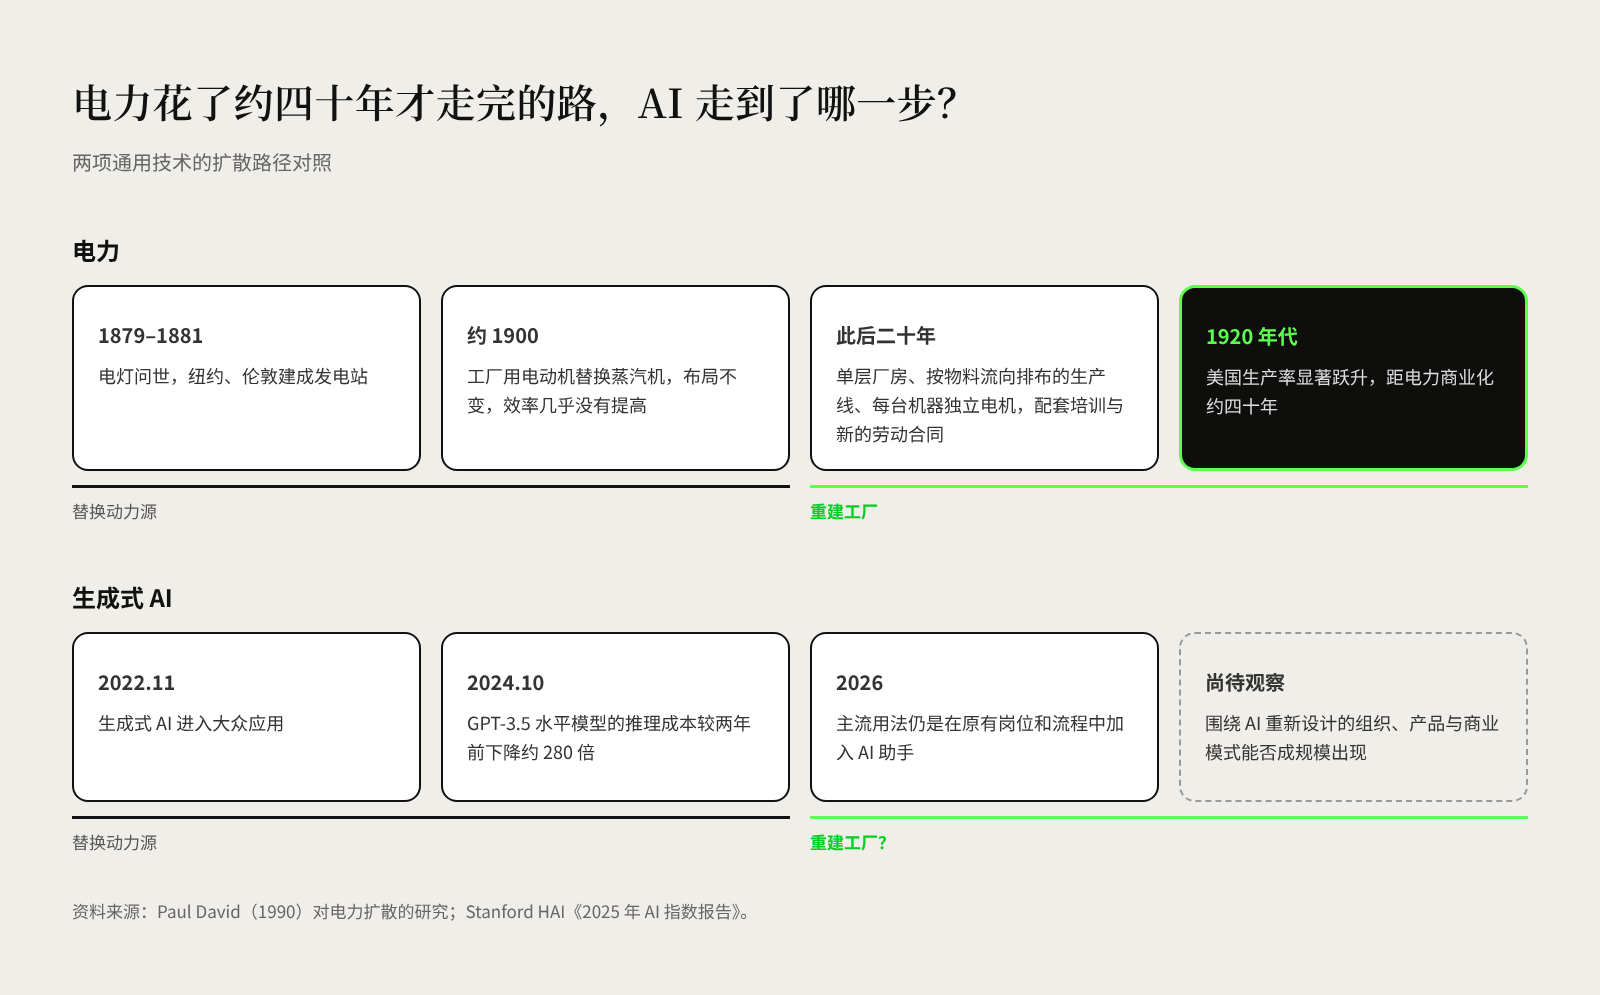
经济史学家 Paul David 在 1990 年用电力的历史解释了这种延迟。电灯在 1879 年就已问世,纽约和伦敦在 1881 年前后就有了发电站,但到 1900 年,企业效率仍然看不出什么改变。原因在于,工厂最初只是用电动机替换了原来的蒸汽机,原有厂房布局、传动轴和工序都没有变,生产率几乎没有提高。真正的变化来自后来的重新设计:单层厂房、按物料流向排列的生产线、每台机器配备独立的小电机,以及与之配套的工人培训和劳动合同。美国生产率的跃升直到 1920 年代才出现,距电力商业化大约四十年(来源)。
Brynjolfsson 与合作者后来把这一现象概括为“生产率 J 曲线”:通用技术要发挥作用,需要大量配套的无形投资,包括流程重构、数据整理、员工培训和新的管理方式。这些投入在统计上很难被计为资本,因此在早期会压低测量到的生产率,等配套完成后才会集中释放收益(来源)。
把这段历史放回今天的争论中,可以得出一个重要的推论:怀疑派描述的,很可能是“用电机替换蒸汽机”的阶段;革命派押注的,则是“重建工厂”的阶段。当下企业使用 AI 的主流方式,是在原有岗位和流程里加入一个助手。这与当年把电动机装进蒸汽时代的厂房十分相似:局部效率提高了,系统却没有变。
但这个类比也有局限。电力的扩散受制于电网和厂房这些物理资产的更新周期,而 AI 主要通过软件和云服务传播,理论上可以更快。另一方面,组织结构、岗位设置和监管规则的调整速度,并不会因为技术是软件就自动加快。AI 能否比电力更快走完 J 曲线,取决于瓶颈在技术一侧还是在组织一侧,这也是两派在时间尺度上产生分歧的根源。
两种观点的分歧,究竟落在哪里?
把双方的论证拆开来看,它们在事实层面的冲突其实不多。真正的分歧,分布在以下几个维度上。
| 维度 | 革命派的判断 | 怀疑派的判断 | 现有证据指向 |
|---|---|---|---|
| 衡量单位 | 任务和企业层面的效率 | 宏观全要素生产率、工资与劳动份额 | 任务层面的提升已被证实,宏观层面尚未显现 |
| 时间尺度 | 以通用技术扩散的数十年为参照 | 关注未来五到十年 | 电力的收益花了约四十年才显现 |
| 替代与新任务 | 替代之后会出现大量新任务 | 新任务的创造跟不上替代 | 1980 年后自动化加快、增强放缓 |
| 外推方式 | 易学任务的提升会逐步扩展到难学任务 | 难学任务的收益会明显更小 | 客服提升 14%,资深开发反而慢了 19% |
| 收益归属 | 新手和低技能者受益最大 | 资本收入相对劳动收入扩大 | 两种效应可能同时存在 |
| 容易低估的因素 | 组织重构的难度和周期 | 能力成本下降的速度 | 两者都在快速变化 |
从表中可以看出,双方最根本的分歧在于对“新任务”的判断。如果 AI 主要用于把现有工作做得更便宜,它更接近怀疑派描述的“马马虎虎的自动化”;如果它催生出过去不可能存在的产品、服务和职业,它就更接近革命派描述的那样一场工业革命。
这意味着,“替代还是增效”并不完全是由技术本身决定的。同样一套大模型,可以被用来裁掉一个客服团队,也可以被用来让同一个团队提供过去提供不了的个性化服务。Acemoglu 和 Autor 都强调过,技术的发展方向受到企业激励、税制和制度安排的影响。例如,当资本投入在税收上比雇佣员工更有利时,企业更倾向于把 AI 用在“省人”上,而不是“加力”上。
哪些信号能说明天平正在向哪一边倾斜?
既然争论的关键在于未来而不是现在,那么更有价值的问题就不是“谁对”,而是“什么证据会让一方变得更有说服力”。以下五类信号,可以帮助判断趋势。
- 宏观生产率是否出现持续拐点。单一年份的增长可能来自经济周期,只有连续多年高于趋势的劳动生产率增长,才能与 1920 年代和 1990 年代后期相提并论。
- 劳动收入份额的走向。如果生产率上升的同时劳动份额持续下降,说明新增产出主要流向了资本,这会是一种类似“恩格斯停顿”的局面。
- 新职业出现的速度。Autor 的研究方法是追踪人口普查中新增的职业名称。未来十年里围绕 AI 出现的新职业是否具有规模,而不只是少数高薪技术岗位,将直接检验“替代跑在创造前面”的担忧。
- 企业是在“换动力源”还是“重建工厂”。如果企业主要把 AI 当作现有岗位的插件,宏观收益大概率有限;如果开始出现围绕 AI 重新设计的组织结构、产品和商业模式,J 曲线的上升段才可能到来。
- 难学任务上的实验证据。目前最可靠的数据大多来自客服、写作、编码等可以清晰衡量结果的场景。当医疗诊断、科研发现、复杂决策这类任务的随机对照证据积累起来,Acemoglu 和高盛之间那个数量级的差距才会逐渐收窄。
这些信号中,前两项是结果,后三项是原因。结果类指标通常会滞后数年,而原因类指标在企业和行业层面已经可以观察到。对于想在统计数据出来之前就做出判断的人来说,后三项更值得持续跟踪。
结语
认为 AI 是新一场工业革命的人,和认为它只是在替代人的人,很可能在描述同一个过程的不同阶段。蒸汽机和电力都曾经先以“替代”的面目出现,生产率的提升和劳动者的收益都在很久之后才到来,而且并非自动到来。
由此看,“AI 是不是工业革命”更像一个留给未来的问题,而不是今天就能下定论的事实。更值得讨论的是另一个问题:在替代已经发生、新任务尚未成型的这段时间里,技术会被引向哪个方向,收益又会如何分配。工业革命的称号是由后人追认的,而决定后人如何评价这个时代的,恰恰是这段过渡期里的选择。
参考资料
- Allen, R. C. Engels' pause: Technical change, capital accumulation, and inequality in the British industrial revolution. Explorations in Economic History, 2009
- Stanford HAI. The 2025 AI Index Report
- Brynjolfsson, E., Li, D., Raymond, L. Generative AI at Work. NBER Working Paper 31161
- Goldman Sachs. Generative AI could raise global GDP by 7%, 2023
- Acemoglu, D. The Simple Macroeconomics of AI. NBER Working Paper 32487
- Acemoglu, D., Restrepo, P. Automation and New Tasks: How Technology Displaces and Reinstates Labor. Journal of Economic Perspectives, 2019
- The Decoder. AI coding can make developers slower even if they feel faster, 2025
- MIT News. Does technology help or hurt employment? 2024
- History News Network. Paul David: It took decades for the economic impact of electricity to be felt
- Brynjolfsson, E., Rock, D., Syverson, C. The Productivity J-Curve. American Economic Journal: Macroeconomics, 2021