企业决定引入大模型时,最先冒出来的问题往往不是“用来做什么”,而是“用哪一家”。新模型几乎每个月都在发布,排行榜上的名次也在不断变化,今天的“最强模型”,几个月后可能就被超越。对企业来说,比“哪个模型最强”更重要的,是选对使用方式、管好数据流向,并保留随时更换模型的能力。
本文将介绍企业使用大模型的三种主要方式及其利弊、开放权重模型与闭源模型的真实差距、数据合规需要注意的要点,以及为什么不应只押注一个模型,最后给出一份分步选型指南和常见问题解答。
企业使用大模型有哪几种方式?
企业使用大模型,主要有三种方式:调用闭源模型的 API、使用开放权重模型、本地或私有化部署。三者的根本区别不在模型本身,而在于“谁来运行模型、数据流向哪里、出了问题谁负责”。
调用闭源模型 API。 API(应用程序接口)可以理解为一个“远程调用窗口”:企业把问题和资料发给模型厂商,厂商在自己的服务器上运行模型,再把结果返回。GPT、Claude、Gemini 等都提供这种服务,通常按调用量付费,模型的内部参数(即“权重”)不对外公开。
使用开放权重模型。 开放权重(open-weight)模型的权重可以下载,例如 Llama、Qwen、DeepSeek、Mistral 等系列中的部分模型。企业可以把它部署在自己租用的云服务器上(自托管),也可以使用第三方平台提供的托管服务。需要注意,“开放权重”不等于没有限制,各家许可证差别很大。例如,Meta 的 Llama 4 社区许可证规定,月活跃用户超过 7 亿的使用方需另行向 Meta 申请授权,并要求在相关产品或网站上显著标注“Built with Llama”(来源)。
本地或私有化部署。 把模型部署在企业自有机房或专属环境中,数据不离开企业网络。这种方式通常使用开放权重模型,控制力最强,但硬件、运维和安全责任也全部由企业承担。
下表比较了三种方式的主要差异:
| 对比项 | 闭源模型 API | 开放权重模型(云上自托管或第三方托管) | 本地 / 私有化部署 |
|---|---|---|---|
| 能力 | 通常处于最前沿,开箱即用 | 头部模型接近前沿,可选范围广 | 受自有硬件限制,常用中小尺寸模型 |
| 上手速度 | 最快 | 中等 | 最慢,需采购硬件、搭建环境 |
| 成本结构 | 按量付费,前期投入小,用量越大费用越高 | 托管按量付费,或自租算力;用量大且稳定时可能更省 | 前期硬件投入大,另有电力、运维和人员成本 |
| 数据控制 | 数据发送给厂商,主要靠合同约束 | 自托管时数据留在自己的云环境;托管时取决于托管方条款 | 最强,数据不出企业网络 |
| 合规重点 | 数据处理协议、数据存放地区、是否出境 | 模型许可证、托管方条款 | 便于满足本地化要求,但安全责任全在自己 |
| 运维难度 | 低,由厂商负责 | 中到高 | 高,需要专门的技术团队 |
| 可定制性 | 取决于厂商开放的功能 | 高,可以微调 | 高,可以微调 |
表中为一般情况,同一类方案在不同供应商之间也可能差别很大。
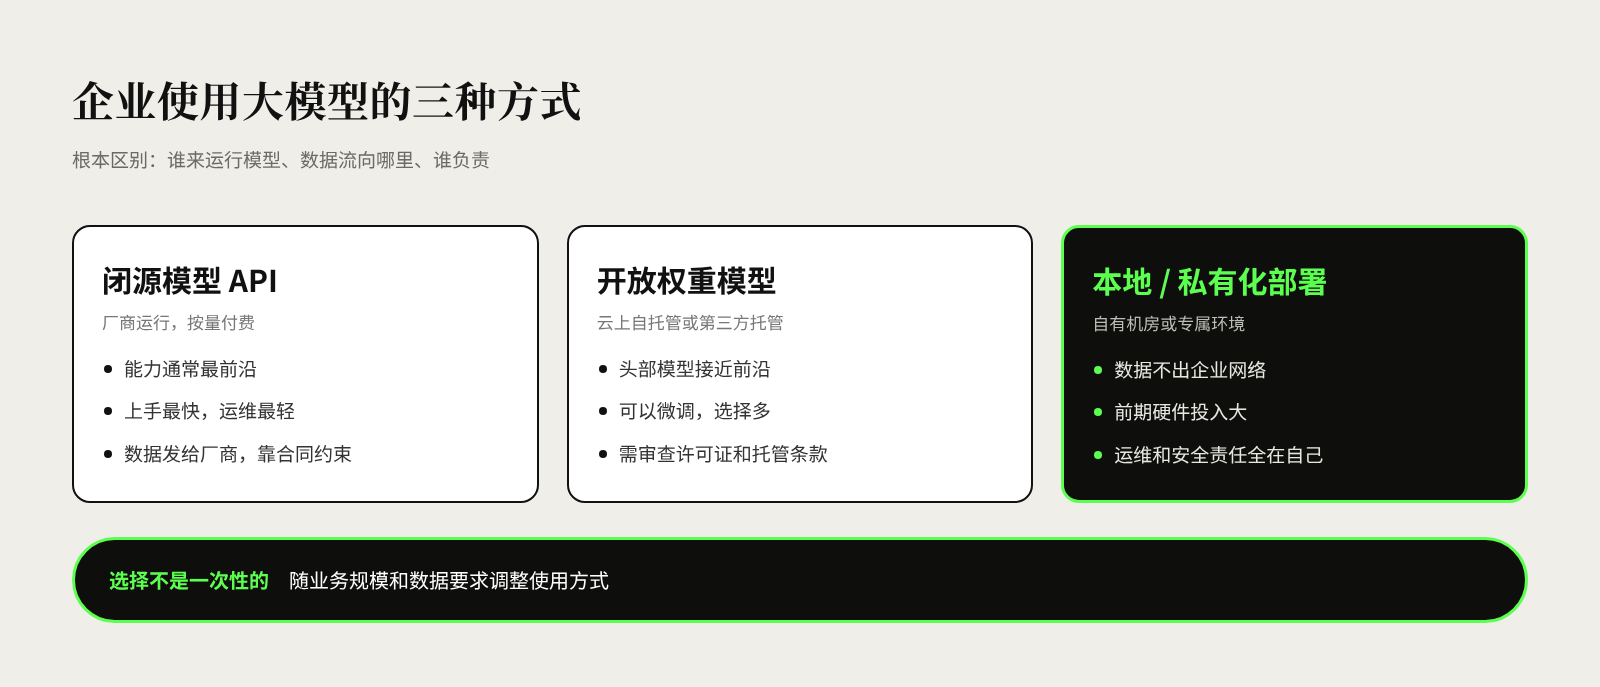
例如,一家分销企业想用 AI 从供应商发票中自动提取金额、税号和到期日。试点阶段票据量不大,直接调用 API 最省事;等到推广至全集团、调用量大且稳定,又对数据外传有严格要求时,自托管开放权重模型在成本和合规上可能更有优势。使用方式不是一次性的选择,而应随业务规模和数据要求调整。
开放权重模型和闭源模型的差距有多大?
过去两年,开放权重模型进步很快。两者的差距已从明显的代差缩小到个位数百分比,但并没有消失,而且会来回波动。
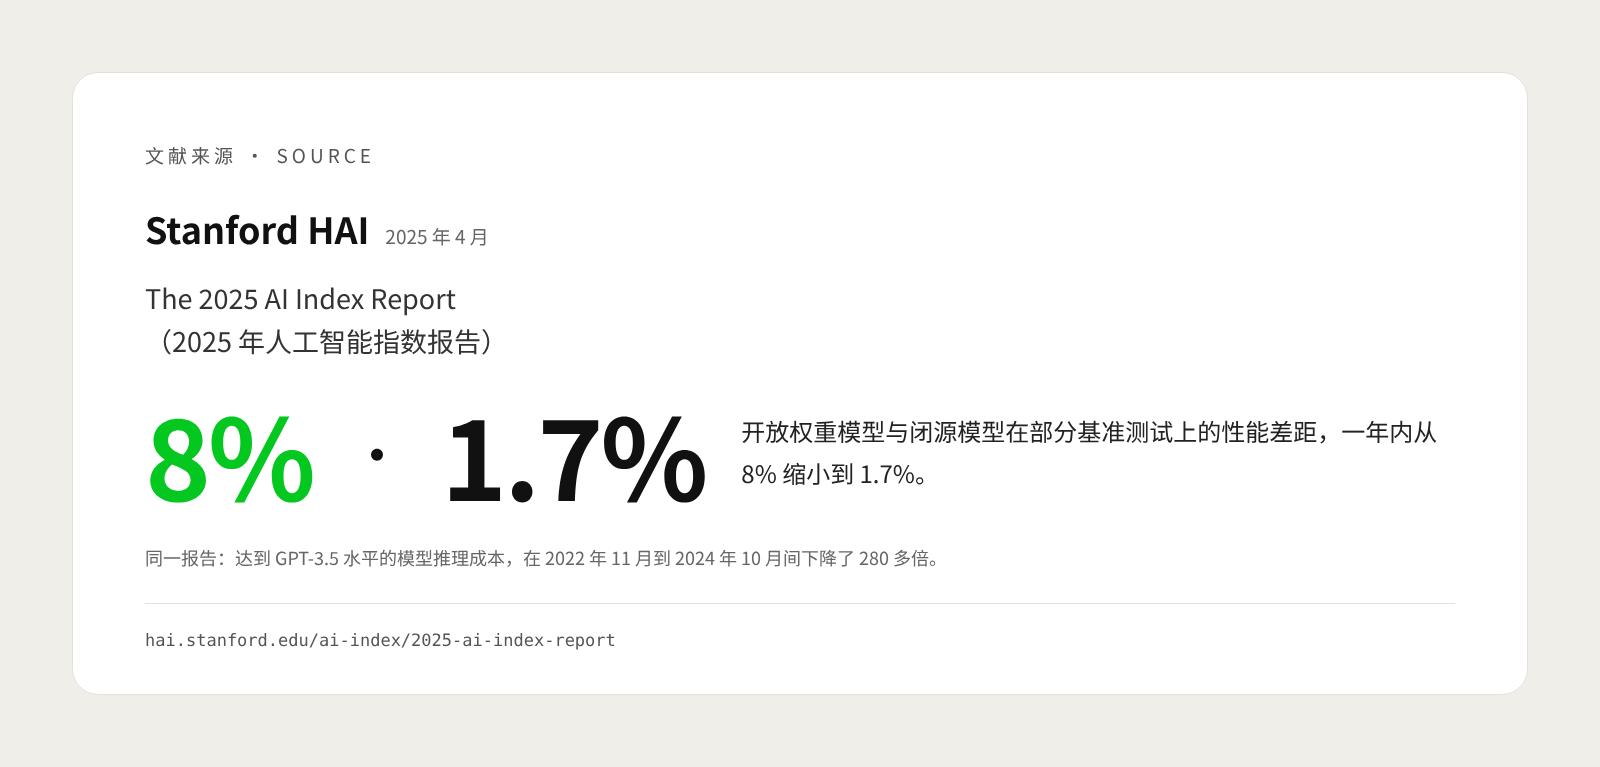
斯坦福大学以人为本人工智能研究院(Stanford HAI)2025 年 4 月发布的《AI Index 2025》指出,开放权重模型与闭源模型在部分基准测试上的性能差距,在一年内从 8% 缩小到 1.7%;同时,达到 GPT-3.5 水平的模型推理成本,在 2022 年 11 月到 2024 年 10 月间下降了 280 多倍(来源)。
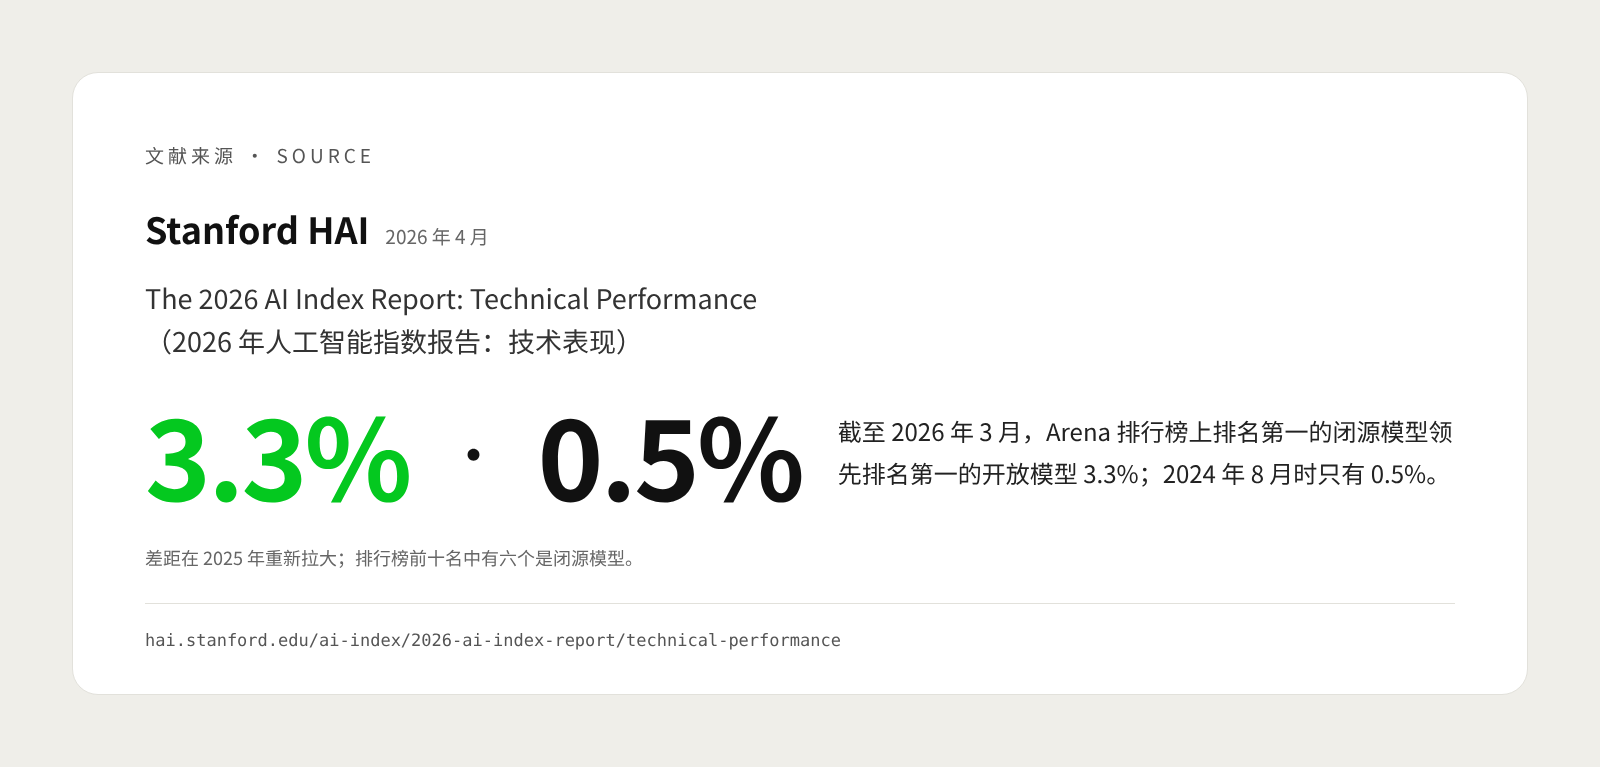
但 2026 年 4 月发布的新一期报告显示,这一差距在 2025 年又有所拉大:截至 2026 年 3 月,在 Arena 排行榜上,排名第一的闭源模型领先排名第一的开放模型 3.3%,而 2024 年 8 月时这一差距只有 0.5%;排行榜前十名中有六个是闭源模型。报告同时指出,多家美国和中国厂商的模型都处在第一梯队,彼此分数接近,竞争的重点正在转向成本、稳定性和特定领域的表现(来源)。
这些数据对企业有三点启示:
- 不要把排名当作长期结论。 同一份报告提到,自 2025 年初以来,美国和中国的模型已多次交替领先。今天的第一名,未必是明年的第一名。
- 排行榜分数只能作参考。 报告还提醒,常用评测集存在可靠性问题,有研究发现部分评测集中无效题目的比例最高达 42%(来源)。通用排行榜上的几个百分点,未必能反映在你的具体业务上。
- 很多任务并不需要最前沿的模型。 对于工单分类、单据信息提取、内部文档摘要这类任务,能力足够、成本更低、数据更可控的方案,往往比“最强”的方案更合适。
例如,一家连锁零售企业用模型把门店的顾客反馈自动归类为“商品质量”“服务态度”“价格”等类别。这类任务规则清晰,一个中等规模的开放权重模型可能就足以胜任;而为采购部门分析复杂的供应商合同,则可能值得使用能力更强的模型。到底够不够用,要用自己的数据测出来,而不是看排行榜。
选择大模型时,数据合规要注意什么?
很多企业在选型时只比较能力和价格,却忽略了数据的去向。选模型时,合同条款和数据流向与模型能力同样重要。 以下三个层面最常被问到,具体适用仍需结合企业情况咨询法律顾问。
欧盟《通用数据保护条例》(GDPR)。 如果业务涉及欧盟个人数据,需要特别留意两点。第一,GDPR 第 28 条规定,委托他人处理个人数据时,只能选择能提供充分保障的处理者,并且双方的处理关系要以合同等具有约束力的法律文件来规范。第二,第五章(第 44 条起)规定,把个人数据传输到欧盟以外,必须满足该章的条件;在没有“充分性认定”的情况下,需要提供适当的保障措施,例如采用标准数据保护条款(来源)。
中国的数据出境规定。 如果企业在中国境内收集数据,而所用的模型服务器位于境外,向模型发送数据就可能构成数据出境。国家互联网信息办公室 2024 年 3 月施行的《促进和规范数据跨境流动规定》区分了几种情形:关键信息基础设施运营者以外的数据处理者,自当年 1 月 1 日起累计向境外提供不满 10 万人的个人信息(不含敏感个人信息),可免于申报安全评估、订立标准合同或认证;10 万人以上、不满 100 万人的(或敏感个人信息不满 1 万人的),需订立个人信息出境标准合同或通过个人信息保护认证;个人信息达 100 万人以上或敏感个人信息达 1 万人以上的,以及涉及重要数据的,需申报数据出境安全评估(来源)。例如,把全国会员的消费记录发给境外模型做分析,就需要先评估是否落入这些情形。
供应商的数据使用条款。 同一家供应商,不同版本的条款可能完全不同。以谷歌的 Gemini API 附加服务条款为例:使用免费服务时,谷歌会用提交的内容和生成的回答来改进产品,人工审核员可能会阅读这些内容,条款明确提醒不要提交敏感、机密或个人信息;使用付费服务时,谷歌不会用这些内容改进产品,数据按数据处理附录处理,仅为防止滥用和满足法律要求而保留有限时间(来源)。OpenAI 也在其企业隐私承诺页面中声明,不使用企业的业务数据训练模型(来源)。这意味着,员工用个人免费账号处理公司资料,可能与企业采购的正式服务适用完全不同的数据规则。
签约前,至少应向供应商确认以下几项:
- 数据存放和处理在哪个国家或地区;
- 输入和输出是否会被用于训练或改进模型;
- 数据保留多长时间,能否申请删除;
- 是否会有人工审核,审核人员在哪里;
- 是否使用了其他分包处理方,变更时是否会提前通知。
为什么不要只押注一个模型?
把所有业务都绑在一个模型上,看似简单,实际上把成本、能力和风险都交给了单一供应商。应当把“可以换模型”当作一开始就要满足的要求,而不是出了问题之后再补救。
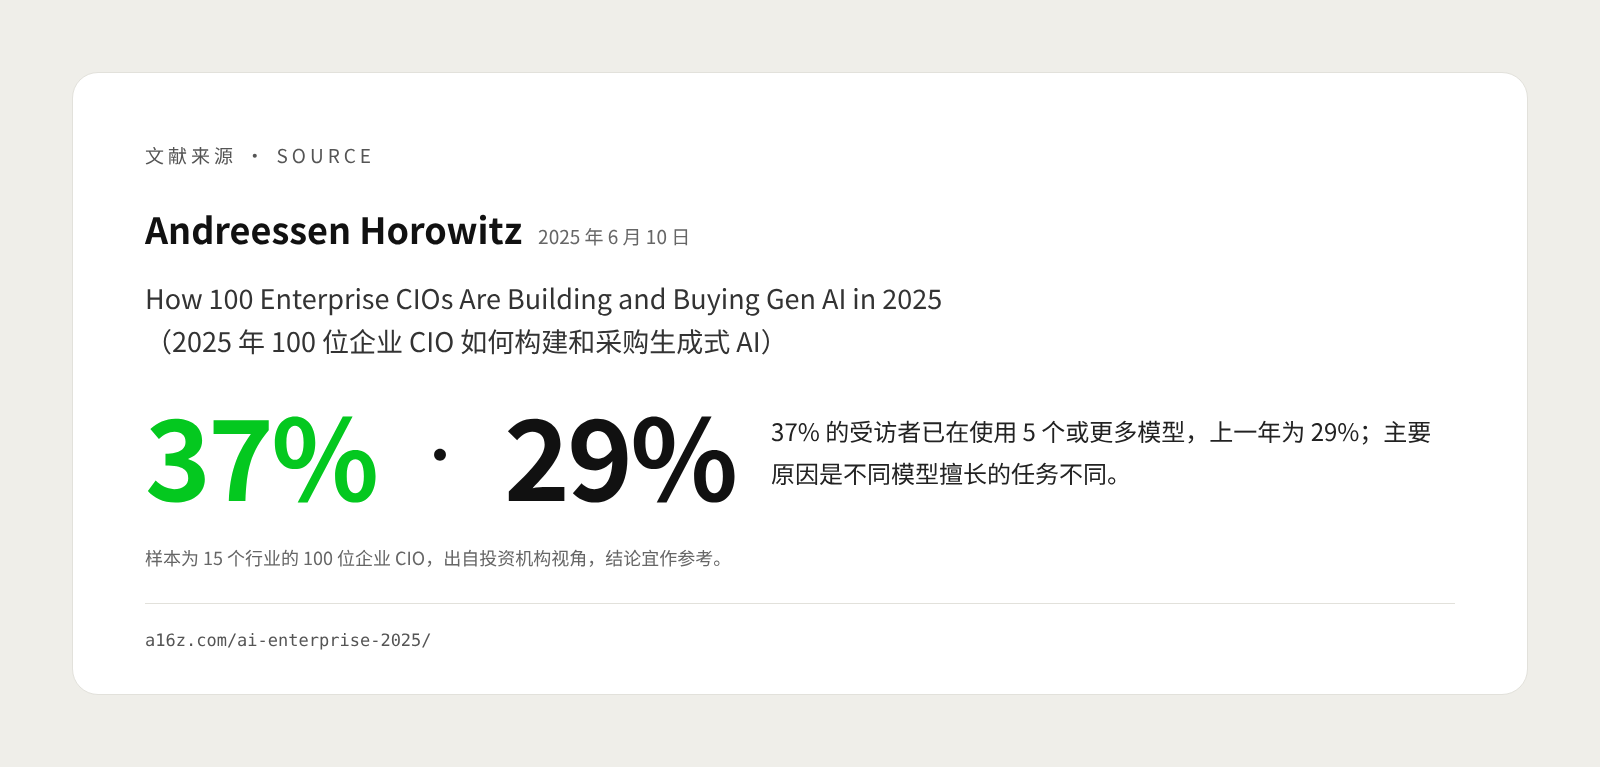
企业的实际做法也在朝这个方向走。投资机构 a16z 在 2025 年 6 月发布的调研中访问了 15 个行业的 100 位企业 CIO,37% 的受访者已在使用 5 个或更多模型,上一年为 29%;企业从多家供应商采购模型,主要原因是不同模型擅长的任务不同,同时也为了避免被单一厂商锁定。但调研也发现,换模型的成本在上升:团队已针对特定模型调整了提示词和防护规则,而在多步骤的智能体流程中,改动一个环节可能影响后续多个环节(来源)。这项调研的样本只有 100 人,且出自投资机构视角,结论宜作参考。
多模型的常见做法是“路由”(routing),即根据任务的特点,把请求自动分配给最合适的模型:
- 按难度分配。 简单、量大的任务,如分类和信息提取,交给速度快、价格低的模型;复杂的分析和写作,交给能力更强的模型。
- 按数据敏感度分配。 含有身份证号、银行账户、员工薪酬等敏感信息的请求,只交给本地或私有化部署的模型处理。
- 按可用性备份。 某个供应商服务中断或大幅调价时,可以把流量切换到备选模型,业务不至于停摆。
例如,一套客服系统可以让小模型处理“查物流”“改地址”这类常见问题,把投诉升级和退款争议交给能力更强的模型,并让含有客户证件信息的工单只在本地模型中处理。
要让路由真正可行,技术上需要做三件事:在业务系统和模型之间加一个统一的接入层,避免每个系统直接对接某一家厂商;尽量少用某一家独有的专属功能;把提示词、评测集和业务数据掌握在自己手里,换模型时才有据可依。
如何为企业选择合适的大模型?分步指南
选型的起点应该是业务任务,而不是模型名单。先想清楚要解决什么问题、能接受什么风险,再决定用什么模型、怎么用。
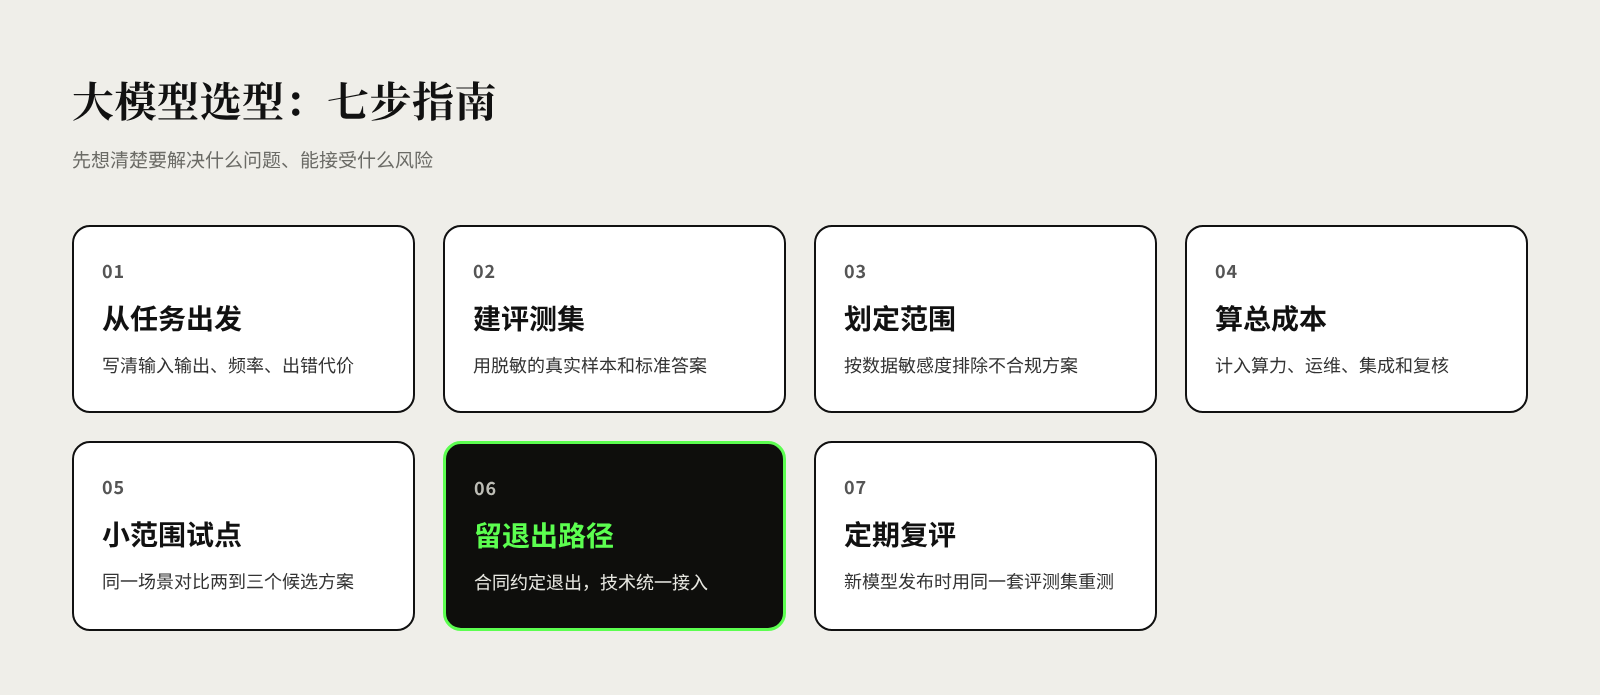
第 1 步:从任务出发,列出具体需求。 写清每个任务的输入、输出、处理频率、出错的代价和涉及数据的敏感程度。例如,“每天从供应商发票中提取金额和税号,出错会导致付款错误,数据含供应商银行账户”。
第 2 步:用真实业务数据建立评测集。 从实际业务中挑选一批有代表性的样本,做好脱敏,并写好标准答案。公开排行榜只能帮你缩小候选范围,最终要看候选模型在你自己评测集上的表现。
第 3 步:按数据敏感度划定可选范围。 先判断哪些数据可以发给外部 API、哪些涉及出境、哪些只能留在本地,再据此排除不符合要求的方案。合规不过关的方案,能力再强也不应进入候选名单。
第 4 步:计算总拥有成本,而不只是单价。 API 方案要估算调用量增长后的费用;自托管和本地部署要算上算力或硬件、电力、运维人员、安全和升级的成本。两类方案都还要计入系统集成、效果评估和人工复核的投入。由于模型价格下降很快,成本测算应定期更新。
第 5 步:小范围试点,对比两到三个候选方案。 在同一个业务场景中,用同一套评测集和真实流量对比不同方案的准确率、响应速度、成本和稳定性,并收集一线使用者的反馈。
第 6 步:提前留好退出路径。 合同中写明数据导出与删除、价格调整的提前通知、服务中断的责任;技术上通过统一接入层与具体模型解耦。这样,未来换模型只是一次切换,而不是一次重建。
第 7 步:定期复评。 建议定期,或在有重要新模型发布时,用同一套评测集重新测试,并结合成本变化决定是否调整模型组合。
关于大模型选型的常见问题
中小企业有必要本地部署大模型吗? 多数情况下没有必要从本地部署起步。本地部署前期投入大,还需要专门的技术人员维护。可以先选用数据条款清晰的付费 API 服务,只有在涉及高度敏感数据或有明确本地化要求时,再考虑私有化部署。
开放权重模型是免费的吗? 下载权重通常不收费,但运行模型需要算力、运维和人员投入,用量小的时候未必比 API 便宜。此外,各家许可证的条件不同,商用前应仔细阅读。
员工自己用免费版 AI 工具处理工作,有什么风险? 免费版和付费企业版的数据条款可能完全不同,免费版的内容可能被用于改进模型,甚至经过人工审核。企业应明确规定哪些资料可以输入外部 AI 工具,并为员工提供经过审核的正式工具。
模型更新这么快,现在选了会不会很快过时? 会有新模型出现,但这并不可怕。只要建立了自己的评测集和统一接入层,新模型出现时测一测、合适就换,选型就从一次性的赌注变成了可以持续优化的过程。
参考资料
- The 2025 AI Index Report,Stanford HAI,2025 年 4 月
- The 2026 AI Index Report: Technical Performance,Stanford HAI,2026 年 4 月
- Llama 4 Community License Agreement,Meta,2025 年 4 月
- Regulation (EU) 2016/679(General Data Protection Regulation),EUR-Lex,2016 年 4 月
- 促进和规范数据跨境流动规定,国家互联网信息办公室,2024 年 3 月
- Gemini API Additional Terms of Service,Google,2026 年 4 月更新
- Enterprise privacy: Our commitments,OpenAI,2026 年 11 月访问
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025,Andreessen Horowitz(a16z),2025 年 6 月


