Quando un'azienda decide di adottare un grande modello linguistico, la prima domanda non è quasi mai «per fare che cosa», ma «quale fornitore». Nuovi modelli escono praticamente ogni mese, le posizioni nelle classifiche cambiano di continuo e il «modello più potente» di oggi può essere superato nel giro di pochi mesi. Per un'azienda conta più scegliere il modo giusto di usarlo, governare il flusso dei dati e mantenere la possibilità di cambiare modello in qualsiasi momento, che stabilire quale sia il modello più potente.
Questo articolo illustra i tre modi principali in cui le aziende usano i grandi modelli e i rispettivi pro e contro, il divario reale tra modelli open-weight e modelli proprietari, i punti di attenzione sulla conformità dei dati e perché non conviene puntare su un solo modello; infine propone una guida alla scelta passo dopo passo e le risposte alle domande più frequenti.
In quali modi un'azienda può usare i grandi modelli?
Le aziende usano i grandi modelli in tre modi principali: chiamando l'API di un modello proprietario, usando un modello open-weight, oppure con un'installazione on-premise o privata. La differenza di fondo tra i tre non sta nel modello in sé, ma in «chi lo esegue, dove vanno i dati e chi risponde in caso di problemi».
Chiamare l'API di un modello proprietario. L'API (interfaccia di programmazione delle applicazioni) può essere intesa come uno «sportello remoto»: l'azienda invia domande e materiali al fornitore del modello, che esegue il modello sui propri server e restituisce il risultato. GPT, Claude, Gemini e altri offrono questo servizio, di norma con pagamento a consumo, e i parametri interni del modello (i «pesi») non sono pubblici.
Usare un modello open-weight. I pesi dei modelli open-weight possono essere scaricati: ne sono un esempio alcuni modelli delle famiglie Llama, Qwen, DeepSeek, Mistral. L'azienda può installarli su server cloud presi in affitto (self-hosting) oppure ricorrere ai servizi gestiti offerti da piattaforme terze. Va ricordato che «open-weight» non significa «senza vincoli»: le licenze sono molto diverse tra loro. Ad esempio, la licenza della community di Llama 4 di Meta prevede che chi supera i 700 milioni di utenti attivi mensili debba richiedere a Meta un'autorizzazione specifica, e richiede di indicare in modo visibile «Built with Llama» nei prodotti o nei siti interessati (fonte).
Installazione on-premise o privata. Il modello viene installato nel data center dell'azienda o in un ambiente dedicato, e i dati non escono dalla rete aziendale. In genere si usano modelli open-weight: è la soluzione che offre il massimo controllo, ma hardware, gestione operativa e responsabilità di sicurezza ricadono interamente sull'azienda.
La tabella seguente confronta le principali differenze tra i tre approcci:
| Voce di confronto | API di modello proprietario | Modello open-weight (self-hosting in cloud o servizio gestito di terzi) | Installazione on-premise / privata |
|---|---|---|---|
| Capacità | Di solito all'avanguardia, pronto all'uso | I modelli migliori sono vicini alla frontiera, ampia scelta | Limitata dall'hardware disponibile, spesso modelli di dimensioni medio-piccole |
| Rapidità di avvio | La più alta | Media | La più bassa: servono acquisto di hardware e allestimento dell'ambiente |
| Struttura dei costi | A consumo, investimento iniziale ridotto, la spesa cresce con l'uso | Servizio gestito a consumo, oppure potenza di calcolo in affitto; con volumi alti e stabili può costare meno | Forte investimento iniziale in hardware, più costi di energia, gestione e personale |
| Controllo dei dati | I dati sono inviati al fornitore, tutela affidata soprattutto al contratto | In self-hosting i dati restano nel proprio ambiente cloud; con servizio gestito dipende dalle condizioni del gestore | Il più elevato: i dati non escono dalla rete aziendale |
| Aspetti di conformità | Accordo sul trattamento dei dati, area di conservazione dei dati, eventuale trasferimento all'estero | Licenza del modello, condizioni del gestore | Facilita il rispetto dei requisiti di localizzazione, ma la responsabilità sulla sicurezza è tutta interna |
| Difficoltà di gestione | Bassa, a carico del fornitore | Da media ad alta | Alta, serve un team tecnico dedicato |
| Personalizzabilità | Dipende dalle funzioni rese disponibili dal fornitore | Alta, è possibile il fine-tuning | Alta, è possibile il fine-tuning |
I dati in tabella descrivono il caso generale: anche all'interno della stessa categoria le soluzioni dei diversi fornitori possono differire molto.
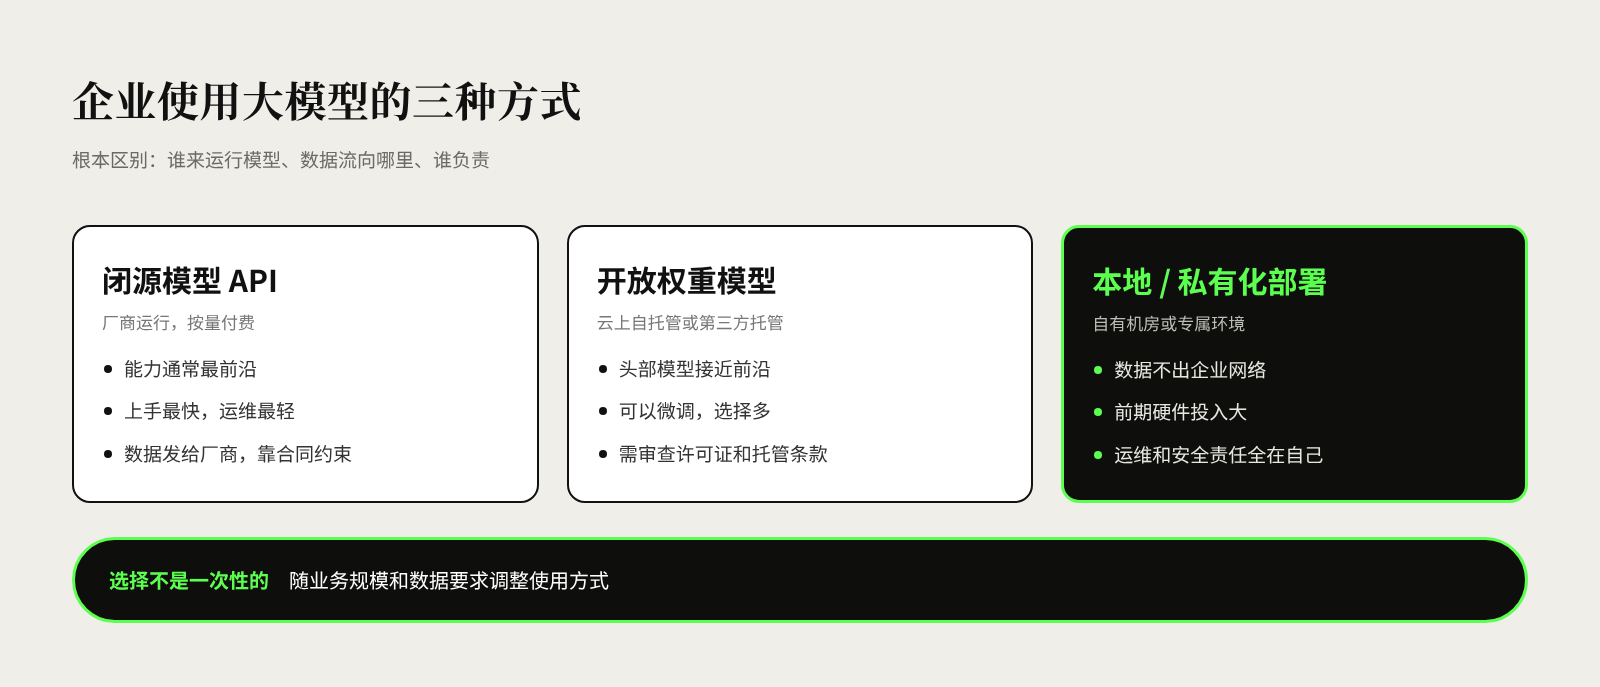
Pensiamo a un distributore che vuole estrarre automaticamente importi, partite IVA e scadenze dalle fatture dei fornitori. Nella fase pilota i volumi sono contenuti e chiamare direttamente un'API è la soluzione più semplice; quando si passa all'intero gruppo, con volumi elevati e stabili e requisiti severi sulla trasmissione dei dati all'esterno, un modello open-weight in self-hosting può risultare più vantaggioso per costi e conformità. Il modo di utilizzo non è una scelta definitiva: va adeguato alla scala del business e ai requisiti sui dati.
Quanto è grande il divario tra modelli open-weight e modelli proprietari?
Negli ultimi due anni i modelli open-weight sono migliorati molto. Il divario si è ridotto da una distanza generazionale evidente a poche percentuali, ma non è scomparso e oscilla nel tempo.
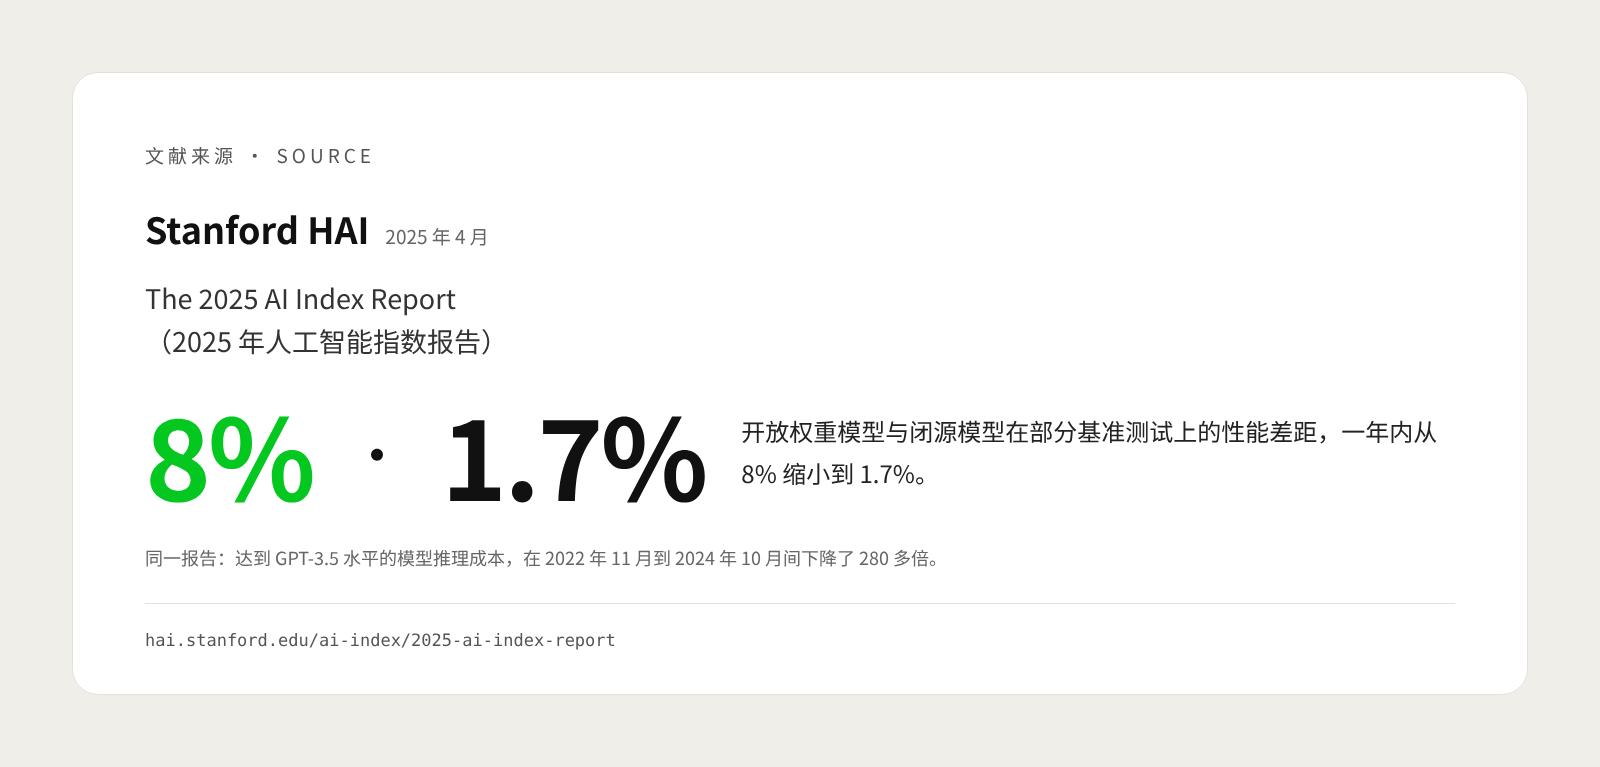
L'AI Index 2025 dello Stanford Institute for Human-Centered AI (Stanford HAI), pubblicato nell'aprile 2025, indica che in alcuni benchmark il divario di prestazioni tra modelli open-weight e modelli proprietari è sceso in un anno dall'8% all'1,7%; nello stesso tempo, il costo di inferenza per un modello di livello GPT-3.5 è calato di oltre 280 volte tra novembre 2022 e ottobre 2024 (fonte).
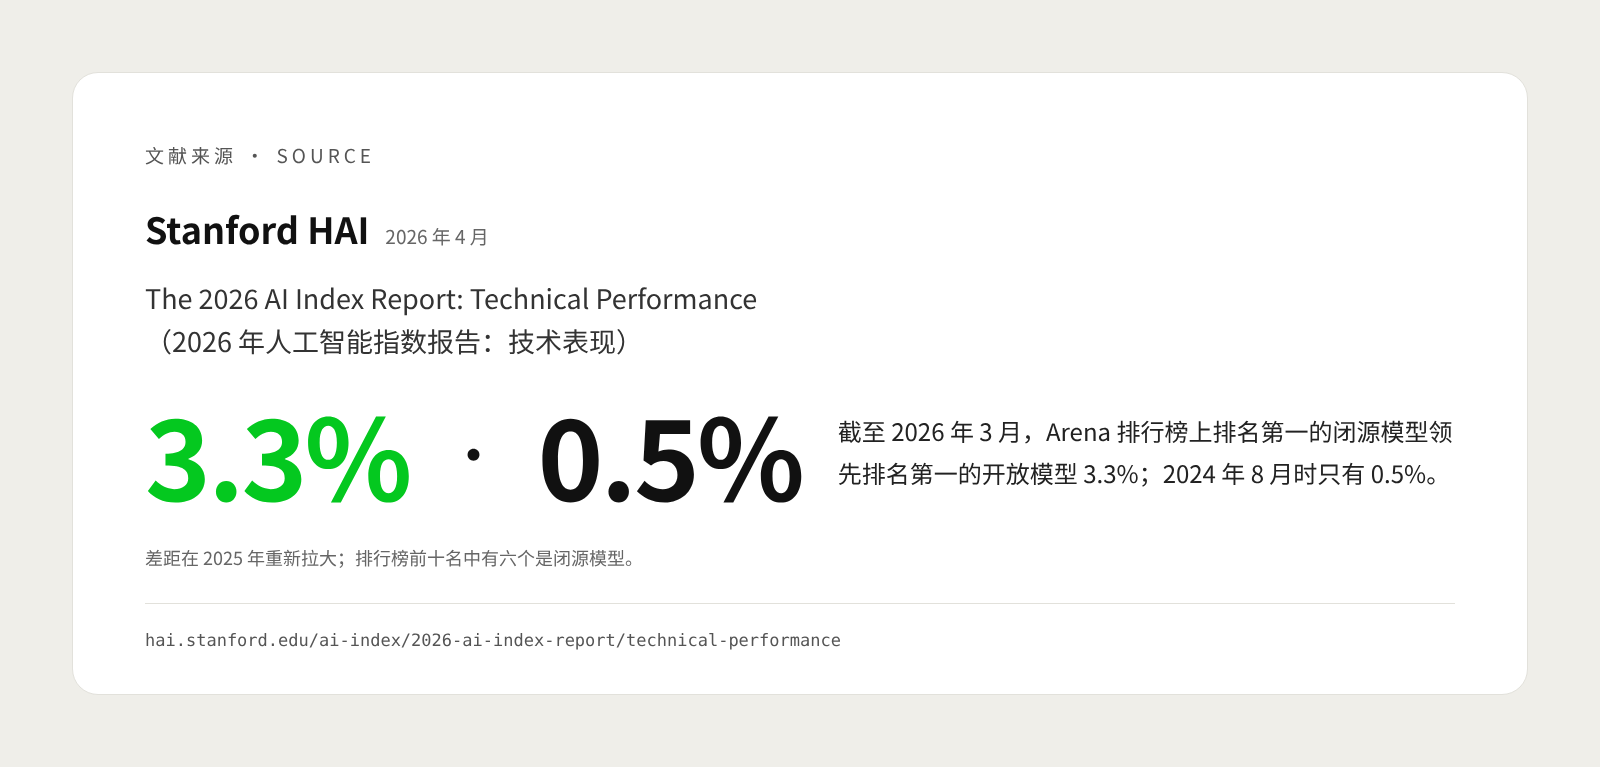
Tuttavia la nuova edizione del rapporto, pubblicata nell'aprile 2026, mostra che nel 2025 questo divario si è di nuovo allargato: a marzo 2026, nella classifica Arena, il miglior modello proprietario superava il miglior modello aperto del 3,3%, mentre ad agosto 2024 la distanza era solo dello 0,5%; sei dei primi dieci modelli in classifica erano proprietari. Il rapporto osserva anche che i modelli di diversi fornitori statunitensi e cinesi sono nel gruppo di testa con punteggi ravvicinati, e che la competizione si sta spostando su costi, stabilità e prestazioni in ambiti specifici (fonte).
Questi dati offrono tre indicazioni alle aziende:
- Non trattare le classifiche come conclusioni di lungo periodo. Lo stesso rapporto segnala che, dall'inizio del 2025, i modelli statunitensi e cinesi si sono superati a più riprese. Il primo di oggi non è detto che lo sia l'anno prossimo.
- I punteggi delle classifiche sono solo un riferimento. Il rapporto ricorda inoltre che i set di valutazione più usati presentano problemi di affidabilità: alcuni studi hanno rilevato che in certi set la quota di domande non valide arriva al 42% (fonte). Qualche punto percentuale in una classifica generale non è detto che si rifletta sul tuo caso d'uso.
- Molte attività non richiedono il modello più avanzato. Per compiti come la classificazione dei ticket, l'estrazione di informazioni dai documenti o il riassunto di documenti interni, una soluzione sufficientemente capace, più economica e con dati più sotto controllo è spesso più adatta di quella «più potente».
Prendiamo una catena di punti vendita che usa un modello per classificare automaticamente il feedback dei clienti in categorie come «qualità del prodotto», «atteggiamento del servizio», «prezzo». È un compito con regole chiare, per cui può bastare un modello open-weight di dimensioni medie; analizzare invece contratti complessi con i fornitori per l'ufficio acquisti può giustificare un modello più potente. Se un modello sia sufficiente lo si stabilisce misurandolo sui propri dati, non guardando la classifica.
Quali aspetti di conformità dei dati considerare nella scelta di un modello?
Nella scelta molte aziende confrontano solo capacità e prezzo, trascurando la destinazione dei dati. Quando si sceglie un modello, le clausole contrattuali e il flusso dei dati contano quanto le capacità del modello. Di seguito i tre livelli su cui arrivano più spesso le domande; per l'applicazione concreta resta necessario consultare un consulente legale in base alla situazione dell'azienda.
Regolamento generale sulla protezione dei dati dell'UE (GDPR). Se l'attività riguarda dati personali di persone nell'UE, vanno considerati in particolare due punti. Primo, l'articolo 28 del GDPR prevede che, quando si affida a terzi il trattamento di dati personali, si possano scegliere solo responsabili che presentino garanzie sufficienti, e che il rapporto di trattamento sia disciplinato da un contratto o da un altro atto giuridico vincolante. Secondo, il Capo V (dall'articolo 44) stabilisce che il trasferimento di dati personali verso paesi al di fuori dell'UE deve rispettare le condizioni di tale capo; in assenza di una «decisione di adeguatezza» occorre prevedere garanzie adeguate, ad esempio l'adozione di clausole tipo di protezione dei dati (fonte).
Le norme cinesi sul trasferimento dei dati all'estero. Se un'azienda raccoglie dati in Cina e i server del modello utilizzato si trovano all'estero, l'invio di dati al modello può costituire un trasferimento di dati all'estero. Le «Disposizioni per promuovere e regolamentare il flusso transfrontaliero dei dati» dell'Amministrazione del Cyberspazio della Cina (CAC), in vigore dal marzo 2024, distinguono diverse situazioni: i responsabili del trattamento dei dati diversi dagli operatori di infrastrutture critiche dell'informazione che, dal 1° gennaio dell'anno in corso, forniscono all'estero in modo cumulativo informazioni personali di meno di 100.000 persone (esclusi i dati personali sensibili) sono esentati dalla valutazione di sicurezza, dalla stipula del contratto tipo e dalla certificazione; per 100.000 persone o più e meno di 1 milione (o per dati personali sensibili relativi a meno di 10.000 persone) occorre stipulare il contratto tipo per l'esportazione di informazioni personali o ottenere la certificazione di protezione delle informazioni personali; per informazioni personali relative a 1 milione di persone o più, o dati personali sensibili relativi a 10.000 persone o più, e nei casi che coinvolgono dati importanti, occorre presentare la domanda di valutazione di sicurezza per l'esportazione dei dati (fonte). Ad esempio, inviare a un modello estero, per un'analisi, i dati di acquisto dei soci a livello nazionale richiede di valutare prima se si rientri in questi casi.
Condizioni di utilizzo dei dati del fornitore. Per lo stesso fornitore, versioni diverse possono avere condizioni completamente diverse. Prendiamo le condizioni di servizio aggiuntive dell'API Gemini di Google: con il servizio gratuito, Google usa i contenuti inviati e le risposte generate per migliorare i prodotti, revisori umani possono leggerli, e le condizioni avvertono espressamente di non inviare informazioni sensibili, riservate o personali; con il servizio a pagamento, Google non usa questi contenuti per migliorare i prodotti, i dati sono trattati secondo l'addendum sul trattamento dei dati e conservati per un periodo limitato solo per prevenire abusi e adempiere a obblighi di legge (fonte). Anche OpenAI dichiara, nella pagina sugli impegni per la privacy aziendale, di non usare i dati aziendali per addestrare i modelli (fonte). Ciò significa che se un dipendente usa un account gratuito personale per trattare materiali aziendali, possono valere regole sui dati completamente diverse da quelle del servizio ufficiale acquistato dall'azienda.
Prima di firmare, occorre almeno verificare con il fornitore i seguenti punti:
- in quale paese o area geografica i dati vengono conservati ed elaborati;
- se input e output possono essere usati per addestrare o migliorare il modello;
- per quanto tempo i dati vengono conservati e se è possibile chiederne la cancellazione;
- se è prevista una revisione umana e dove si trovano i revisori;
- se vengono usati altri sub-responsabili e se, in caso di modifiche, è previsto un preavviso.
Perché non puntare su un solo modello?
Legare tutta l'attività a un unico modello sembra semplice, ma in pratica affida costi, capacità e rischi a un unico fornitore. «Poter cambiare modello» va considerato un requisito fin dall'inizio, non un rimedio da trovare dopo che sono sorti i problemi.
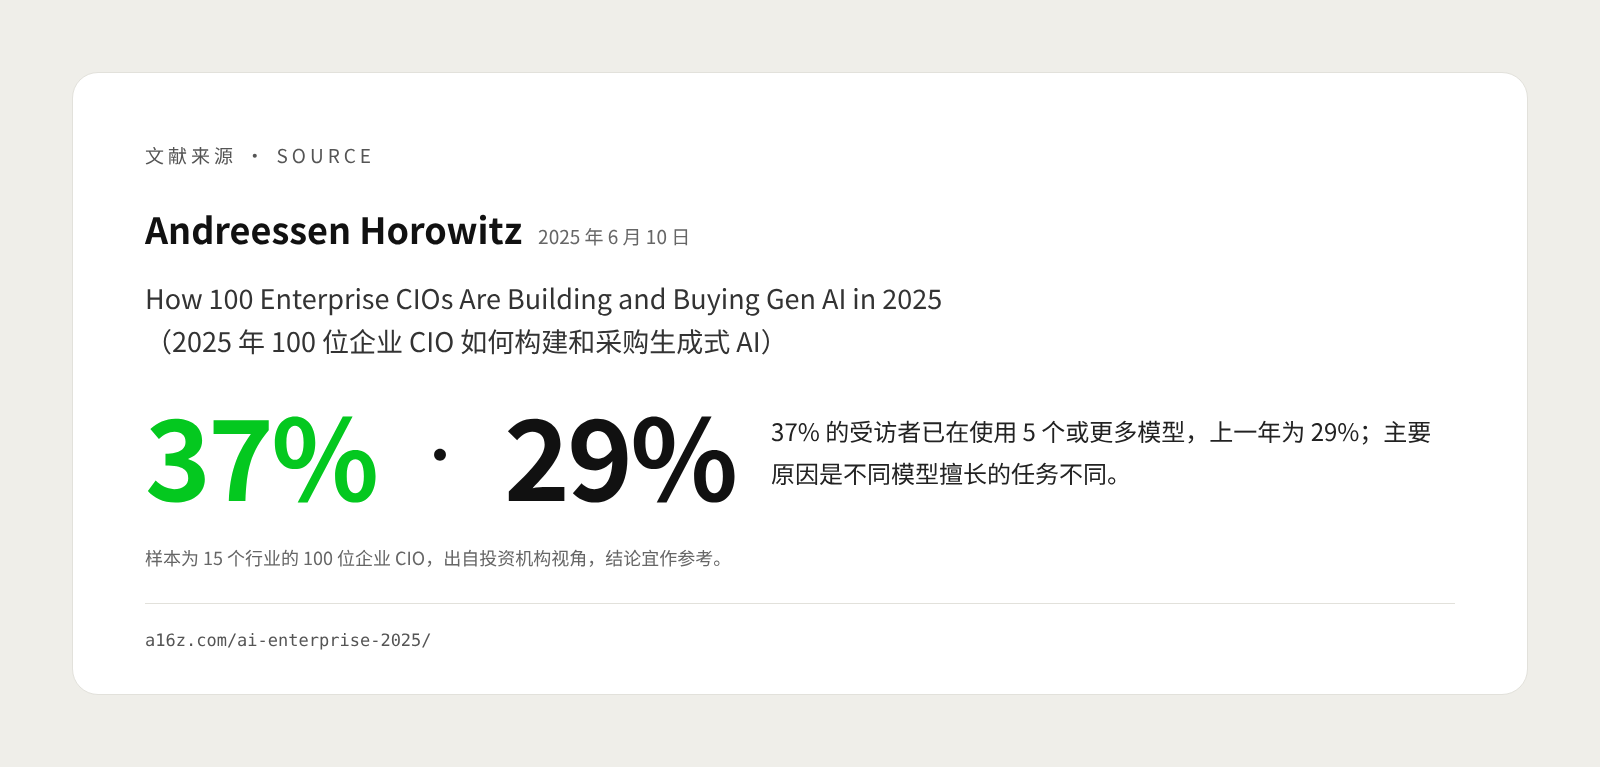
Anche la pratica delle aziende va in questa direzione. In un'indagine pubblicata a giugno 2025 dalla società di investimento a16z, che ha intervistato 100 CIO di aziende in 15 settori, il 37% degli intervistati usava già 5 o più modelli, contro il 29% dell'anno precedente; le aziende si rivolgono a più fornitori soprattutto perché modelli diversi eccellono in compiti diversi, ma anche per evitare il lock-in con un unico fornitore. L'indagine rileva però che il costo del cambio di modello sta aumentando: i team hanno già adattato prompt e guardrail a modelli specifici e, nei flussi agentici a più fasi, modificare un passaggio può incidere su più passaggi successivi (fonte). Il campione dell'indagine è di soli 100 intervistati e proviene da una società di investimento, quindi le conclusioni vanno considerate come un riferimento.
La pratica più comune con più modelli è il «routing», cioè assegnare automaticamente le richieste al modello più adatto in base alle caratteristiche del compito:
- Per difficoltà. Le attività semplici e ad alto volume, come classificazione ed estrazione di informazioni, vanno a modelli veloci ed economici; le analisi e la scrittura complesse a modelli più potenti.
- Per sensibilità dei dati. Le richieste che contengono numeri di documento d'identità, conti bancari, retribuzioni dei dipendenti e altre informazioni sensibili vengono affidate solo a modelli installati on-premise o in ambiente privato.
- Per disponibilità, come backup. Se un fornitore interrompe il servizio o alza i prezzi in modo significativo, il traffico può essere spostato su un modello alternativo, senza bloccare l'attività.
Ad esempio, un sistema di assistenza clienti può affidare a un modello piccolo le richieste comuni come «tracciare la spedizione» o «cambiare l'indirizzo», lasciare a un modello più potente l'escalation dei reclami e le controversie sui rimborsi, e far elaborare i ticket con dati dei documenti dei clienti solo dal modello locale.
Perché il routing sia davvero praticabile servono tre accorgimenti tecnici: inserire un livello di accesso unificato tra i sistemi aziendali e i modelli, evitando che ogni sistema si colleghi direttamente a un singolo fornitore; limitare il più possibile l'uso di funzioni proprietarie esclusive di un solo fornitore; tenere in mano propria prompt, set di valutazione e dati aziendali, così che il cambio di modello poggi su basi concrete.
Come scegliere il grande modello giusto per l'azienda? Guida passo dopo passo
Il punto di partenza della scelta devono essere le attività di business, non l'elenco dei modelli. Prima si chiarisce quale problema risolvere e quale rischio si è disposti ad accettare, poi si decide quale modello usare e come.
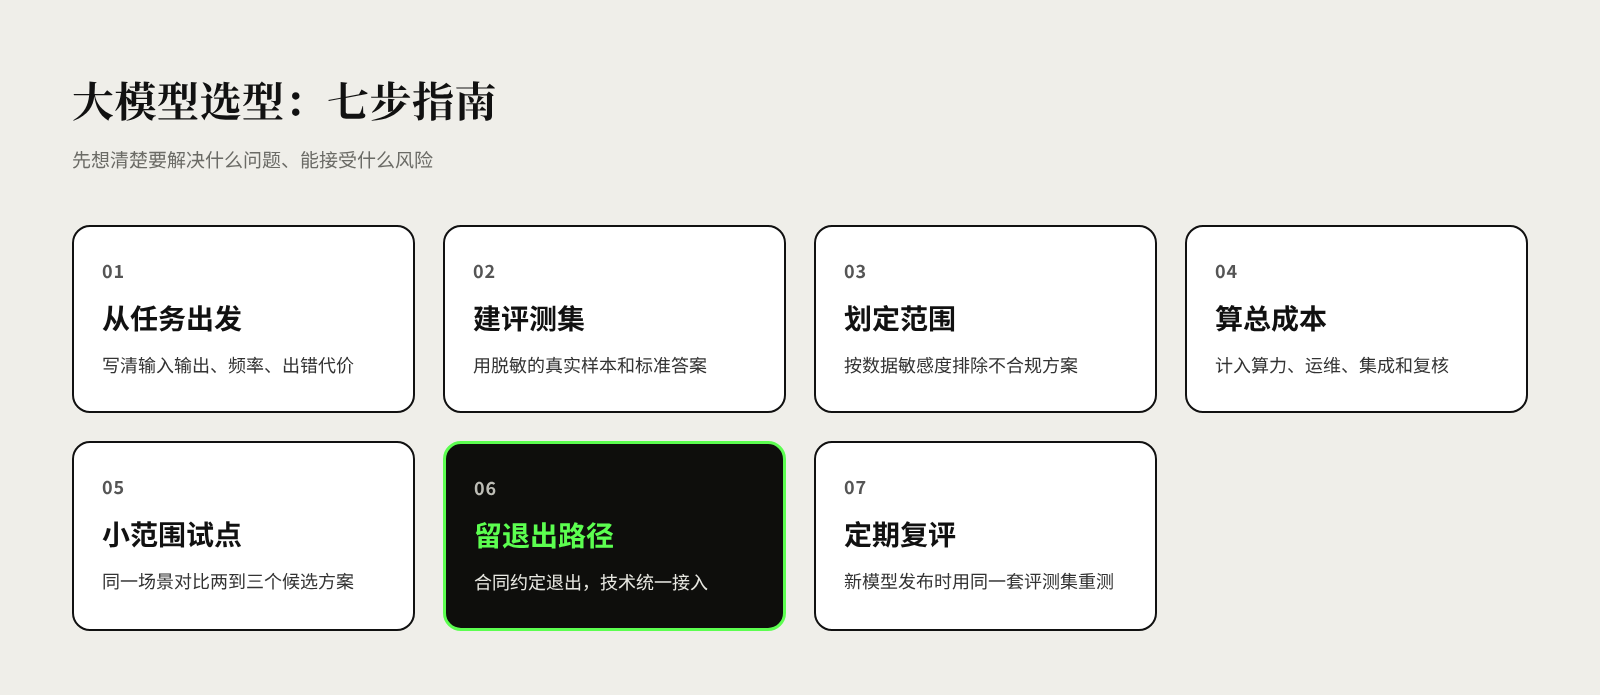
Passo 1: partire dai compiti ed elencare i requisiti concreti. Per ogni compito si descrivono input, output, frequenza di elaborazione, costo di un errore e sensibilità dei dati coinvolti. Ad esempio: «ogni giorno estrarre importi e partite IVA dalle fatture dei fornitori; un errore provoca pagamenti sbagliati; i dati contengono i conti bancari dei fornitori».
Passo 2: costruire un set di valutazione con dati aziendali reali. Si scelgono dall'attività reale campioni rappresentativi, li si anonimizza e si scrivono le risposte corrette. Le classifiche pubbliche servono solo a restringere la rosa dei candidati: ciò che conta è come si comportano i modelli candidati sul proprio set di valutazione.
Passo 3: delimitare le opzioni in base alla sensibilità dei dati. Si stabilisce per prima cosa quali dati possono essere inviati a un'API esterna, quali comportano un trasferimento all'estero e quali devono restare in locale, e su questa base si escludono le soluzioni non conformi ai requisiti. Una soluzione che non supera la verifica di conformità non deve entrare nella lista dei candidati, per quanto sia potente.
Passo 4: calcolare il costo totale di proprietà, non solo il prezzo unitario. Per le API si stima la spesa quando i volumi crescono; per self-hosting e on-premise si considerano potenza di calcolo o hardware, energia, personale di gestione, sicurezza e aggiornamenti. In entrambi i casi si aggiungono gli oneri di integrazione dei sistemi, valutazione dei risultati e revisione umana. Poiché i prezzi dei modelli scendono rapidamente, la stima dei costi va aggiornata periodicamente.
Passo 5: fare un pilota ristretto confrontando due o tre candidati. Nello stesso scenario di business, con lo stesso set di valutazione e traffico reale, si confrontano accuratezza, velocità di risposta, costi e stabilità delle diverse soluzioni, raccogliendo il feedback degli utenti in prima linea.
Passo 6: prevedere in anticipo una via d'uscita. Nel contratto si precisano esportazione e cancellazione dei dati, preavviso per le variazioni di prezzo e responsabilità in caso di interruzione del servizio; sul piano tecnico si rende il sistema indipendente dal singolo modello grazie al livello di accesso unificato. In questo modo, in futuro, cambiare modello sarà un semplice passaggio e non una ricostruzione.
Passo 7: rivalutare periodicamente. Si consiglia di ripetere i test con lo stesso set di valutazione a intervalli regolari, o quando esce un nuovo modello importante, e di decidere se modificare la combinazione di modelli tenendo conto anche della variazione dei costi.
Domande frequenti sulla scelta dei grandi modelli
Una PMI ha bisogno di un'installazione on-premise? Nella maggior parte dei casi non è necessario partire dall'on-premise. L'installazione locale richiede un forte investimento iniziale e personale tecnico dedicato alla manutenzione. Si può cominciare con un servizio API a pagamento dalle condizioni sui dati chiare, e valutare l'installazione privata solo in presenza di dati altamente sensibili o di requisiti espliciti di localizzazione.
I modelli open-weight sono gratuiti? Scaricare i pesi di solito non costa nulla, ma eseguire il modello richiede potenza di calcolo, gestione e personale, e con volumi ridotti può non costare meno di un'API. Inoltre le condizioni delle licenze variano: vanno lette con attenzione prima dell'uso commerciale.
Quali rischi comporta l'uso di strumenti di IA gratuiti da parte dei dipendenti per il lavoro? Le condizioni sui dati delle versioni gratuite e di quelle aziendali a pagamento possono essere completamente diverse: i contenuti della versione gratuita possono essere usati per migliorare il modello e persino sottoposti a revisione umana. L'azienda dovrebbe stabilire con chiarezza quali materiali si possono inserire in strumenti di IA esterni e mettere a disposizione dei dipendenti strumenti ufficiali e verificati.
I modelli si aggiornano così in fretta: la scelta di oggi non diventerà presto obsoleta? Nuovi modelli arriveranno, ma non è un problema. Se si dispone di un proprio set di valutazione e di un livello di accesso unificato, quando esce un nuovo modello basta testarlo e, se è adatto, sostituirlo: la scelta smette di essere una scommessa una tantum e diventa un processo di miglioramento continuo.
Riferimenti
- The 2025 AI Index Report, Stanford HAI, aprile 2025
- The 2026 AI Index Report: Technical Performance, Stanford HAI, aprile 2026
- Llama 4 Community License Agreement, Meta, aprile 2025
- Regulation (EU) 2016/679 (General Data Protection Regulation), EUR-Lex, aprile 2016
- 促进和规范数据跨境流动规定 (Disposizioni per promuovere e regolamentare il flusso transfrontaliero dei dati), Amministrazione del Cyberspazio della Cina (CAC), marzo 2024
- Gemini API Additional Terms of Service, Google, aggiornato ad aprile 2026
- Enterprise privacy: Our commitments, OpenAI, consultato a novembre 2026
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025, Andreessen Horowitz (a16z), giugno 2025


