Cuando una empresa decide incorporar modelos de lenguaje, la primera pregunta que surge casi nunca es «para qué» sino «de qué proveedor». Se lanzan modelos nuevos casi cada mes, los puestos de las clasificaciones cambian sin parar, y el «mejor modelo» de hoy puede quedar superado en unos meses. Para una empresa, más importante que «qué modelo es el mejor» es elegir bien la forma de uso, controlar el recorrido de los datos y conservar la capacidad de cambiar de modelo en cualquier momento.
Este artículo explica las tres formas principales en que las empresas usan modelos de lenguaje y sus pros y contras, la diferencia real entre los modelos de pesos abiertos y los de código cerrado, los puntos de cumplimiento de datos que conviene tener presentes y por qué no se debe apostar por un solo modelo, y termina con una guía de selección paso a paso y unas preguntas frecuentes.
¿De qué formas puede una empresa usar modelos de lenguaje?
Hay tres formas principales: llamar a la API de un modelo de código cerrado, usar un modelo de pesos abiertos o desplegar el modelo en local o en un entorno privado. La diferencia de fondo entre ellas no está en el modelo, sino en «quién ejecuta el modelo, adónde van los datos y quién responde si algo sale mal».
Llamar a la API de un modelo de código cerrado. Una API (interfaz de programación de aplicaciones) puede entenderse como una «ventanilla remota»: la empresa envía su pregunta y su documentación al proveedor del modelo, este ejecuta el modelo en sus propios servidores y devuelve el resultado. GPT, Claude, Gemini y otros ofrecen este servicio, normalmente con pago por volumen de uso, y los parámetros internos del modelo (sus «pesos») no se hacen públicos.
Usar un modelo de pesos abiertos. Los pesos de un modelo de pesos abiertos (open-weight) pueden descargarse; es el caso de algunos modelos de familias como Llama, Qwen, DeepSeek o Mistral. La empresa puede desplegarlo en servidores en la nube que alquile (autoalojamiento) o recurrir a un servicio alojado que ofrezca una plataforma de terceros. Conviene tener en cuenta que «pesos abiertos» no significa «sin restricciones»: las licencias varían mucho. Por ejemplo, la licencia comunitaria de Llama 4, de Meta, establece que quien tenga más de 700 millones de usuarios activos mensuales debe solicitar una licencia aparte a Meta, y exige mostrar de forma destacada «Built with Llama» en los productos o sitios web correspondientes (fuente).
Despliegue local o privado. Consiste en desplegar el modelo en el centro de datos propio de la empresa o en un entorno dedicado, de modo que los datos no salgan de su red. Suele hacerse con modelos de pesos abiertos y es la opción que ofrece mayor control, pero el hardware, la operación y la seguridad corren por completo a cargo de la empresa.
La tabla siguiente compara las principales diferencias entre las tres formas:
| Aspecto | API de modelo de código cerrado | Modelo de pesos abiertos (autoalojado en la nube o alojado por terceros) | Despliegue local / privado |
|---|---|---|---|
| Capacidad | Suele estar a la vanguardia y funciona desde el primer momento | Los mejores modelos se acercan a la vanguardia y hay mucho donde elegir | Limitada por el hardware propio; se suelen usar modelos de tamaño pequeño o medio |
| Rapidez de puesta en marcha | La mayor | Media | La menor: hay que adquirir hardware y montar el entorno |
| Estructura de costes | Pago por uso, poca inversión inicial; a más uso, más gasto | Pago por uso si es alojado, o capacidad de cálculo alquilada; con un uso elevado y estable puede salir más barato | Gran inversión inicial en hardware, más costes de electricidad, operación y personal |
| Control de los datos | Los datos se envían al proveedor; se garantizan sobre todo por contrato | En autoalojamiento, los datos permanecen en el entorno en la nube propio; en el alojado, depende de las condiciones del proveedor | El máximo: los datos no salen de la red de la empresa |
| Puntos clave de cumplimiento | Acuerdo de tratamiento de datos, región de almacenamiento, si hay transferencia al extranjero | Licencia del modelo, condiciones del proveedor de alojamiento | Facilita cumplir requisitos de localización, pero toda la responsabilidad de seguridad es propia |
| Dificultad de operación | Baja, a cargo del proveedor | Media a alta | Alta, requiere un equipo técnico especializado |
| Personalización | Depende de las funciones que abra el proveedor | Alta, se puede ajustar (fine-tuning) | Alta, se puede ajustar (fine-tuning) |
La tabla refleja el caso general; dentro de un mismo tipo de solución también puede haber grandes diferencias entre proveedores.
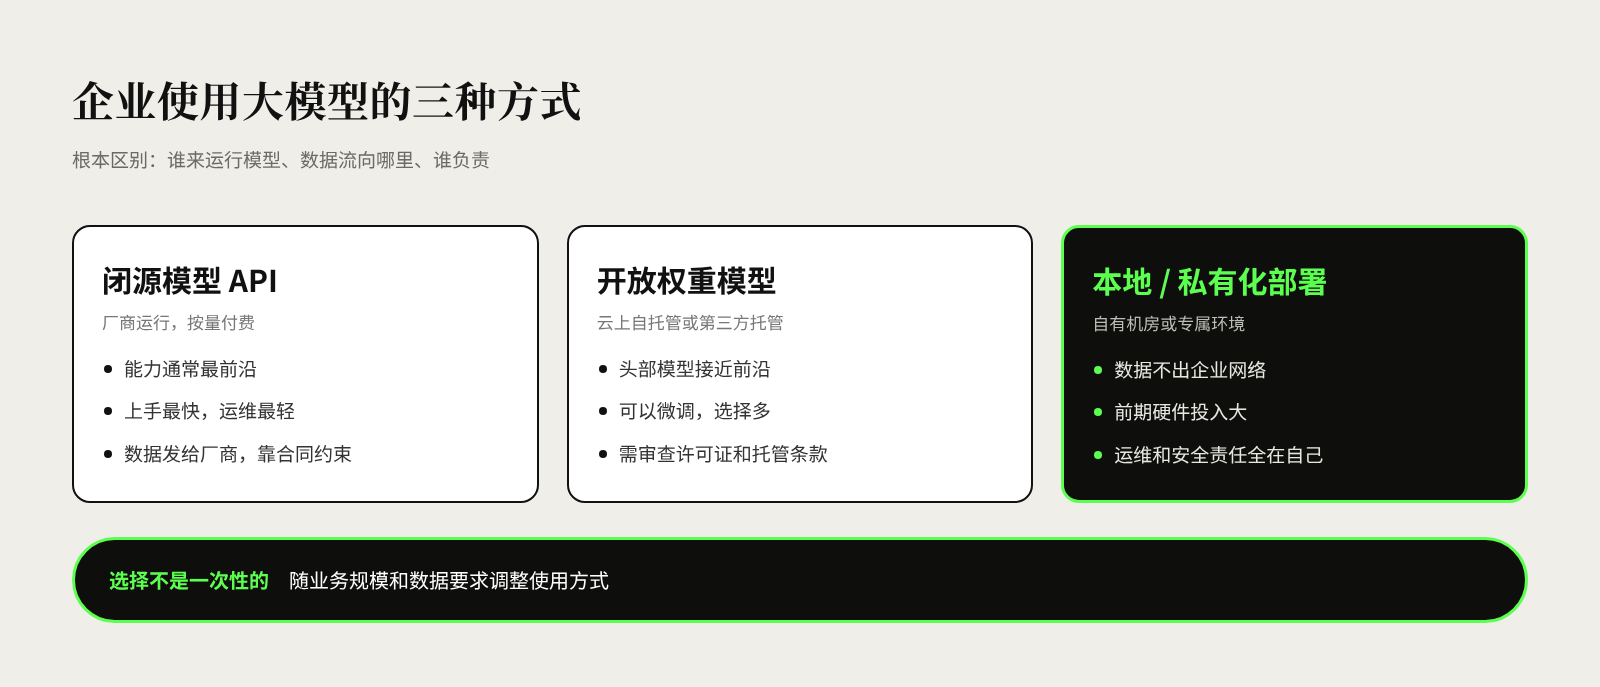
Por ejemplo, una distribuidora quiere extraer con IA, de forma automática, importes, números de identificación fiscal y fechas de vencimiento de las facturas de proveedores. En la fase piloto, con pocas facturas, lo más cómodo es llamar a una API; cuando se extienda a todo el grupo, con un volumen de llamadas alto y estable y requisitos estrictos sobre la salida de datos, autoalojar un modelo de pesos abiertos puede resultar más ventajoso en coste y cumplimiento. La forma de uso no es una elección única y definitiva, sino que debe ajustarse al tamaño del negocio y a los requisitos sobre los datos.
¿Qué distancia hay entre los modelos de pesos abiertos y los de código cerrado?
En los dos últimos años, los modelos de pesos abiertos han avanzado muy deprisa. La diferencia entre ambos ha pasado de ser una brecha generacional evidente a unos pocos puntos porcentuales, pero no ha desaparecido y fluctúa.
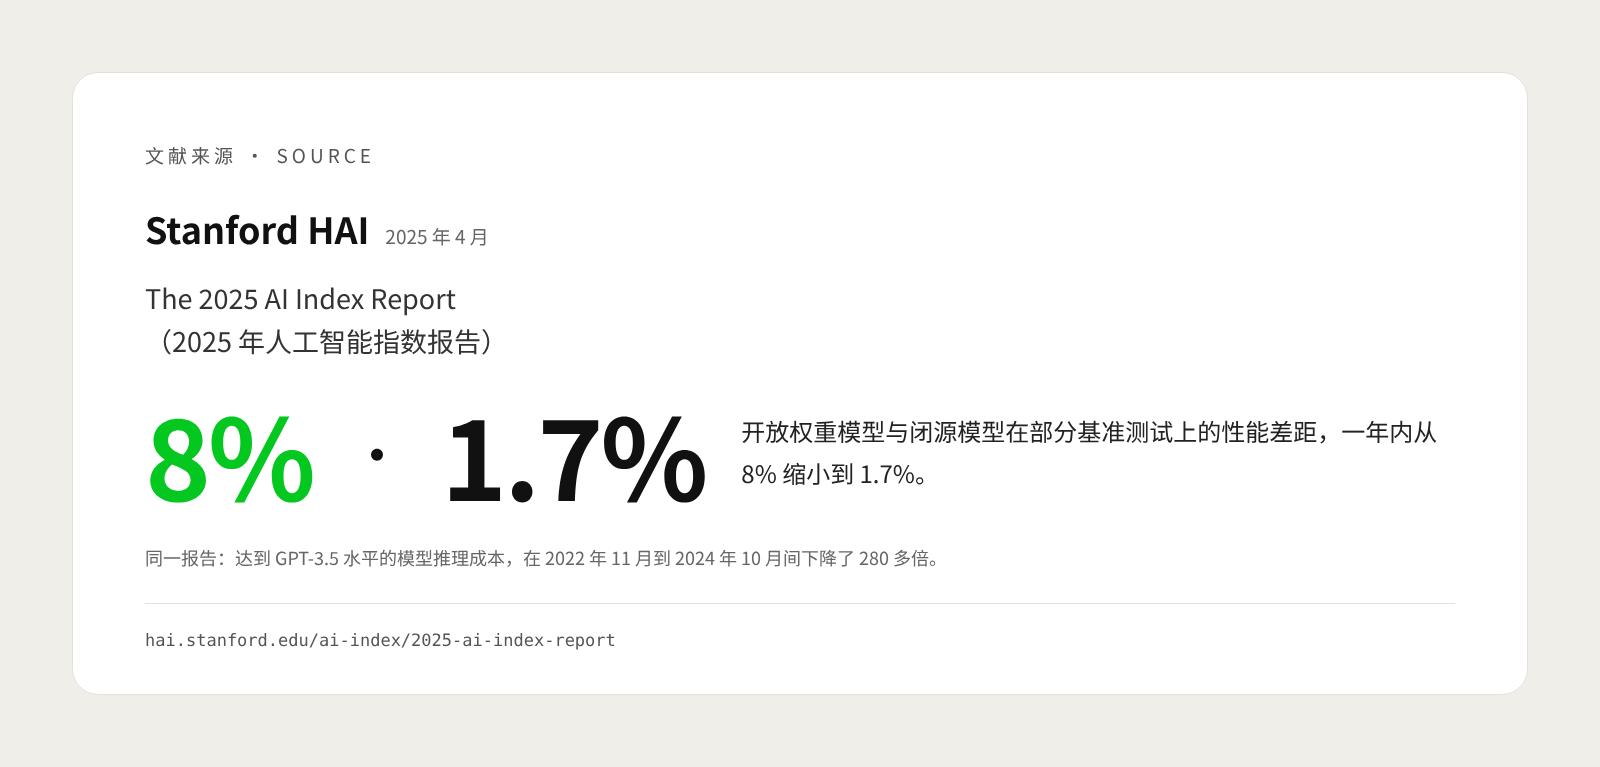
El informe «AI Index 2025», publicado en abril de 2025 por el Instituto de Inteligencia Artificial Centrada en el Ser Humano de la Universidad de Stanford (Stanford HAI), señala que la diferencia de rendimiento entre modelos de pesos abiertos y de código cerrado en algunas pruebas de referencia se redujo en un año del 8 % al 1,7 %; además, el coste de inferencia de un modelo con nivel de GPT-3.5 cayó más de 280 veces entre noviembre de 2022 y octubre de 2024 (fuente).
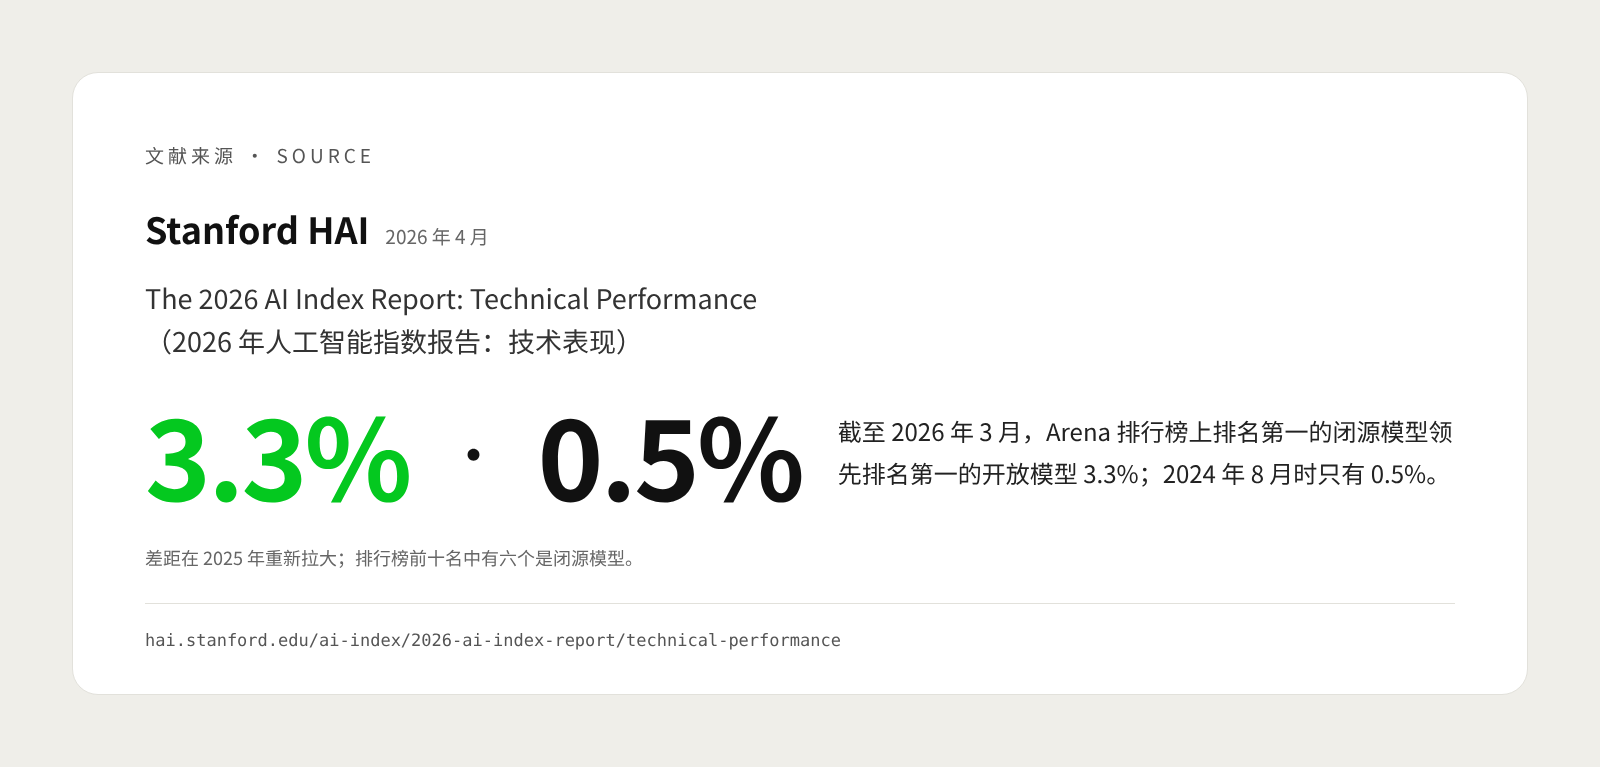
Sin embargo, la nueva edición del informe, publicada en abril de 2026, muestra que esa diferencia volvió a ampliarse en 2025: a marzo de 2026, en la clasificación de Arena, el mejor modelo de código cerrado superaba en un 3,3 % al mejor modelo abierto, cuando en agosto de 2024 la diferencia era solo del 0,5 %; y seis de los diez primeros puestos de la clasificación eran de modelos de código cerrado. El informe también señala que modelos de varios proveedores de Estados Unidos y de China están en el primer nivel, con puntuaciones muy próximas, y que el centro de la competencia se está desplazando hacia el coste, la estabilidad y el rendimiento en ámbitos concretos (fuente).
Estos datos dejan tres enseñanzas para las empresas:
- No tomes la clasificación como una conclusión a largo plazo. El mismo informe menciona que, desde principios de 2025, los modelos de Estados Unidos y de China se han ido alternando varias veces en cabeza. El primero de hoy no tiene por qué serlo el año que viene.
- Las puntuaciones de las clasificaciones solo sirven de referencia. El informe advierte además de que los conjuntos de evaluación habituales tienen problemas de fiabilidad: algunos estudios han encontrado que la proporción de preguntas no válidas en ciertos conjuntos llega al 42 % (fuente). Unos pocos puntos porcentuales en una clasificación general no se traducen necesariamente en tu negocio concreto.
- Muchas tareas no necesitan el modelo más puntero. Para tareas como clasificar tickets, extraer datos de documentos o resumir documentos internos, una solución con capacidad suficiente, menor coste y mejor control de los datos suele ser más adecuada que la «más potente».
Por ejemplo, una cadena de comercios usa un modelo para clasificar automáticamente los comentarios de los clientes de sus tiendas en categorías como «calidad del producto», «trato» o «precio». Es una tarea con reglas claras, y un modelo de pesos abiertos de tamaño medio puede bastar; en cambio, para analizar contratos complejos con proveedores para el departamento de compras, puede merecer la pena un modelo más capaz. Si es suficiente o no, hay que medirlo con tus propios datos, no mirando una clasificación.
Al elegir un modelo de lenguaje, ¿qué hay que tener en cuenta sobre el cumplimiento de datos?
Muchas empresas, al elegir, solo comparan capacidad y precio, y pasan por alto el destino de los datos. Al elegir un modelo, las cláusulas del contrato y el recorrido de los datos importan tanto como la capacidad del modelo. Los tres niveles siguientes son los que más se consultan; su aplicación concreta debe consultarse con un asesor jurídico según el caso de cada empresa.
Reglamento General de Protección de Datos (RGPD) de la UE. Si el negocio implica datos personales de la UE, hay que prestar especial atención a dos puntos. Primero, el artículo 28 del RGPD establece que, cuando se encomienda a un tercero el tratamiento de datos personales, solo puede elegirse a un encargado que ofrezca garantías suficientes, y que la relación de tratamiento entre las partes debe regirse por un contrato u otro acto jurídico vinculante. Segundo, el capítulo V (a partir del artículo 44) dispone que la transferencia de datos personales fuera de la UE debe cumplir las condiciones de ese capítulo; a falta de una «decisión de adecuación», deben ofrecerse garantías apropiadas, por ejemplo mediante cláusulas tipo de protección de datos (fuente).
Normas de China sobre la salida de datos. Si la empresa recopila datos dentro de China y los servidores del modelo que utiliza están en el extranjero, enviar datos al modelo puede constituir una transferencia de datos al exterior. El Reglamento para Promover y Regular los Flujos Transfronterizos de Datos (促进和规范数据跨境流动规定), de la Administración del Ciberespacio de China, en vigor desde marzo de 2024, distingue varios supuestos: los responsables del tratamiento de datos que no sean operadores de infraestructuras críticas de información y que, acumulados desde el 1 de enero del año en curso, proporcionen al extranjero datos personales de menos de 100.000 personas (sin contar los datos personales sensibles) quedan exentos de presentar una evaluación de seguridad, de suscribir un contrato tipo o de obtener una certificación; los que superen las 100.000 personas y no lleguen a 1 millón (o los datos personales sensibles de menos de 10.000 personas) deben suscribir un contrato tipo de salida de información personal u obtener la certificación de protección de información personal; y los que alcancen 1 millón de personas o más, o datos personales sensibles de 10.000 personas o más, así como los que afecten a datos importantes, deben presentar una evaluación de seguridad de la salida de datos (fuente). Por ejemplo, enviar a un modelo extranjero, para su análisis, los registros de compra de los socios de todo el país exige evaluar antes si se encuadra en alguno de estos supuestos.
Condiciones de uso de datos del proveedor. Un mismo proveedor puede tener condiciones totalmente distintas según la versión. Tomemos como ejemplo las condiciones adicionales de servicio de la API de Gemini de Google: con el servicio gratuito, Google usa los contenidos enviados y las respuestas generadas para mejorar sus productos, revisores humanos pueden leerlos, y las condiciones advierten expresamente de que no se envíe información sensible, confidencial o personal; con el servicio de pago, Google no usa esos contenidos para mejorar sus productos, los datos se tratan conforme al anexo de tratamiento de datos y solo se conservan durante un tiempo limitado para prevenir abusos y cumplir requisitos legales (fuente). OpenAI también declara, en su página de compromisos de privacidad empresarial, que no usa los datos de negocio de las empresas para entrenar sus modelos (fuente). Esto significa que un empleado que procesa documentos de la empresa con una cuenta gratuita personal puede estar sujeto a reglas de datos completamente distintas de las del servicio oficial contratado por la empresa.
Antes de firmar, conviene confirmar con el proveedor, como mínimo, lo siguiente:
- en qué país o región se almacenan y tratan los datos;
- si las entradas y salidas se usarán para entrenar o mejorar el modelo;
- cuánto tiempo se conservan los datos y si se puede solicitar su eliminación;
- si habrá revisión humana y dónde se encuentran los revisores;
- si se recurre a otros subencargados del tratamiento y si se avisará con antelación de los cambios.
¿Por qué no hay que apostar por un solo modelo?
Atar todo el negocio a un único modelo parece sencillo, pero en realidad entrega a un solo proveedor el coste, la capacidad y el riesgo. Hay que considerar la posibilidad de cambiar de modelo como un requisito desde el principio, no como un remedio que se aplica cuando surge el problema.
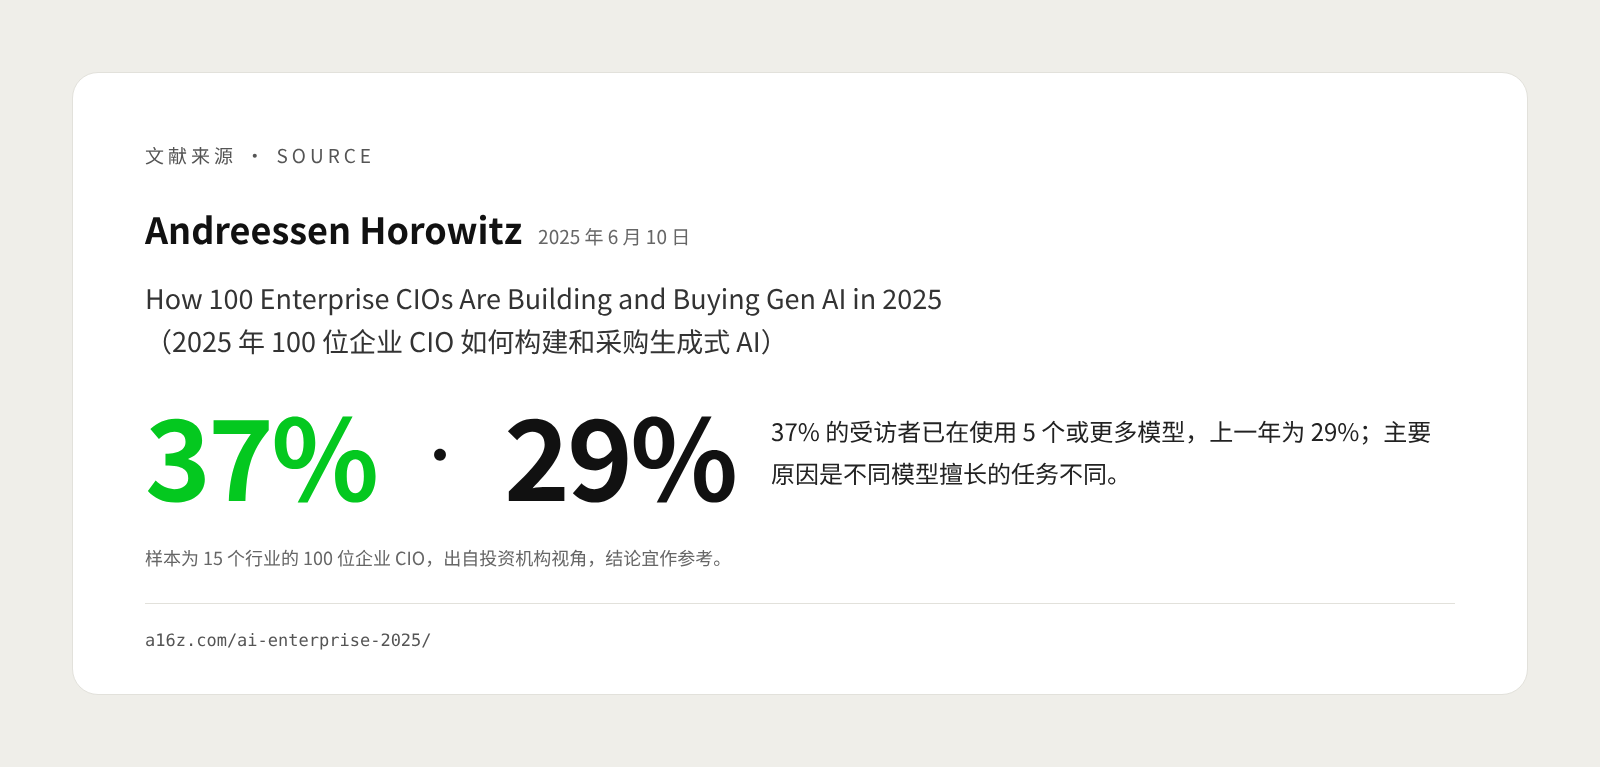
La práctica real de las empresas va en esa dirección. En una encuesta publicada en junio de 2025 por la firma de inversión a16z, que entrevistó a 100 CIO de empresas de 15 sectores, el 37 % de los encuestados ya usaba 5 o más modelos, frente al 29 % del año anterior; las empresas adquieren modelos de varios proveedores sobre todo porque cada modelo destaca en tareas distintas, y también para evitar quedar atadas a un único proveedor. Pero la encuesta también halló que el coste de cambiar de modelo va en aumento: los equipos ya han ajustado los prompts y las reglas de protección a un modelo concreto, y en los flujos de agentes de varios pasos, cambiar un eslabón puede afectar a varios de los siguientes (fuente). La muestra de esta encuesta es de solo 100 personas y procede de la óptica de una firma de inversión, por lo que sus conclusiones deben tomarse como referencia.
La práctica habitual con varios modelos es el «enrutamiento» (routing): asignar automáticamente cada petición al modelo más adecuado según las características de la tarea:
- Asignar por dificultad. Las tareas sencillas y de gran volumen, como la clasificación y la extracción de datos, se dejan a modelos rápidos y baratos; los análisis y la redacción complejos, a modelos más capaces.
- Asignar por sensibilidad de los datos. Las peticiones que contienen información sensible, como números de documento de identidad, cuentas bancarias o salarios de empleados, solo se entregan a modelos desplegados en local o en un entorno privado.
- Respaldo por disponibilidad. Si un proveedor sufre una interrupción del servicio o sube los precios de forma drástica, el tráfico puede desviarse a un modelo alternativo y la actividad no se detiene.
Por ejemplo, un sistema de atención al cliente puede dejar que un modelo pequeño resuelva consultas frecuentes como «seguimiento de envíos» o «cambio de dirección», derivar a un modelo más capaz las escaladas de reclamaciones y las disputas de reembolso, y hacer que los tickets con datos de documentos de identidad de clientes se traten únicamente con el modelo local.
Para que el enrutamiento sea viable hay que hacer tres cosas desde el punto de vista técnico: añadir una capa de acceso unificada entre los sistemas de negocio y los modelos, de modo que cada sistema no se conecte directamente a un único proveedor; usar lo mínimo posible las funciones propietarias exclusivas de un proveedor; y mantener en tus manos los prompts, los conjuntos de evaluación y los datos de negocio, para tener una base sobre la que decidir cuando cambies de modelo.
¿Cómo elegir el modelo de lenguaje adecuado para la empresa? Guía paso a paso
El punto de partida de la selección debe ser la tarea de negocio, no la lista de modelos. Primero, tener claro qué problema se quiere resolver y qué riesgo se puede aceptar; después, decidir qué modelo usar y cómo.
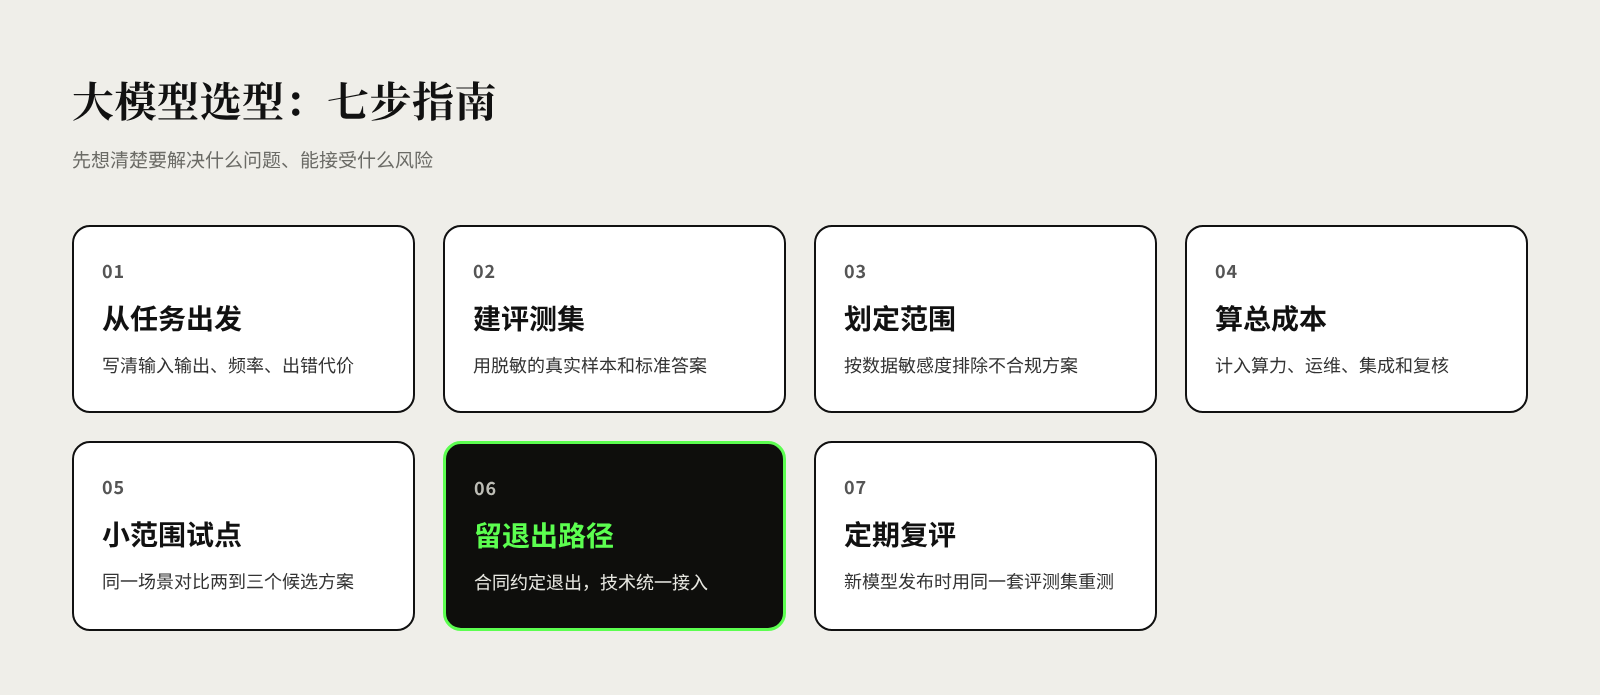
Paso 1: partir de la tarea y enumerar las necesidades concretas. Anota para cada tarea las entradas, las salidas, la frecuencia de procesamiento, el coste de un error y la sensibilidad de los datos implicados. Por ejemplo: «extraer cada día los importes y los números de identificación fiscal de las facturas de proveedores; un error provocaría pagos incorrectos y los datos incluyen cuentas bancarias de proveedores».
Paso 2: crear un conjunto de evaluación con datos reales de negocio. Selecciona del negocio real un conjunto de muestras representativas, anonimízalas y redacta las respuestas correctas. Las clasificaciones públicas solo sirven para acotar la lista de candidatos; al final lo que cuenta es el rendimiento de los modelos candidatos en tu propio conjunto de evaluación.
Paso 3: delimitar las opciones según la sensibilidad de los datos. Determina primero qué datos pueden enviarse a una API externa, cuáles implican salida al extranjero y cuáles solo pueden permanecer en local, y descarta en consecuencia las soluciones que no cumplan los requisitos. Una solución que no supera el cumplimiento, por muy capaz que sea, no debe entrar en la lista de candidatas.
Paso 4: calcular el coste total de propiedad, no solo el precio unitario. En las soluciones con API, estima el gasto cuando crezca el volumen de llamadas; en el autoalojamiento y el despliegue local, suma capacidad de cálculo o hardware, electricidad, personal de operación, seguridad y actualizaciones. En ambos casos hay que incluir también la inversión en integración de sistemas, evaluación de resultados y revisión humana. Como los precios de los modelos bajan muy rápido, la estimación de costes debe actualizarse con regularidad.
Paso 5: piloto a pequeña escala, comparando dos o tres candidatos. En un mismo escenario de negocio, compara la precisión, la velocidad de respuesta, el coste y la estabilidad de las distintas soluciones con el mismo conjunto de evaluación y con tráfico real, y recoge las opiniones de los usuarios de primera línea.
Paso 6: dejar preparada la vía de salida. En el contrato, especifica la exportación y eliminación de datos, el preaviso de cambios de precio y la responsabilidad en caso de interrupción del servicio; en lo técnico, desacopla la solución de cada modelo concreto mediante la capa de acceso unificada. Así, cambiar de modelo en el futuro será un simple cambio y no una reconstrucción.
Paso 7: reevaluar periódicamente. Se recomienda volver a probar con el mismo conjunto de evaluación de forma periódica, o cuando se publique un modelo nuevo importante, y decidir, teniendo en cuenta la evolución de los costes, si hay que ajustar la combinación de modelos.
Preguntas frecuentes sobre la elección de modelos de lenguaje
¿Es necesario que una pyme despliegue modelos de lenguaje en local? En la mayoría de los casos no hace falta empezar por el despliegue local. Exige una gran inversión inicial y personal técnico especializado para mantenerlo. Puedes empezar eligiendo un servicio de API de pago con condiciones de datos claras, y considerar el despliegue privado solo cuando se manejen datos de alta sensibilidad o haya requisitos de localización claros.
¿Los modelos de pesos abiertos son gratuitos? Descargar los pesos no suele costar nada, pero ejecutar el modelo requiere capacidad de cálculo, operación y personal, y con poco uso no tiene por qué salir más barato que una API. Además, las condiciones de las licencias varían de un modelo a otro, y conviene leerlas con atención antes de un uso comercial.
¿Qué riesgos tiene que los empleados usen herramientas de IA gratuitas para el trabajo? Las condiciones de datos de la versión gratuita y de la versión de pago para empresas pueden ser completamente distintas: los contenidos de la versión gratuita pueden usarse para mejorar el modelo e incluso pasar por revisión humana. La empresa debe establecer con claridad qué documentación puede introducirse en herramientas de IA externas y ofrecer a los empleados herramientas oficiales ya revisadas.
Los modelos se actualizan tan deprisa: ¿lo que elija ahora no quedará obsoleto enseguida? Aparecerán modelos nuevos, pero eso no es motivo de alarma. Si has creado tu propio conjunto de evaluación y una capa de acceso unificada, cuando salga un modelo nuevo basta probarlo y, si encaja, cambiar: la selección deja de ser una apuesta única y se convierte en un proceso de mejora continua.
Referencias
- The 2025 AI Index Report, Stanford HAI, abril de 2025
- The 2026 AI Index Report: Technical Performance, Stanford HAI, abril de 2026
- Llama 4 Community License Agreement, Meta, abril de 2025
- Regulation (EU) 2016/679(General Data Protection Regulation), EUR-Lex, abril de 2016
- 促进和规范数据跨境流动规定, Administración del Ciberespacio de China, marzo de 2024
- Gemini API Additional Terms of Service, Google, actualizado en abril de 2026
- Enterprise privacy: Our commitments, OpenAI, consultado en noviembre de 2026
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025, Andreessen Horowitz (a16z), junio de 2025


