Wenn Unternehmen den Einsatz großer Sprachmodelle erwägen, lautet die erste Frage oft nicht „wofür?“, sondern „von welchem Anbieter?“. Fast jeden Monat erscheinen neue Modelle, die Platzierungen in Rankings verschieben sich laufend, und das „stärkste Modell“ von heute kann in wenigen Monaten überholt sein. Für Unternehmen ist weniger wichtig, welches Modell das stärkste ist, als die richtige Betriebsform zu wählen, die Datenflüsse im Griff zu behalten und jederzeit das Modell wechseln zu können.
Dieser Beitrag stellt die drei wichtigsten Wege vor, große Sprachmodelle im Unternehmen zu nutzen, samt Vor- und Nachteilen, den tatsächlichen Abstand zwischen Open-Weight- und proprietären Modellen, die wichtigsten Punkte der Datencompliance und die Frage, warum man nicht auf ein einziges Modell setzen sollte. Zum Schluss folgen eine Schritt-für-Schritt-Anleitung zur Modellauswahl und häufige Fragen.
Auf welche Weise können Unternehmen große Sprachmodelle nutzen?
Es gibt im Wesentlichen drei Wege: die API eines proprietären Modells aufrufen, ein Open-Weight-Modell verwenden oder das Modell lokal bzw. privat betreiben. Der grundlegende Unterschied liegt nicht im Modell selbst, sondern darin, „wer das Modell betreibt, wohin die Daten fließen und wer bei Problemen die Verantwortung trägt“.
API eines proprietären Modells aufrufen. Eine API (Programmierschnittstelle) lässt sich als „Fernzugriff“ verstehen: Das Unternehmen sendet Fragen und Unterlagen an den Modellanbieter, der das Modell auf seinen eigenen Servern ausführt und das Ergebnis zurückliefert. GPT, Claude, Gemini und andere bieten diesen Dienst an, abgerechnet wird in der Regel nach Nutzungsmenge; die internen Parameter des Modells (die „Gewichte“) sind nicht öffentlich.
Open-Weight-Modelle verwenden. Bei Open-Weight-Modellen können die Gewichte heruntergeladen werden, zum Beispiel bei einigen Modellen der Familien Llama, Qwen, DeepSeek und Mistral. Das Unternehmen kann sie auf selbst gemieteten Cloud-Servern betreiben (Self-Hosting) oder einen von Drittplattformen gehosteten Dienst nutzen. Wichtig: „Open Weight“ heißt nicht „ohne Einschränkungen“, die Lizenzen unterscheiden sich stark. So schreibt etwa die Llama-4-Community-Lizenz von Meta vor, dass Nutzer mit mehr als 700 Millionen monatlich aktiven Nutzern gesondert eine Lizenz bei Meta beantragen müssen, und verlangt, dass auf den betreffenden Produkten oder Websites deutlich „Built with Llama“ angegeben wird (Quelle).
Lokaler bzw. privater Betrieb. Das Modell läuft im eigenen Rechenzentrum oder in einer dedizierten Umgebung des Unternehmens, die Daten verlassen das Unternehmensnetzwerk nicht. Dabei kommen meist Open-Weight-Modelle zum Einsatz. Diese Variante bietet die größte Kontrolle, doch Hardware, Betrieb und Sicherheitsverantwortung liegen vollständig beim Unternehmen.
Die folgende Tabelle vergleicht die wesentlichen Unterschiede der drei Wege:
| Vergleichspunkt | API proprietärer Modelle | Open-Weight-Modelle (Self-Hosting in der Cloud oder Hosting durch Dritte) | Lokaler / privater Betrieb |
|---|---|---|---|
| Leistungsfähigkeit | In der Regel auf dem neuesten Stand, sofort einsatzbereit | Spitzenmodelle nahe am Stand der Technik, große Auswahl | Begrenzt durch die eigene Hardware, meist kleine bis mittlere Modelle |
| Einstiegsgeschwindigkeit | Am schnellsten | Mittel | Am langsamsten, Hardwarebeschaffung und Umgebungsaufbau nötig |
| Kostenstruktur | Nutzungsabhängig, geringe Anfangsinvestition, bei steigender Nutzung steigen die Kosten | Hosting nutzungsabhängig oder selbst gemietete Rechenleistung; bei hoher, stabiler Auslastung unter Umständen günstiger | Hohe Anfangsinvestition in Hardware, dazu Strom-, Betriebs- und Personalkosten |
| Datenkontrolle | Daten gehen an den Anbieter, Schutz vor allem vertraglich | Beim Self-Hosting bleiben die Daten in der eigenen Cloud-Umgebung; beim Hosting abhängig von den Bedingungen des Hosters | Am stärksten, Daten verlassen das Unternehmensnetzwerk nicht |
| Compliance-Schwerpunkt | Auftragsverarbeitungsvertrag, Speicherregion der Daten, Drittlandübermittlung | Modelllizenz, Bedingungen des Hosters | Erleichtert lokale Vorgaben, aber die Sicherheitsverantwortung liegt ganz beim Unternehmen |
| Betriebsaufwand | Gering, Anbieter übernimmt | Mittel bis hoch | Hoch, eigenes technisches Team erforderlich |
| Anpassbarkeit | Abhängig von den Funktionen des Anbieters | Hoch, Fine-Tuning möglich | Hoch, Fine-Tuning möglich |
Die Tabelle beschreibt den Normalfall; auch innerhalb einer Kategorie können sich die Anbieter stark unterscheiden.
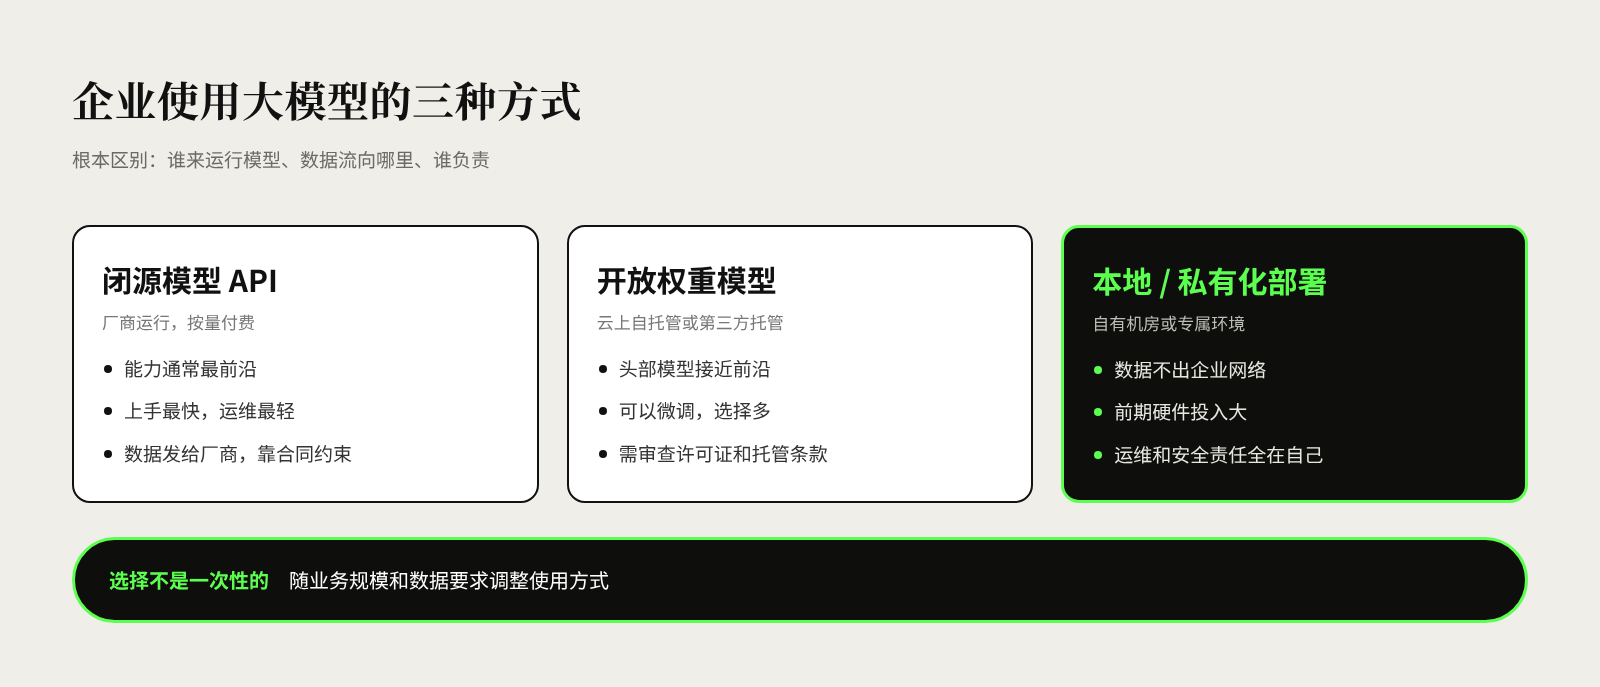
Ein Beispiel: Ein Handelsunternehmen möchte mit KI Beträge, Steuernummern und Fälligkeitsdaten automatisch aus Lieferantenrechnungen auslesen. In der Pilotphase ist das Belegvolumen klein, und der direkte API-Aufruf ist am einfachsten. Wird die Lösung konzernweit ausgerollt, ist das Aufrufvolumen hoch und stabil, und gelten strenge Vorgaben gegen die Weitergabe von Daten, kann das Self-Hosting eines Open-Weight-Modells bei Kosten und Compliance Vorteile haben. Die Betriebsform ist keine einmalige Entscheidung, sondern sollte mit Geschäftsumfang und Datenanforderungen mitwachsen.
Wie groß ist der Abstand zwischen Open-Weight- und proprietären Modellen?
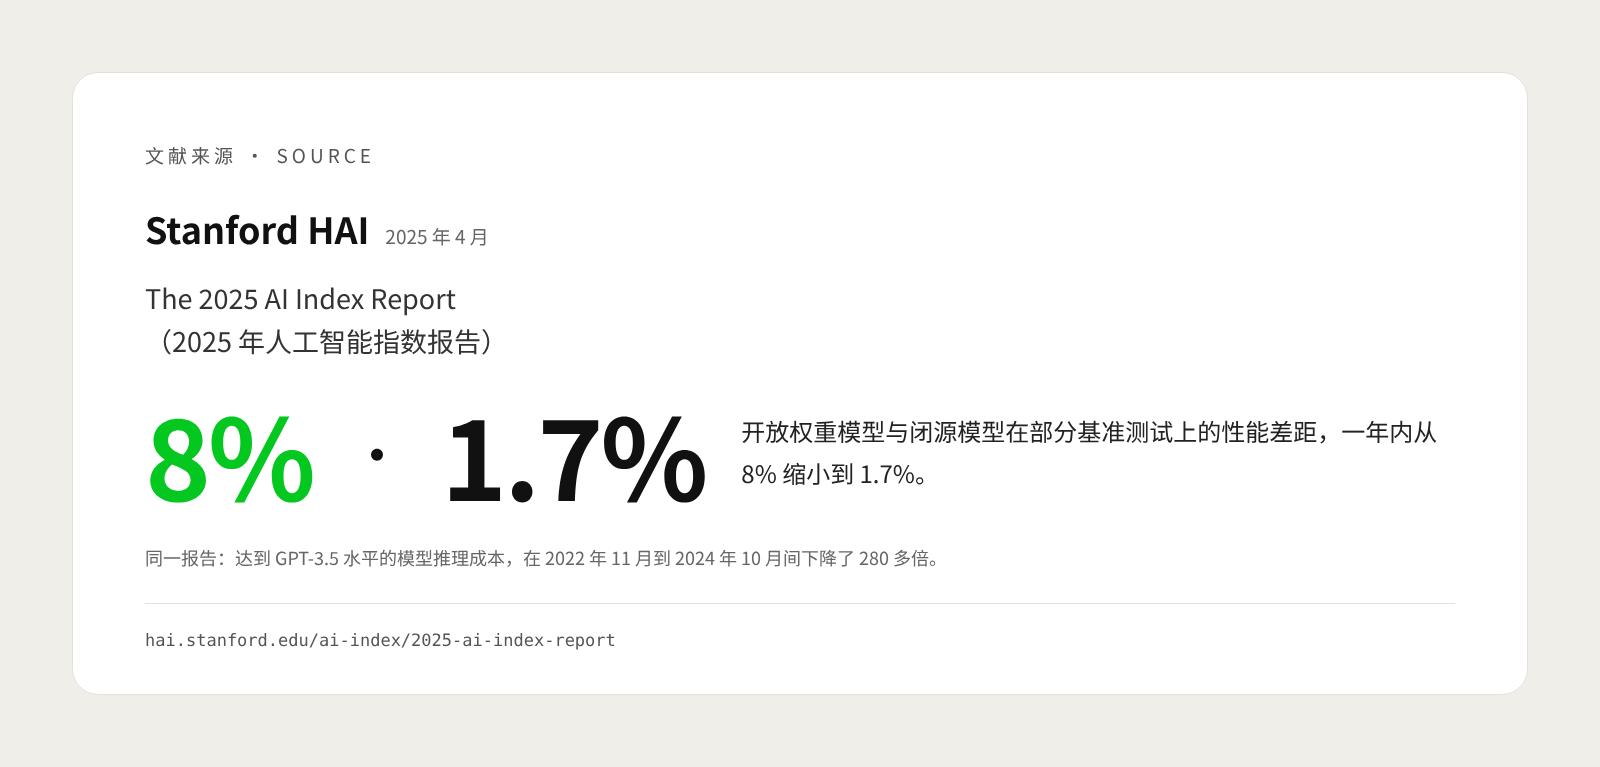
In den vergangenen zwei Jahren haben Open-Weight-Modelle schnelle Fortschritte gemacht. Der Abstand ist von einem deutlichen Generationensprung auf einstellige Prozentwerte geschrumpft, aber nicht verschwunden, und er schwankt hin und her.
Der im April 2025 vom Stanford Institute for Human-Centered AI (Stanford HAI) veröffentlichte „AI Index 2025“ stellt fest, dass sich der Leistungsabstand zwischen Open-Weight- und proprietären Modellen bei einigen Benchmarks innerhalb eines Jahres von 8 % auf 1,7 % verringert hat. Zugleich sanken die Inferenzkosten für ein Modell auf GPT-3.5-Niveau zwischen November 2022 und Oktober 2024 um mehr als das 280-Fache (Quelle).
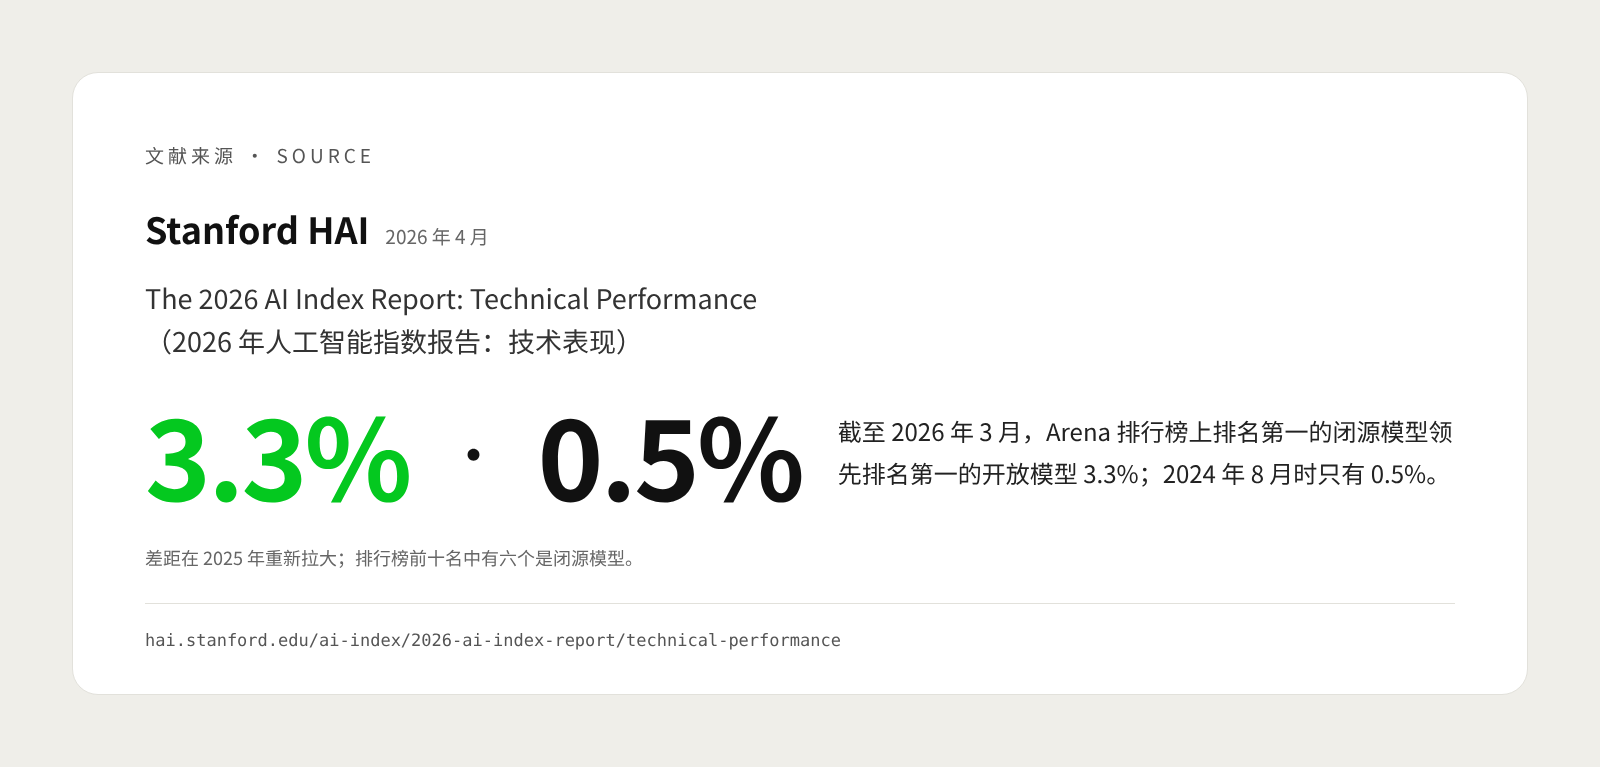
Der im April 2026 erschienene neue Bericht zeigt jedoch, dass sich dieser Abstand 2025 wieder vergrößert hat: Im Arena-Ranking lag das beste proprietäre Modell im März 2026 um 3,3 % vor dem besten offenen Modell, im August 2024 waren es nur 0,5 %. Von den zehn bestplatzierten Modellen sind sechs proprietär. Der Bericht hält außerdem fest, dass Modelle mehrerer US-amerikanischer und chinesischer Anbieter zur Spitzengruppe gehören und ihre Werte dicht beieinander liegen; im Wettbewerb rücken Kosten, Stabilität und Leistung in bestimmten Fachgebieten in den Vordergrund (Quelle).
Aus diesen Daten ergeben sich drei Erkenntnisse für Unternehmen:
- Rankings nicht als langfristiges Fazit verstehen. Laut demselben Bericht haben sich US-amerikanische und chinesische Modelle seit Anfang 2025 mehrfach an der Spitze abgelöst. Der Erste von heute ist nicht zwingend der Erste im nächsten Jahr.
- Ranking-Werte dienen nur als Orientierung. Der Bericht weist auch auf Zuverlässigkeitsprobleme gängiger Testsets hin; eine Studie fand in einigen Testsets einen Anteil ungültiger Aufgaben von bis zu 42 % (Quelle). Ein paar Prozentpunkte in einem allgemeinen Ranking sagen nicht unbedingt etwas über Ihren konkreten Anwendungsfall aus.
- Viele Aufgaben brauchen kein Spitzenmodell. Für Aufgaben wie die Klassifizierung von Tickets, das Auslesen von Belegdaten oder die Zusammenfassung interner Dokumente ist eine Lösung, die ausreichend leistungsfähig, günstiger und besser kontrollierbar ist, oft passender als die „stärkste“.
Ein Beispiel: Ein Einzelhandelsunternehmen ordnet mit einem Modell das Kundenfeedback aus den Filialen automatisch Kategorien wie „Produktqualität“, „Servicehaltung“ oder „Preis“ zu. Die Aufgabe folgt klaren Regeln, und ein mittelgroßes Open-Weight-Modell kann dafür bereits ausreichen; für die Analyse komplexer Lieferantenverträge im Einkauf kann dagegen ein leistungsfähigeres Modell lohnen. Ob ein Modell genügt, muss man mit den eigenen Daten testen, nicht am Ranking ablesen.
Worauf kommt es bei der Modellauswahl in puncto Datencompliance an?
Viele Unternehmen vergleichen bei der Auswahl nur Leistung und Preis und übersehen, wohin die Daten fließen. Bei der Modellauswahl sind Vertragsbedingungen und Datenfluss ebenso wichtig wie die Modellleistung. Die folgenden drei Ebenen werden am häufigsten nachgefragt; die konkrete Anwendung sollte stets mit juristischer Beratung auf das jeweilige Unternehmen abgestimmt werden.
Die EU-Datenschutz-Grundverordnung (DSGVO). Betrifft das Geschäft personenbezogene Daten aus der EU, sind zwei Punkte besonders zu beachten. Erstens: Nach Artikel 28 DSGVO dürfen nur Auftragsverarbeiter ausgewählt werden, die hinreichende Garantien bieten, und das Verhältnis der Beteiligten ist durch einen Vertrag oder ein anderes verbindliches Rechtsinstrument zu regeln. Zweitens: Nach Kapitel V (ab Artikel 44) muss die Übermittlung personenbezogener Daten in Länder außerhalb der EU die Bedingungen dieses Kapitels erfüllen; fehlt ein Angemessenheitsbeschluss, sind geeignete Garantien erforderlich, etwa Standarddatenschutzklauseln (Quelle).
Chinas Vorschriften zur Datenausfuhr. Erhebt ein Unternehmen Daten in China und stehen die Modellserver im Ausland, kann das Senden von Daten an das Modell eine Datenausfuhr darstellen. Die im März 2024 in Kraft getretenen „Bestimmungen zur Förderung und Regelung des grenzüberschreitenden Datenverkehrs“ der Cyberspace Administration of China unterscheiden mehrere Fälle: Datenverarbeiter, die nicht Betreiber kritischer Informationsinfrastrukturen sind, sind von der Anmeldung einer Sicherheitsbewertung, dem Abschluss von Standardverträgen oder der Zertifizierung befreit, wenn sie seit dem 1. Januar des laufenden Jahres personenbezogene Daten von insgesamt weniger als 100.000 Personen (ohne sensible personenbezogene Daten) ins Ausland übermittelt haben. Bei 100.000 bis weniger als 1 Million Personen (oder weniger als 10.000 Personen bei sensiblen personenbezogenen Daten) sind ein Standardvertrag zur Ausfuhr personenbezogener Daten oder eine Zertifizierung zum Schutz personenbezogener Daten erforderlich. Ab 1 Million Personen oder ab 10.000 Personen bei sensiblen personenbezogenen Daten sowie bei wichtigen Daten muss eine Sicherheitsbewertung der Datenausfuhr angemeldet werden (Quelle). Wer beispielsweise die Kaufdaten von Mitgliedern im ganzen Land zur Analyse an ein ausländisches Modell sendet, muss zunächst prüfen, ob einer dieser Fälle vorliegt.
Datennutzungsbedingungen des Anbieters. Derselbe Anbieter kann in verschiedenen Versionen völlig unterschiedliche Bedingungen haben. Ein Beispiel sind die Zusatzbedingungen für die Gemini API von Google: Bei der kostenlosen Nutzung verwendet Google die übermittelten Inhalte und generierten Antworten zur Verbesserung seiner Produkte, menschliche Prüfer können diese Inhalte lesen, und die Bedingungen weisen ausdrücklich darauf hin, keine sensiblen, vertraulichen oder personenbezogenen Informationen zu übermitteln. Bei der kostenpflichtigen Nutzung verwendet Google diese Inhalte nicht zur Produktverbesserung, die Daten werden nach dem Datenverarbeitungszusatz behandelt und nur für begrenzte Zeit zur Missbrauchsverhinderung und zur Erfüllung gesetzlicher Pflichten aufbewahrt (Quelle). Auch OpenAI erklärt auf seiner Seite zu den Datenschutzzusagen für Unternehmen, dass Geschäftsdaten von Unternehmen nicht zum Training von Modellen verwendet werden (Quelle). Das bedeutet: Wer Firmenunterlagen mit einem privaten kostenlosen Konto verarbeitet, unterliegt womöglich ganz anderen Datenregeln als beim vom Unternehmen beschafften offiziellen Dienst.
Vor Vertragsabschluss sollten beim Anbieter mindestens folgende Punkte geklärt werden:
- in welchem Land oder welcher Region die Daten gespeichert und verarbeitet werden;
- ob Ein- und Ausgaben zum Training oder zur Verbesserung von Modellen verwendet werden;
- wie lange Daten aufbewahrt werden und ob eine Löschung beantragt werden kann;
- ob eine menschliche Prüfung stattfindet und wo die Prüfer sitzen;
- ob weitere Unterauftragsverarbeiter eingesetzt werden und ob Änderungen vorab mitgeteilt werden.
Warum sollte man nicht auf ein einziges Modell setzen?
Alle Geschäftsprozesse an ein einziges Modell zu binden, wirkt einfach, übergibt aber Kosten, Leistung und Risiko einem einzigen Anbieter. Die Möglichkeit, das Modell zu wechseln, sollte von Anfang an eine Anforderung sein und nicht erst nachträglich nach einem Problem hergestellt werden.
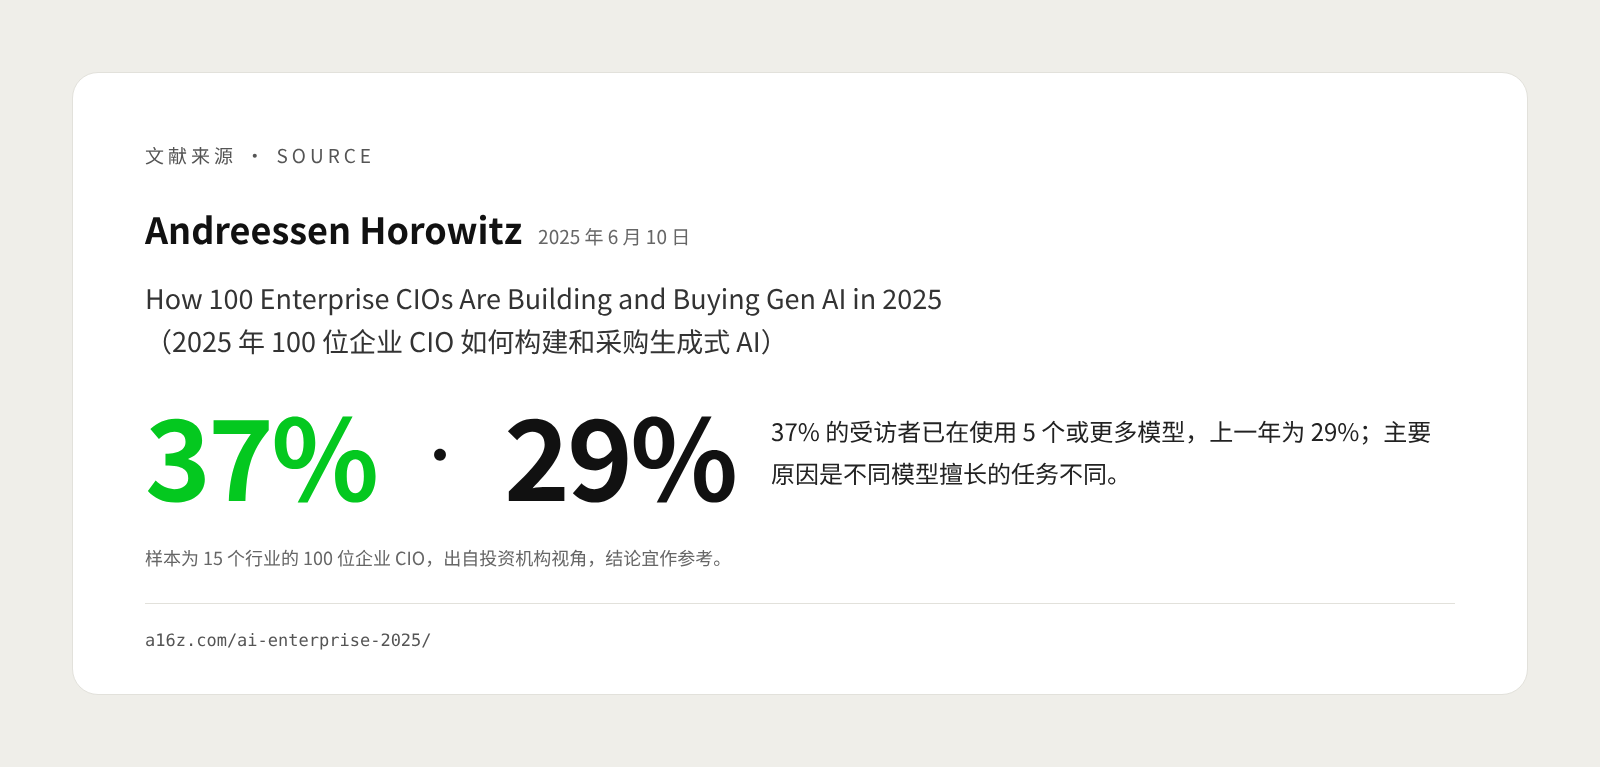
Auch die Praxis der Unternehmen bewegt sich in diese Richtung. In einer im Juni 2025 veröffentlichten Befragung des Investors a16z unter 100 CIOs von Unternehmen aus 15 Branchen setzten 37 % der Befragten bereits 5 oder mehr Modelle ein, im Vorjahr waren es 29 %. Unternehmen beziehen Modelle von mehreren Anbietern vor allem, weil verschiedene Modelle bei unterschiedlichen Aufgaben stark sind, aber auch, um die Bindung an einen einzelnen Hersteller zu vermeiden. Die Befragung zeigt aber auch, dass die Kosten eines Modellwechsels steigen: Teams haben Prompts und Schutzregeln auf bestimmte Modelle abgestimmt, und in mehrstufigen Agenten-Abläufen kann die Änderung eines Schritts mehrere nachfolgende Schritte beeinflussen (Quelle). Die Stichprobe dieser Befragung umfasst nur 100 Personen und stammt aus der Perspektive eines Investors, die Ergebnisse sind daher mit Vorsicht zu lesen.
Der übliche Ansatz bei mehreren Modellen ist das „Routing“: Anfragen werden je nach Art der Aufgabe automatisch dem am besten geeigneten Modell zugewiesen:
- Nach Schwierigkeit zuweisen. Einfache Aufgaben mit hohem Volumen wie Klassifizierung und Informationsextraktion gehen an schnelle, günstige Modelle; komplexe Analysen und Texterstellung an leistungsfähigere Modelle.
- Nach Datensensibilität zuweisen. Anfragen mit sensiblen Angaben wie Ausweisnummern, Bankkonten oder Gehältern von Beschäftigten werden ausschließlich lokal oder privat betriebenen Modellen übergeben.
- Nach Verfügbarkeit absichern. Fällt der Dienst eines Anbieters aus oder erhöht er die Preise stark, lässt sich der Datenverkehr auf ein alternatives Modell umleiten, ohne dass der Betrieb zum Stillstand kommt.
Ein Beispiel: Ein Kundenservice-System kann gängige Anliegen wie „Sendungsverfolgung“ oder „Adressänderung“ von einem kleinen Modell bearbeiten lassen, Beschwerdeeskalationen und Erstattungsstreitigkeiten an ein leistungsfähigeres Modell übergeben und Tickets mit Ausweisdaten von Kunden ausschließlich im lokalen Modell verarbeiten.
Damit Routing tatsächlich funktioniert, sind technisch drei Dinge nötig: eine einheitliche Anbindungsschicht zwischen Geschäftssystemen und Modellen, damit nicht jedes System direkt an einen bestimmten Anbieter angebunden ist; möglichst wenig Nutzung proprietärer Sonderfunktionen eines einzelnen Anbieters; und Prompts, Testsets und Geschäftsdaten in der eigenen Hand zu behalten, damit ein Modellwechsel auf einer belastbaren Grundlage erfolgen kann.
Wie wählt man das passende große Sprachmodell für das Unternehmen aus? Eine Schritt-für-Schritt-Anleitung
Ausgangspunkt der Auswahl sollte die Geschäftsaufgabe sein, nicht eine Liste von Modellen. Erst klären, welches Problem gelöst werden soll und welches Risiko akzeptabel ist, dann entscheiden, welches Modell in welcher Form eingesetzt wird.
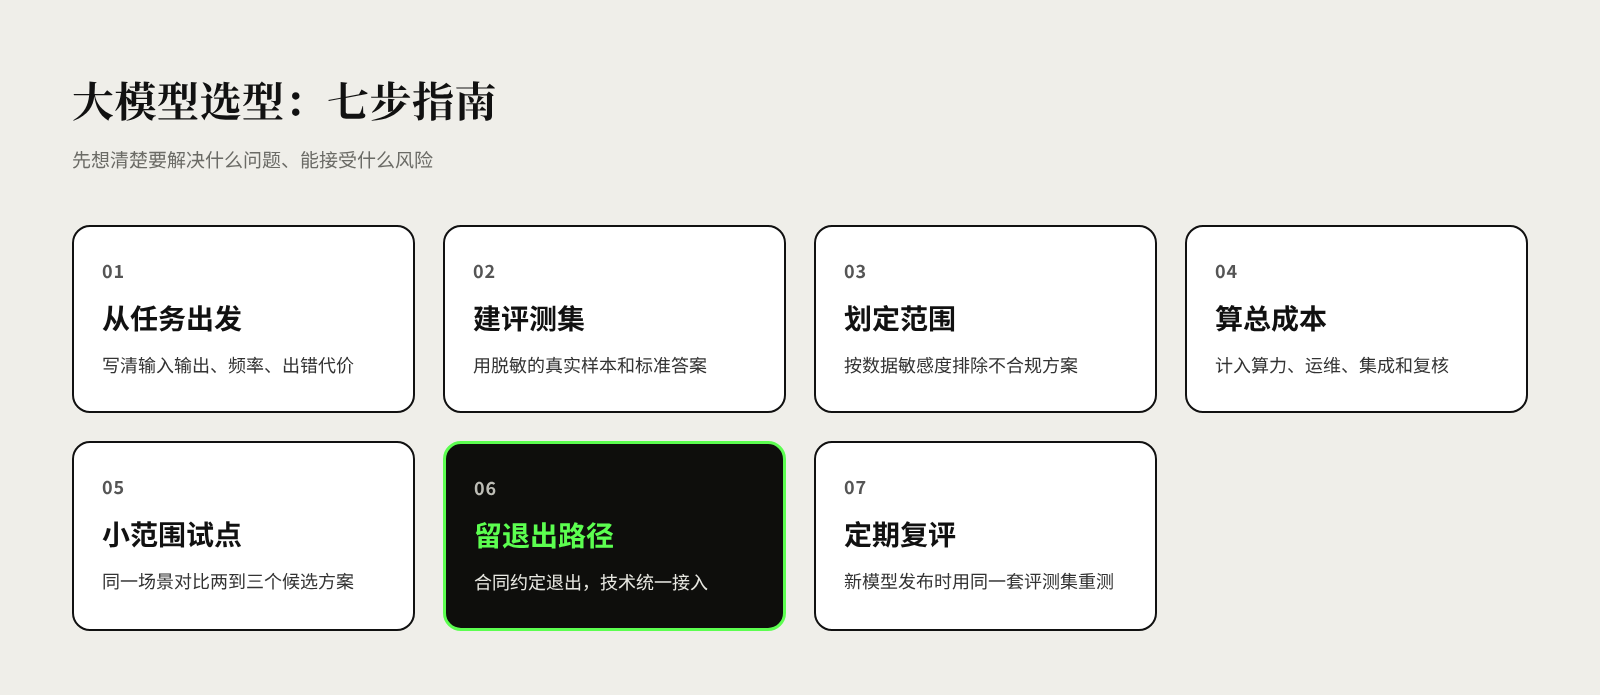
Schritt 1: Von der Aufgabe ausgehen und konkrete Anforderungen auflisten. Für jede Aufgabe Eingabe, Ausgabe, Häufigkeit, Fehlerkosten und Sensibilität der betroffenen Daten festhalten. Beispiel: „Täglich Beträge und Steuernummern aus Lieferantenrechnungen auslesen; Fehler führen zu falschen Zahlungen; die Daten enthalten Bankkonten von Lieferanten.“
Schritt 2: Mit echten Geschäftsdaten ein Testset aufbauen. Eine Reihe repräsentativer Stichproben aus dem Geschäftsbetrieb auswählen, anonymisieren und mit Musterlösungen versehen. Öffentliche Rankings helfen nur, die Kandidaten einzugrenzen; am Ende zählt, wie die Kandidatenmodelle auf Ihrem eigenen Testset abschneiden.
Schritt 3: Den Auswahlrahmen nach Datensensibilität festlegen. Zunächst beurteilen, welche Daten an externe APIs gesendet werden dürfen, welche eine Ausfuhr bedeuten und welche nur lokal bleiben dürfen, und danach nicht konforme Lösungen ausschließen. Eine Lösung, die die Compliance nicht besteht, gehört nicht auf die Kandidatenliste, so leistungsfähig sie auch ist.
Schritt 4: Die Gesamtbetriebskosten berechnen, nicht nur den Stückpreis. Bei API-Lösungen die Kosten bei wachsendem Aufrufvolumen abschätzen; bei Self-Hosting und lokalem Betrieb Rechenleistung oder Hardware, Strom, Betriebspersonal sowie Sicherheit und Upgrades einrechnen. In beiden Fällen kommen Aufwand für Systemintegration, Wirkungsmessung und manuelle Prüfung hinzu. Da die Modellpreise schnell sinken, sollte die Kostenrechnung regelmäßig aktualisiert werden.
Schritt 5: Im kleinen Rahmen pilotieren und zwei bis drei Kandidaten vergleichen. Im selben Geschäftsszenario mit demselben Testset und echtem Datenverkehr Genauigkeit, Antwortzeit, Kosten und Stabilität der Lösungen vergleichen und Rückmeldungen der Nutzer an der Basis einholen.
Schritt 6: Den Ausstiegspfad frühzeitig absichern. Im Vertrag Datenexport und -löschung, vorherige Ankündigung von Preisanpassungen und Haftung bei Dienstausfällen regeln; technisch über eine einheitliche Anbindungsschicht vom konkreten Modell entkoppeln. So wird ein künftiger Modellwechsel zu einer Umschaltung statt zu einem Neuaufbau.
Schritt 7: Regelmäßig neu bewerten. Empfehlenswert ist, regelmäßig oder bei der Veröffentlichung wichtiger neuer Modelle mit demselben Testset neu zu testen und unter Berücksichtigung der Kostenentwicklung zu entscheiden, ob die Modellkombination angepasst wird.
Häufige Fragen zur Auswahl großer Sprachmodelle
Lohnt sich für kleine und mittlere Unternehmen der lokale Betrieb eines großen Sprachmodells? In den meisten Fällen ist es nicht nötig, mit dem lokalen Betrieb zu beginnen. Er erfordert hohe Anfangsinvestitionen und Fachpersonal für die Wartung. Sinnvoll ist, zunächst einen kostenpflichtigen API-Dienst mit klaren Datenbedingungen zu wählen und einen privaten Betrieb erst bei hochsensiblen Daten oder klaren Anforderungen an die lokale Datenhaltung zu erwägen.
Sind Open-Weight-Modelle kostenlos? Der Download der Gewichte ist in der Regel kostenlos, doch der Betrieb des Modells erfordert Rechenleistung, Wartung und Personal; bei geringer Nutzung ist das nicht unbedingt günstiger als eine API. Zudem sind die Lizenzbedingungen je nach Anbieter verschieden und sollten vor der kommerziellen Nutzung sorgfältig gelesen werden.
Welche Risiken entstehen, wenn Beschäftigte kostenlose KI-Tools für die Arbeit nutzen? Die Datenbedingungen kostenloser Versionen und kostenpflichtiger Unternehmensversionen können völlig verschieden sein; Inhalte aus kostenlosen Versionen können zur Modellverbesserung genutzt oder sogar von Menschen geprüft werden. Unternehmen sollten klar regeln, welche Unterlagen in externe KI-Tools eingegeben werden dürfen, und Beschäftigten geprüfte, offizielle Tools bereitstellen.
Die Modelle entwickeln sich so schnell – ist die heutige Wahl nicht bald veraltet? Es werden neue Modelle erscheinen, aber das ist kein Grund zur Sorge. Mit einem eigenen Testset und einer einheitlichen Anbindungsschicht lässt sich ein neues Modell bei Erscheinen testen und bei Eignung austauschen; aus einer einmaligen Wette wird ein Prozess, der sich laufend verbessern lässt.
Quellen
- The 2025 AI Index Report, Stanford HAI, April 2025
- The 2026 AI Index Report: Technical Performance, Stanford HAI, April 2026
- Llama 4 Community License Agreement, Meta, April 2025
- Regulation (EU) 2016/679 (General Data Protection Regulation), EUR-Lex, April 2016
- Provisions on Promoting and Regulating Cross-Border Data Flows (促进和规范数据跨境流动规定), Cyberspace Administration of China, März 2024
- Gemini API Additional Terms of Service, Google, aktualisiert im April 2026
- Enterprise privacy: Our commitments, OpenAI, abgerufen im November 2026
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025, Andreessen Horowitz (a16z), Juni 2025


