Lorsqu'une entreprise décide d'adopter les grands modèles de langage, la première question qui surgit n'est souvent pas « pour quoi faire ? », mais « chez quel fournisseur ? ». De nouveaux modèles sortent presque chaque mois, les classements évoluent sans cesse, et le « meilleur modèle » d'aujourd'hui peut être dépassé en quelques mois. Pour une entreprise, l'essentiel n'est pas de savoir quel modèle est le plus puissant, mais de choisir le bon mode d'utilisation, de maîtriser les flux de données et de garder la possibilité de changer de modèle à tout moment.
Cet article présente les trois principaux modes d'utilisation des grands modèles en entreprise et leurs avantages et inconvénients, l'écart réel entre modèles à poids ouverts et modèles propriétaires, les points de vigilance en matière de conformité des données, et les raisons de ne pas tout miser sur un seul modèle, avant de proposer un guide de sélection étape par étape et une foire aux questions.
Quels sont les modes d'utilisation des grands modèles en entreprise ?
Les entreprises utilisent les grands modèles de trois manières principales : en appelant l'API d'un modèle propriétaire, en recourant à un modèle à poids ouverts, ou en le déployant sur site ou en environnement privé. La différence fondamentale ne tient pas au modèle lui-même, mais à trois questions : qui exécute le modèle, où vont les données et qui est responsable en cas de problème.
Appeler l'API d'un modèle propriétaire. Une API (interface de programmation d'application) peut être vue comme un « guichet d'appel à distance » : l'entreprise envoie ses questions et ses documents à l'éditeur du modèle, qui exécute le modèle sur ses propres serveurs et renvoie le résultat. GPT, Claude, Gemini et d'autres proposent ce type de service, généralement facturé à l'usage ; les paramètres internes du modèle (ses « poids ») ne sont pas publiés.
Recourir à un modèle à poids ouverts. Les poids des modèles à poids ouverts (open-weight) sont téléchargeables : c'est le cas de certains modèles des familles Llama, Qwen, DeepSeek ou Mistral. L'entreprise peut les déployer sur des serveurs cloud qu'elle loue (auto-hébergement) ou passer par un service hébergé proposé par une plateforme tierce. Attention : « poids ouverts » ne signifie pas absence de restrictions, et les licences varient fortement d'un éditeur à l'autre. Par exemple, la licence communautaire de Llama 4 de Meta impose aux utilisateurs comptant plus de 700 millions d'utilisateurs actifs mensuels de solliciter une licence distincte auprès de Meta, et exige d'afficher de manière visible la mention « Built with Llama » sur les produits ou sites concernés (source).
Déploiement sur site ou en environnement privé. Le modèle est déployé dans le centre de données de l'entreprise ou dans un environnement dédié, et les données ne quittent pas le réseau de l'entreprise. Ce mode repose généralement sur des modèles à poids ouverts ; il offre la maîtrise la plus forte, mais l'entreprise assume seule le matériel, l'exploitation et la sécurité.
Le tableau ci-dessous compare les principales différences entre ces trois modes :
| Critère | API de modèle propriétaire | Modèle à poids ouverts (auto-hébergé dans le cloud ou hébergé par un tiers) | Déploiement sur site / privé |
|---|---|---|---|
| Capacités | Généralement à la pointe, prêt à l'emploi | Les meilleurs modèles approchent l'état de l'art, large choix | Limitées par le matériel disponible, souvent des modèles de petite ou moyenne taille |
| Rapidité de mise en route | La plus rapide | Moyenne | La plus lente : achat de matériel et mise en place de l'environnement |
| Structure de coûts | Paiement à l'usage, faible investissement initial, coût croissant avec le volume | Paiement à l'usage en mode hébergé, ou location de capacité de calcul ; potentiellement plus économique pour des volumes élevés et stables | Investissement matériel initial important, auquel s'ajoutent l'électricité, l'exploitation et le personnel |
| Maîtrise des données | Données envoyées à l'éditeur, encadrées surtout par le contrat | En auto-hébergement, les données restent dans votre environnement cloud ; en mode hébergé, tout dépend des conditions de l'hébergeur | Maximale : les données ne quittent pas le réseau de l'entreprise |
| Points de conformité | Accord de traitement des données, région de stockage, transferts hors frontières | Licence du modèle, conditions de l'hébergeur | Facilite le respect des exigences de localisation, mais toute la responsabilité de la sécurité vous incombe |
| Complexité d'exploitation | Faible, assurée par l'éditeur | Moyenne à élevée | Élevée, nécessite une équipe technique dédiée |
| Personnalisation | Selon les fonctionnalités ouvertes par l'éditeur | Élevée, fine-tuning possible | Élevée, fine-tuning possible |
Ce tableau décrit les cas généraux ; au sein d'une même catégorie, les offres peuvent varier considérablement d'un fournisseur à l'autre.
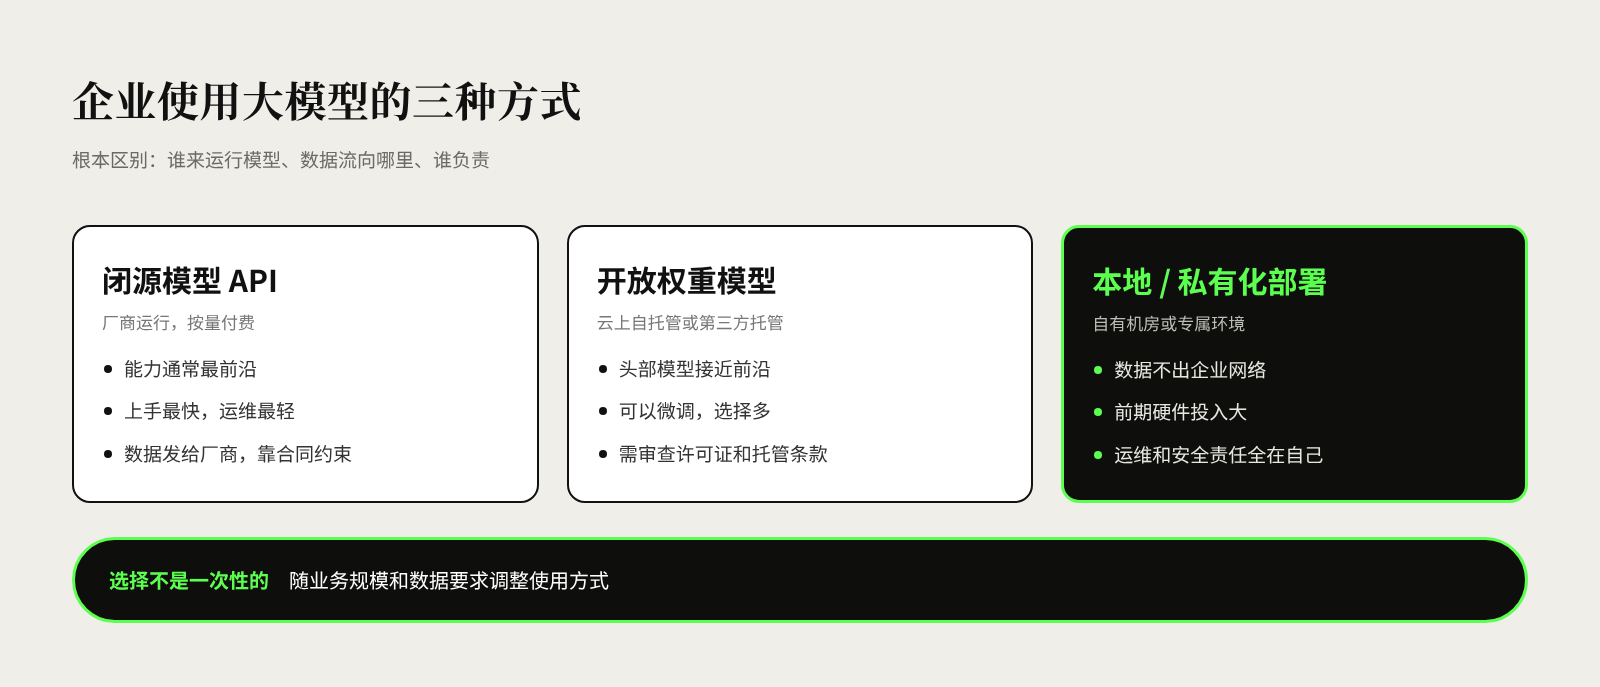
Prenons une entreprise de distribution qui souhaite utiliser l'IA pour extraire automatiquement le montant, le numéro fiscal et la date d'échéance des factures fournisseurs. En phase pilote, le volume de factures est faible et l'appel direct à une API est la solution la plus simple ; une fois le déploiement étendu à tout le groupe, avec des volumes importants et stables et des exigences strictes sur la sortie des données, un modèle à poids ouverts auto-hébergé peut devenir plus avantageux, en coûts comme en conformité. Le mode d'utilisation n'est pas un choix figé : il doit évoluer avec l'échelle de l'activité et les exigences sur les données.
Quel est l'écart entre modèles à poids ouverts et modèles propriétaires ?
Ces deux dernières années, les modèles à poids ouverts ont progressé très vite. L'écart est passé d'une différence de génération manifeste à quelques points de pourcentage, mais il n'a pas disparu et il fluctue.
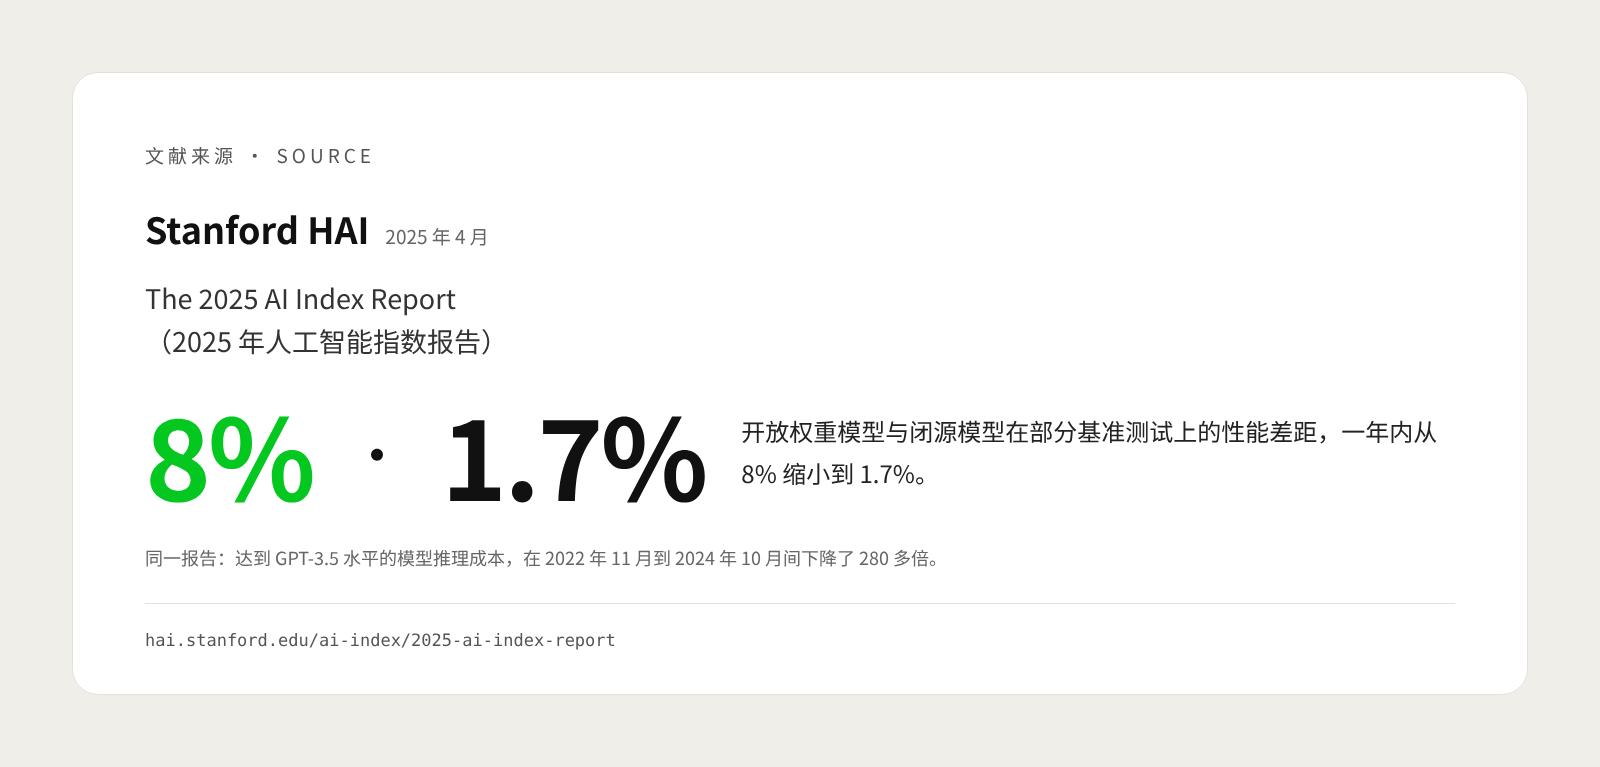
Le rapport « AI Index 2025 », publié en avril 2025 par le Stanford Institute for Human-Centered Artificial Intelligence (Stanford HAI), indique que l'écart de performance entre modèles à poids ouverts et modèles propriétaires sur certains benchmarks est passé de 8 % à 1,7 % en un an ; dans le même temps, le coût d'inférence d'un modèle de niveau GPT-3.5 a été divisé par plus de 280 entre novembre 2022 et octobre 2024 (source).
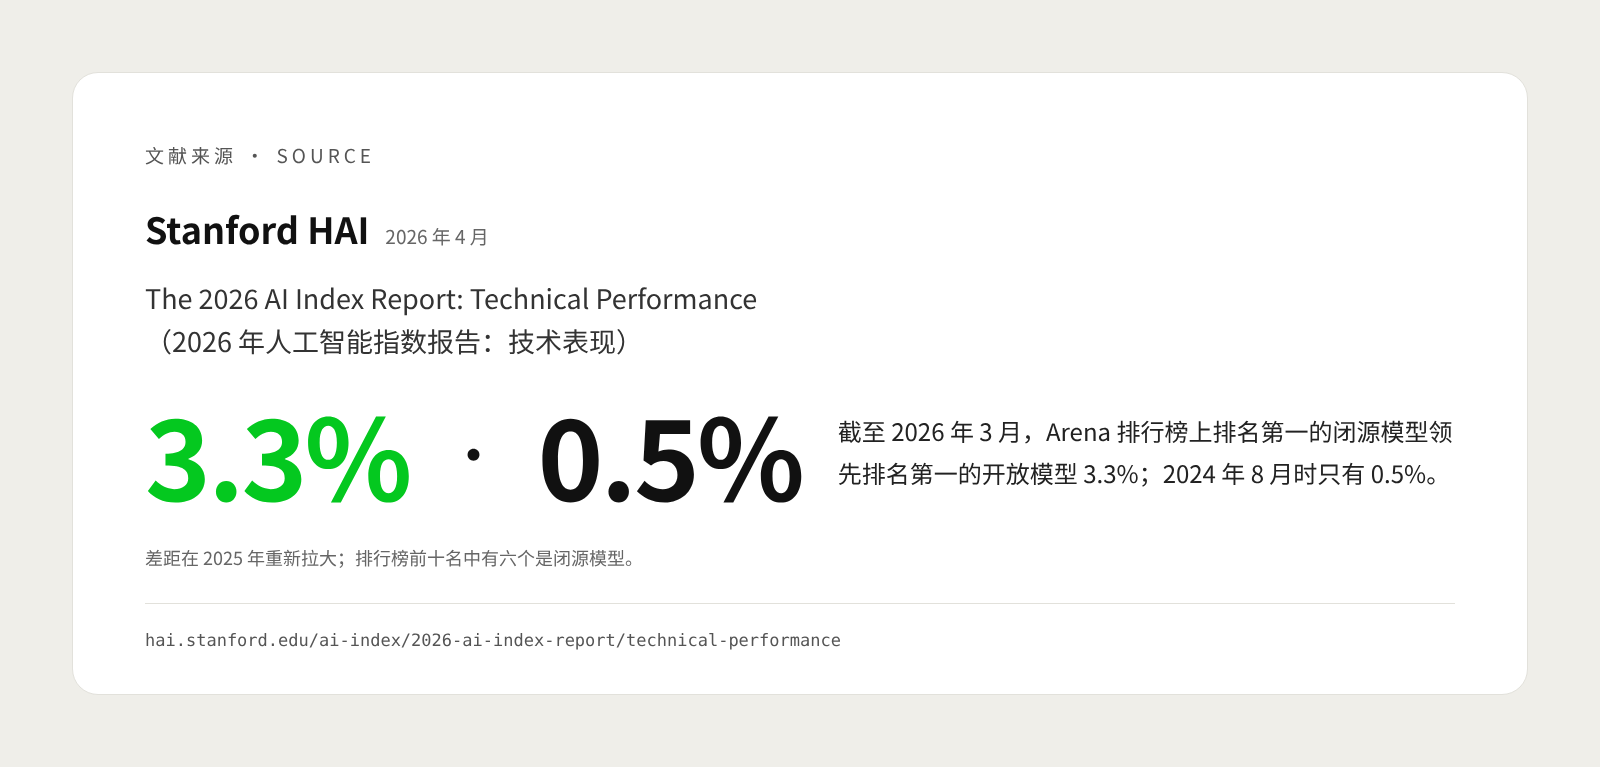
Mais l'édition publiée en avril 2026 montre que cet écart s'est de nouveau creusé en 2025 : en mars 2026, sur le classement Arena, le premier modèle propriétaire devançait le premier modèle ouvert de 3,3 %, contre 0,5 % seulement en août 2024 ; six des dix premiers modèles du classement étaient propriétaires. Le rapport souligne également que des modèles de plusieurs éditeurs américains et chinois figurent dans le peloton de tête, avec des scores très proches, et que la concurrence se déplace vers le coût, la fiabilité et les performances dans des domaines spécifiques (source).
Ces données appellent trois enseignements pour les entreprises :
- Ne pas considérer un classement comme une vérité durable. Le même rapport note que, depuis début 2025, les modèles américains et chinois ont plusieurs fois alterné en tête. Le premier d'aujourd'hui ne sera pas forcément celui de l'an prochain.
- Les scores des classements ne sont qu'indicatifs. Le rapport rappelle aussi que les jeux d'évaluation courants posent des problèmes de fiabilité : selon une étude, jusqu'à 42 % des questions de certains jeux d'évaluation seraient invalides (source). Quelques points d'écart sur un classement généraliste ne se retrouvent pas nécessairement dans votre activité.
- Beaucoup de tâches ne nécessitent pas un modèle de pointe. Pour la classification de tickets, l'extraction d'informations à partir de documents ou le résumé de documents internes, une solution suffisamment performante, moins coûteuse et offrant une meilleure maîtrise des données est souvent plus adaptée que la « plus puissante ».
Par exemple, une enseigne de distribution utilise un modèle pour classer automatiquement les avis clients de ses magasins en catégories telles que « qualité des produits », « accueil » ou « prix ». Les règles de cette tâche étant claires, un modèle à poids ouverts de taille moyenne peut suffire ; en revanche, analyser des contrats fournisseurs complexes pour le service achats peut justifier un modèle plus performant. Pour savoir si un modèle suffit, testez-le sur vos propres données plutôt que de vous fier aux classements.
Quels points de conformité des données surveiller lors du choix d'un modèle ?
Beaucoup d'entreprises ne comparent que les capacités et les prix, et négligent la destination des données. Dans le choix d'un modèle, les clauses contractuelles et les flux de données comptent autant que les capacités. Les trois aspects suivants sont les plus souvent abordés ; leur application concrète doit être examinée avec un conseil juridique au regard de la situation de l'entreprise.
Le règlement général sur la protection des données (RGPD) de l'UE. Si votre activité implique des données personnelles relevant de l'UE, deux points méritent une attention particulière. Premièrement, l'article 28 du RGPD prévoit que, lorsqu'on confie un traitement de données personnelles à un tiers, on ne peut faire appel qu'à des sous-traitants présentant des garanties suffisantes, et que la relation de traitement doit être régie par un contrat ou un autre acte juridique contraignant. Deuxièmement, le chapitre V (à partir de l'article 44) dispose que tout transfert de données personnelles hors de l'UE doit respecter les conditions de ce chapitre ; en l'absence de « décision d'adéquation », des garanties appropriées doivent être prévues, par exemple des clauses types de protection des données (source).
La réglementation chinoise sur les transferts de données à l'étranger. Si l'entreprise collecte des données en Chine et que les serveurs du modèle utilisé se trouvent hors de Chine, l'envoi de données au modèle peut constituer un transfert transfrontalier. Les « Dispositions visant à promouvoir et à encadrer les flux transfrontaliers de données », mises en application en mars 2024 par l'Administration du cyberespace de Chine (CAC), distinguent plusieurs cas : les responsables de traitement autres que les opérateurs d'infrastructures d'information critiques qui, depuis le 1er janvier de l'année en cours, ont transféré à l'étranger les informations personnelles de moins de 100 000 personnes au total (hors informations personnelles sensibles) sont dispensés d'évaluation de sécurité, de contrat type et de certification ; entre 100 000 et moins de 1 million de personnes (ou moins de 10 000 personnes pour les informations personnelles sensibles), il faut conclure un contrat type de transfert d'informations personnelles à l'étranger ou obtenir une certification de protection des informations personnelles ; à partir de 1 million de personnes, ou de 10 000 personnes pour les informations personnelles sensibles, ainsi qu'en présence de données importantes, une évaluation de sécurité des transferts de données doit être demandée (source). Par exemple, envoyer à un modèle hébergé à l'étranger l'historique d'achats des membres de tout le pays pour analyse impose d'évaluer au préalable si l'on relève de l'un de ces cas.
Les conditions d'utilisation des données par le fournisseur. Chez un même fournisseur, les conditions peuvent être radicalement différentes d'une offre à l'autre. Prenons les conditions d'utilisation supplémentaires de l'API Gemini de Google : avec les services gratuits, Google utilise les contenus soumis et les réponses générées pour améliorer ses produits, des réviseurs humains peuvent les lire, et les conditions invitent expressément à ne pas soumettre d'informations sensibles, confidentielles ou personnelles ; avec les services payants, Google n'utilise pas ces contenus pour améliorer ses produits, les données sont traitées conformément à l'avenant relatif au traitement des données et ne sont conservées que pendant une durée limitée, aux seules fins de prévenir les abus et de satisfaire aux obligations légales (source). OpenAI déclare également, sur sa page consacrée à ses engagements de confidentialité pour les entreprises, ne pas utiliser les données métier des entreprises pour entraîner ses modèles (source). Autrement dit, un collaborateur qui traite des documents de l'entreprise avec un compte personnel gratuit peut être soumis à des règles de traitement des données totalement différentes de celles du service officiel souscrit par l'entreprise.
Avant de signer, vérifiez au minimum les points suivants auprès du fournisseur :
- dans quel pays ou quelle région les données sont stockées et traitées ;
- si les entrées et les sorties sont utilisées pour entraîner ou améliorer le modèle ;
- combien de temps les données sont conservées, et s'il est possible d'en demander la suppression ;
- s'il existe une relecture humaine, et où se trouvent les réviseurs ;
- s'il fait appel à d'autres sous-traitants, et s'il prévient à l'avance en cas de changement.
Pourquoi ne pas tout miser sur un seul modèle ?
Lier toutes ses activités à un seul modèle paraît simple, mais revient en réalité à confier coûts, capacités et risques à un fournisseur unique. La possibilité de changer de modèle doit être une exigence posée dès le départ, et non un correctif apporté après coup.
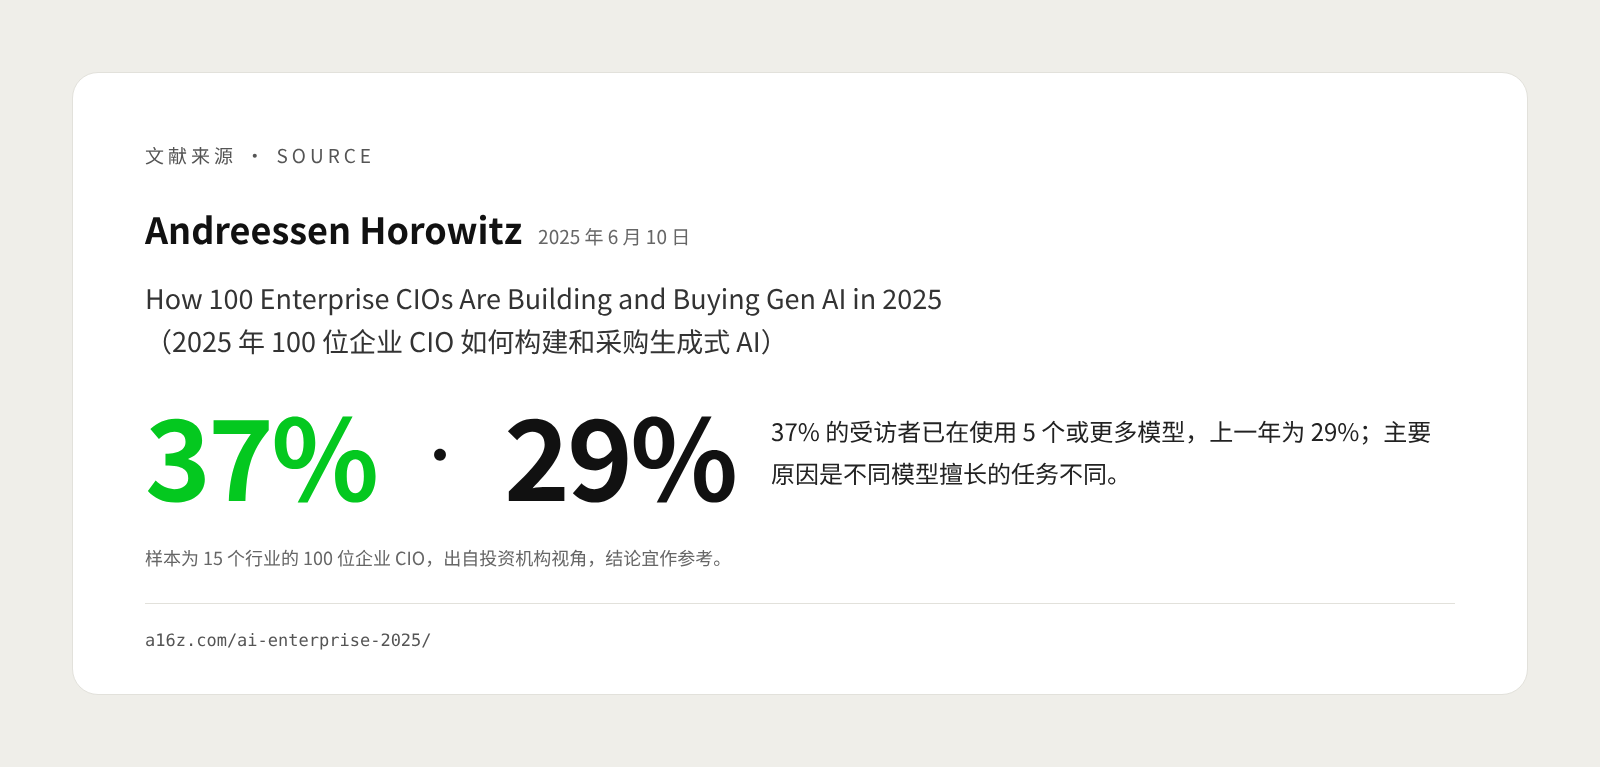
Les pratiques des entreprises vont d'ailleurs dans ce sens. Dans une enquête publiée en juin 2025, le fonds d'investissement a16z a interrogé 100 DSI d'entreprises de 15 secteurs : 37 % des répondants utilisent déjà 5 modèles ou plus, contre 29 % l'année précédente ; les entreprises s'approvisionnent auprès de plusieurs fournisseurs principalement parce que les modèles excellent dans des tâches différentes, mais aussi pour éviter la dépendance à un seul éditeur. L'enquête constate cependant que le coût d'un changement de modèle augmente : les équipes ont adapté leurs prompts et leurs garde-fous à des modèles précis, et dans les workflows agentiques à plusieurs étapes, modifier un maillon peut avoir des répercussions sur plusieurs maillons en aval (source). L'échantillon ne compte que 100 personnes et reflète le point de vue d'un investisseur : ses conclusions sont à prendre à titre indicatif.
L'approche multimodèle la plus courante est le « routage » (routing) : chaque requête est attribuée automatiquement au modèle le plus adapté, selon les caractéristiques de la tâche.
- Selon la difficulté. Les tâches simples et volumineuses, comme la classification ou l'extraction d'informations, sont confiées à des modèles rapides et peu coûteux ; les analyses et rédactions complexes, à des modèles plus performants.
- Selon la sensibilité des données. Les requêtes contenant des informations sensibles, comme des numéros de pièce d'identité, des coordonnées bancaires ou les salaires des employés, sont traitées exclusivement par des modèles déployés sur site ou en environnement privé.
- Selon la disponibilité, en secours. En cas de panne ou de forte hausse tarifaire chez un fournisseur, le trafic peut être basculé vers un modèle de secours, sans interrompre l'activité.
Par exemple, un système de service client peut confier les demandes courantes, comme « suivre ma livraison » ou « modifier mon adresse », à un petit modèle, transmettre les réclamations escaladées et les litiges de remboursement à un modèle plus performant, et réserver à un modèle local le traitement des tickets contenant des pièces d'identité de clients.
Pour que le routage soit réellement praticable, trois conditions techniques sont nécessaires : ajouter une couche d'accès unifiée entre les systèmes métier et les modèles, afin qu'aucun système ne soit raccordé directement à un éditeur particulier ; limiter autant que possible le recours aux fonctionnalités propres à un seul éditeur ; garder la maîtrise de vos prompts, de vos jeux d'évaluation et de vos données métier, pour disposer d'une base solide le jour où vous changez de modèle.
Comment choisir le bon grand modèle pour votre entreprise ? Guide étape par étape
Le point de départ de la sélection doit être la tâche métier, et non une liste de modèles. Clarifiez d'abord le problème à résoudre et les risques acceptables, puis décidez quel modèle utiliser et de quelle manière.
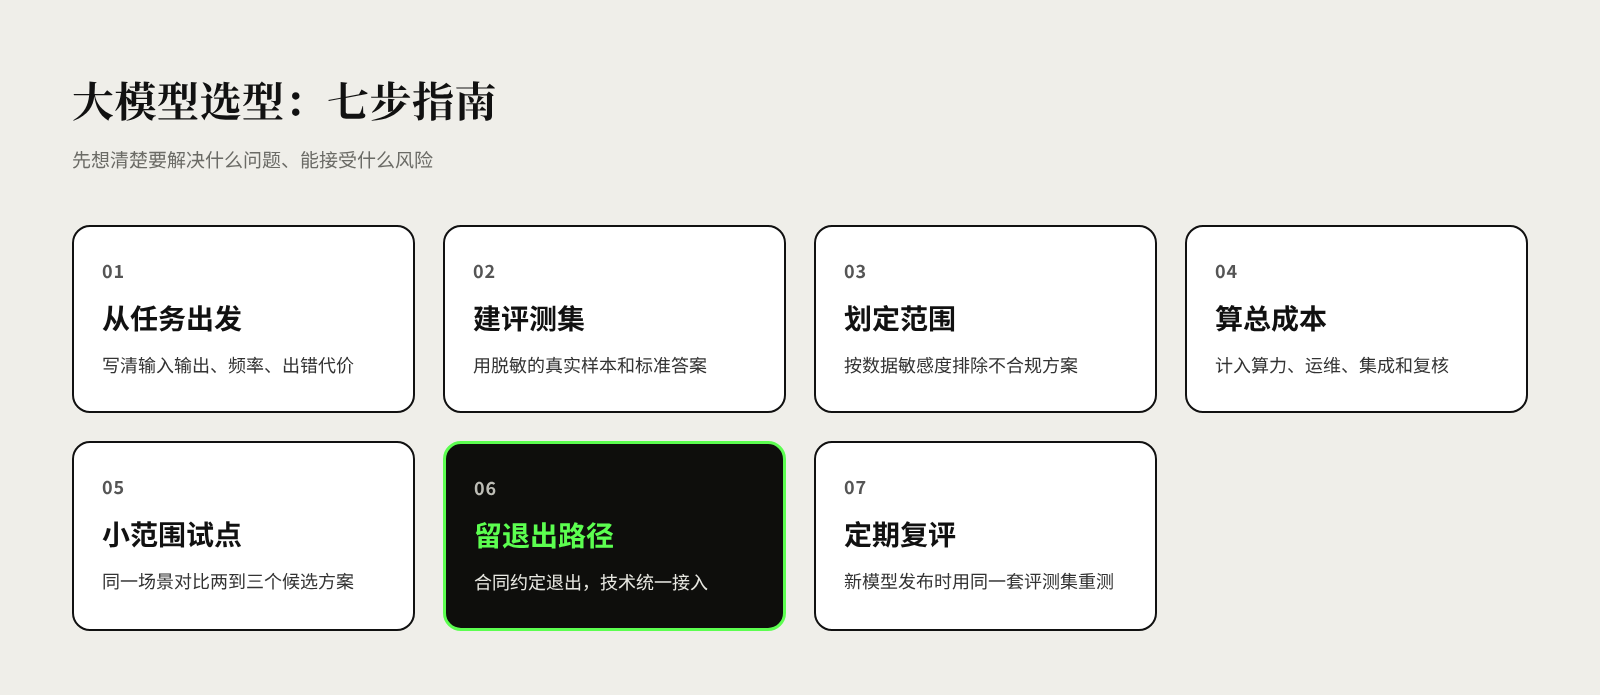
Étape 1 : partir des tâches et lister les besoins concrets. Décrivez pour chaque tâche les entrées, les sorties, la fréquence de traitement, le coût d'une erreur et le niveau de sensibilité des données concernées. Par exemple : « extraire chaque jour le montant et le numéro fiscal des factures fournisseurs ; une erreur entraîne un paiement erroné ; les données incluent les coordonnées bancaires des fournisseurs ».
Étape 2 : constituer un jeu d'évaluation à partir de vos données réelles. Sélectionnez dans votre activité un ensemble d'échantillons représentatifs, anonymisez-les et rédigez les réponses attendues. Les classements publics ne servent qu'à réduire la liste des candidats ; ce qui compte au final, ce sont les performances des modèles candidats sur votre propre jeu d'évaluation.
Étape 3 : délimiter le périmètre selon la sensibilité des données. Déterminez d'abord quelles données peuvent être envoyées à une API externe, lesquelles impliquent un transfert à l'étranger et lesquelles doivent rester en local, puis écartez les solutions qui ne répondent pas à ces exigences. Une solution non conforme ne doit pas figurer parmi les candidats, aussi performante soit-elle.
Étape 4 : calculer le coût total de possession, pas seulement le prix unitaire. Pour une API, estimez la facture à mesure que les volumes d'appels augmentent ; pour l'auto-hébergement et le déploiement sur site, intégrez la capacité de calcul ou le matériel, l'électricité, le personnel d'exploitation, la sécurité et les mises à niveau. Dans les deux cas, comptez aussi l'intégration aux systèmes, l'évaluation des résultats et la relecture humaine. Les prix des modèles baissant rapidement, le calcul des coûts doit être mis à jour régulièrement.
Étape 5 : mener un pilote à petite échelle avec deux ou trois solutions candidates. Sur un même cas d'usage, comparez la précision, le temps de réponse, le coût et la stabilité des différentes solutions avec le même jeu d'évaluation et un trafic réel, et recueillez les retours des utilisateurs de terrain.
Étape 6 : prévoir dès maintenant une stratégie de sortie. Inscrivez dans le contrat l'export et la suppression des données, un préavis en cas de modification tarifaire et les responsabilités en cas d'interruption de service ; sur le plan technique, découplez vos systèmes des modèles grâce à une couche d'accès unifiée. Ainsi, changer de modèle à l'avenir sera une simple bascule, et non une reconstruction.
Étape 7 : réévaluer régulièrement. Il est recommandé de refaire les tests avec le même jeu d'évaluation à intervalles réguliers, ou à chaque sortie d'un nouveau modèle important, et de décider en fonction de l'évolution des coûts s'il faut ajuster la combinaison de modèles.
Questions fréquentes sur le choix d'un grand modèle
Une PME a-t-elle besoin de déployer un grand modèle sur site ? Dans la plupart des cas, il n'est pas nécessaire de commencer par là. Le déploiement sur site exige un investissement initial important et du personnel technique dédié à sa maintenance. Mieux vaut commencer par un service d'API payant aux conditions claires en matière de données, et n'envisager un déploiement privé qu'en présence de données très sensibles ou d'exigences explicites de localisation.
Les modèles à poids ouverts sont-ils gratuits ? Le téléchargement des poids est généralement gratuit, mais l'exécution du modèle nécessite de la capacité de calcul, de l'exploitation et du personnel ; pour de faibles volumes, ce n'est pas forcément moins cher qu'une API. En outre, les conditions de licence varient selon les éditeurs : lisez-les attentivement avant tout usage commercial.
Quels risques lorsque des collaborateurs utilisent des outils d'IA gratuits pour leur travail ? Les conditions relatives aux données peuvent être totalement différentes entre version gratuite et version entreprise payante : les contenus saisis dans une version gratuite peuvent servir à améliorer le modèle, voire être relus par des humains. L'entreprise doit préciser quels documents peuvent être saisis dans des outils d'IA externes et mettre à la disposition des collaborateurs des outils officiels validés.
Les modèles évoluent si vite : un choix fait aujourd'hui sera-t-il vite dépassé ? De nouveaux modèles apparaîtront, mais ce n'est pas un problème. Dès lors que vous disposez de votre propre jeu d'évaluation et d'une couche d'accès unifiée, il suffit de tester chaque nouveau modèle et d'en changer s'il convient : le choix d'un modèle cesse d'être un pari ponctuel pour devenir un processus d'optimisation continue.
Références
- The 2025 AI Index Report, Stanford HAI, avril 2025
- The 2026 AI Index Report: Technical Performance, Stanford HAI, avril 2026
- Llama 4 Community License Agreement, Meta, avril 2025
- Règlement (UE) 2016/679 (règlement général sur la protection des données), EUR-Lex, avril 2016
- Dispositions visant à promouvoir et à encadrer les flux transfrontaliers de données, Administration du cyberespace de Chine, mars 2024
- Gemini API Additional Terms of Service, Google, mis à jour en avril 2026
- Enterprise privacy: Our commitments, OpenAI, consulté en novembre 2026
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025, Andreessen Horowitz (a16z), juin 2025


