很多企业谈 AI,先讨论的是选哪个模型、买哪款工具。但真正动手后才发现,卡住项目的往往是另一件事:客户资料重复、产品编码不统一、关键数据散落在各人的表格里,没人说得清哪个数字是对的。AI 落地的第一道门槛通常不是模型,而是数据:数据不准、不全、找不到,或者没人负责。
那么,企业在推进 AI 之前,究竟要先把哪些数据理好?本文将介绍为什么 AI 项目的瓶颈常常在数据、企业里最常见的五类数据问题、“AI 就绪的数据”应具备的条件,从一个业务场景出发准备数据的七个步骤,以及如何用简单的指标判断数据是否准备到位,最后回答几个常见问题。
为什么 AI 项目的瓶颈常常在数据?
AI 的输出质量取决于它能看到的数据。数据中的错误、缺口和矛盾,不会被 AI 自动纠正,反而会被它以更快的速度、更大的规模放大。
多项调查都指向同一个问题:
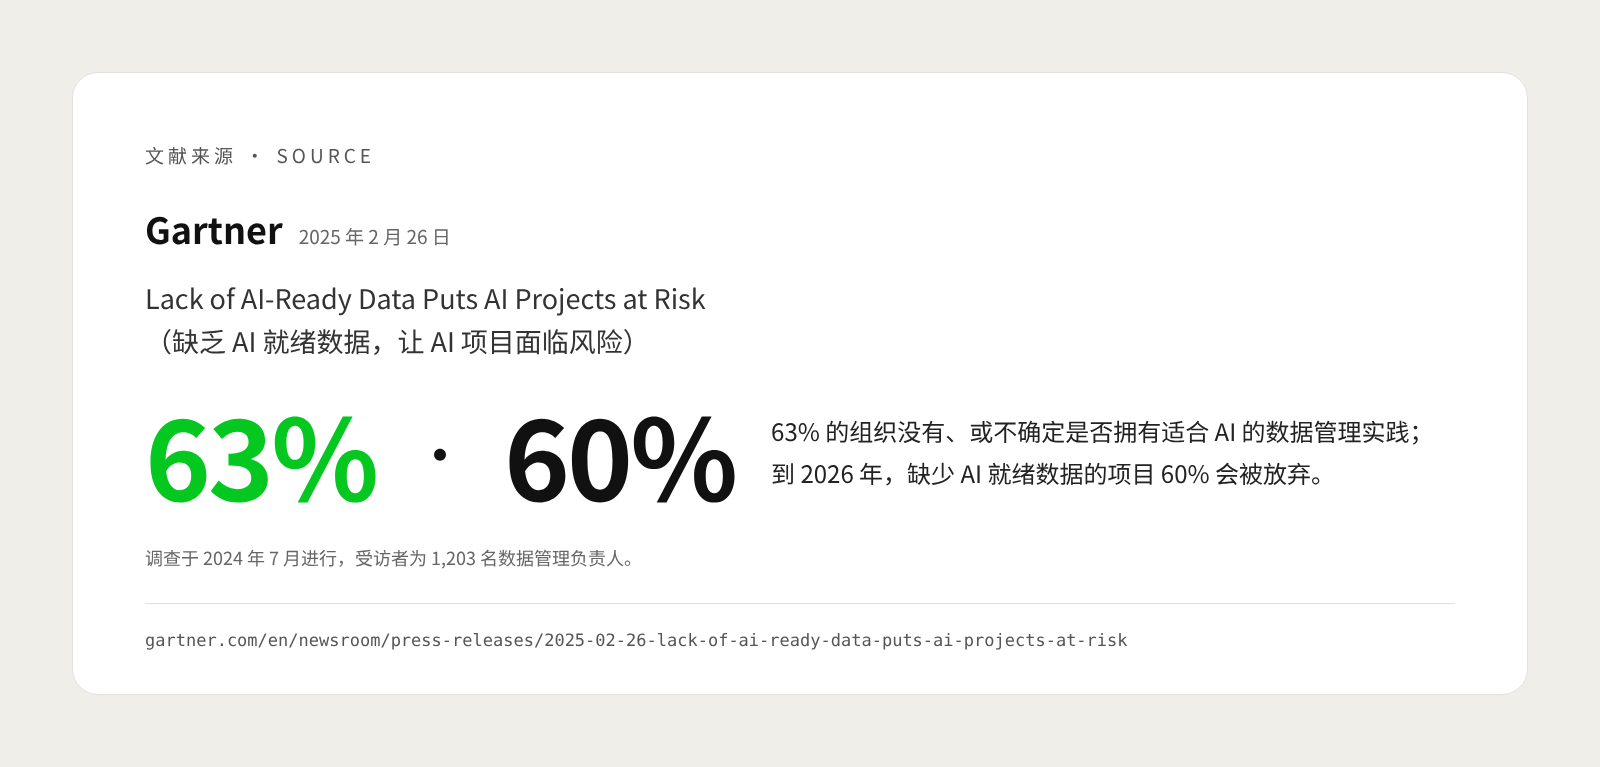
- 多数企业的数据管理还没跟上。 Gartner 2025 年 2 月发布的调查显示,在 2024 年 7 月受访的 1,203 名数据管理负责人中,63% 表示所在组织不具备适合 AI 的数据管理实践,或者不确定是否具备。Gartner 同时预测,到 2026 年,缺少“AI 就绪数据”支撑的 AI 项目中,60% 会被企业放弃(来源)。
- 成熟企业同样绕不开数据。 Gartner 2024 年第四季度对美国、英国、法国、德国、印度和日本 432 名受访者的调查发现,无论 AI 成熟度高低,数据的可用性和质量都是 AI 实施的首要挑战之一:低成熟度组织中有 34% 的负责人这样认为,高成熟度组织中也有 29%(来源)。
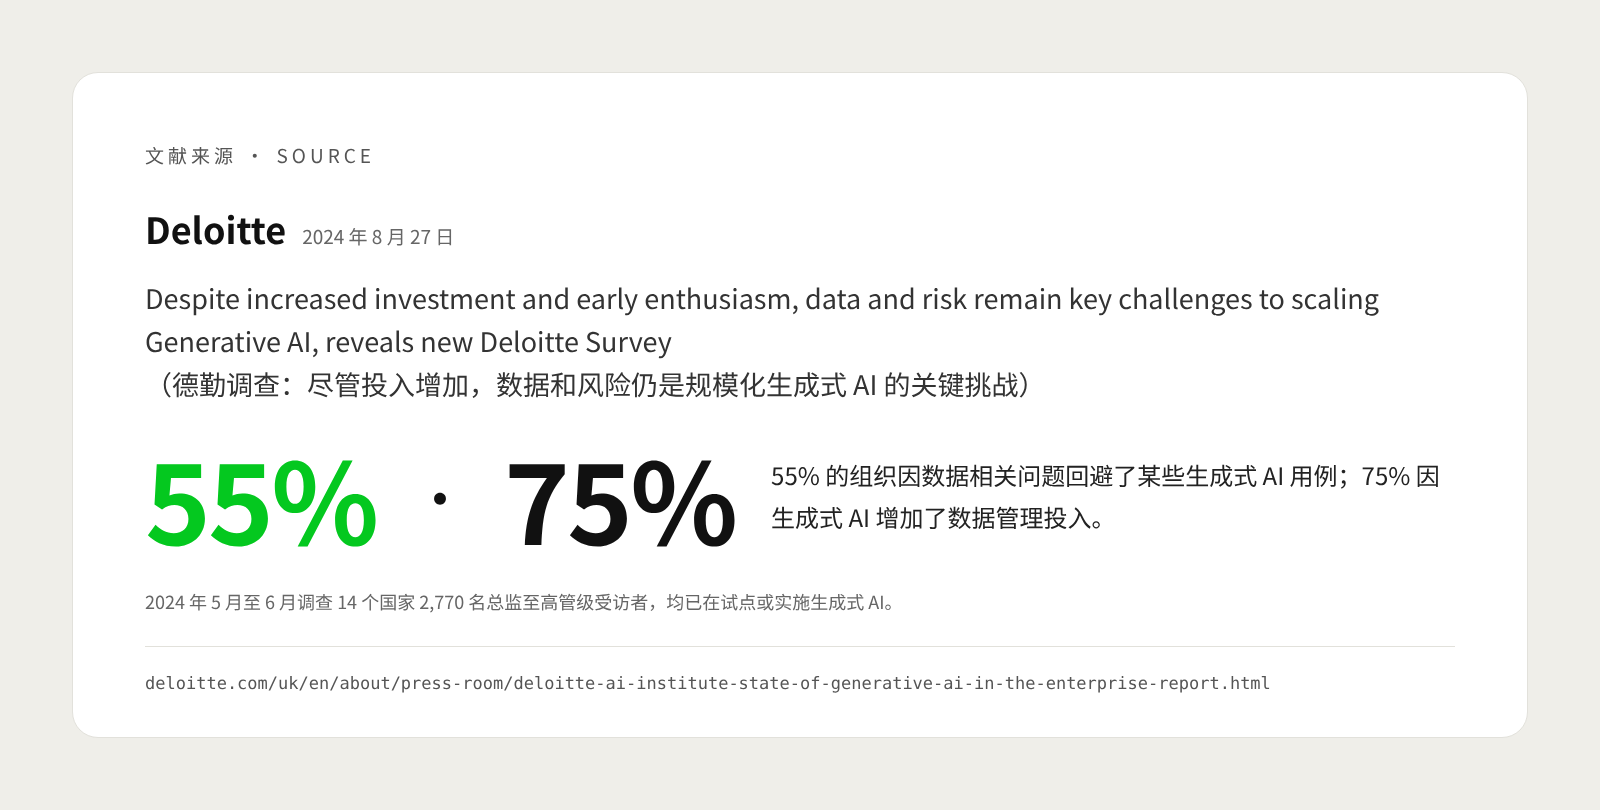
- 数据问题直接缩小了 AI 的使用范围。 德勤 2024 年 5 月至 6 月对 14 个国家 2,770 名总监至高管级受访者的调查显示,55% 的组织因为数据相关问题而回避了某些生成式 AI 用例;75% 的组织因生成式 AI 增加了数据管理方面的投入(来源)。需要注意,这项调查的受访者都具备 AI 经验、且已在试点或实施生成式 AI,比一般企业走得更远。
为什么数据问题在 AI 项目里格外突出?原因有两点。第一,传统报表出错时,看报表的人往往能凭经验发现“这个数不对”;而 AI 会直接基于错误的数据给出建议,甚至自动执行操作。第二,AI 对数据的要求更“挑剔”。Gartner 指出,AI 就绪的数据必须能代表具体的使用场景,包括其中的各种规律、错误、异常值和意外情况(来源)。
例如,一家分销企业想用 AI 预测各仓库的补货量。如果历史销售里混着大量退货冲销、缺货期间的零销量被当成“没有需求”,模型学到的就是一套错误的规律,预测越“自信”,补货偏差越大。
企业里最常见的数据问题有哪些?
大多数企业的数据问题并不神秘,而是长期积累下来的日常管理问题。这些问题平时只是“麻烦”,到了 AI 项目里就会变成“障碍”。
同一客户有多种写法。 销售录入“华东某某贸易有限公司”,财务录入“某某贸易(上海)”,客服系统里又是一个联系人手机号。例如,AI 在分析客户价值时,可能把一个年采购额很高的大客户拆成三个普通客户,信用额度和优惠政策也随之出错。
主数据不统一。 主数据(Master Data)指客户、供应商、产品、物料、员工等相对稳定、被多个流程共用的基础数据。例如,同一款产品在销售系统、仓库和财务里各有一套编码,AI 想回答“这款产品的真实毛利是多少”,就要先猜哪几个编码是同一件东西。
数据散落在表格和不同系统里。 价格表在采购主管的电脑上,促销规则在邮件附件里,门店的库存调整记录在聊天群中。这些数据 AI 既访问不到,也分不清哪个版本是最新的。
口径不一致。 不同部门对同一个指标的理解不同。例如,销售部的“销售额”含税、不扣退货,财务部的“销售额”不含税、已扣退货;“准时交付”有人按承诺日期算,有人按客户要求日期算。AI 在两套口径之间给出的答案,注定有一方认为是错的。
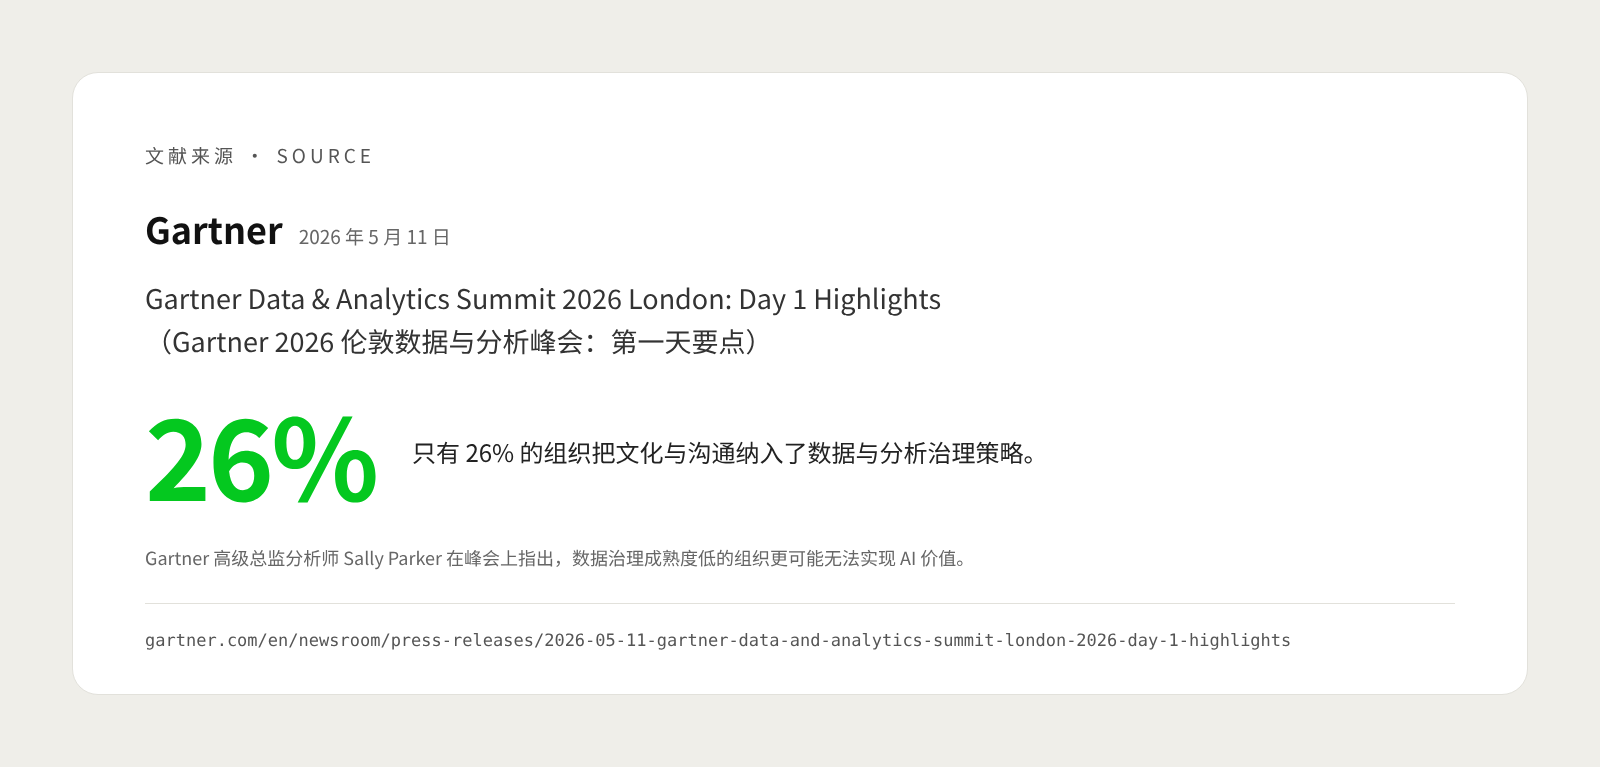
没有人对数据负责。 发现客户地址错了、产品规格过期了,却不知道该找谁改;每个部门都在用数据,但没有人对它的准确性负责。Gartner 高级总监分析师 Sally Parker 在 2026 年 5 月的伦敦数据与分析峰会上指出,数据治理成熟度低的组织明显更可能无法实现 AI 的价值;同一场分享中还提到,只有 26% 的组织把文化与沟通纳入了数据与分析治理策略(来源)。这说明,数据管理不只是技术问题,更是分工和习惯的问题。
什么样的数据才算“AI 就绪”?
“AI 就绪”不是指企业所有数据都完美无缺,而是指支撑某个具体 AI 场景的那部分数据达到了可用的标准。判断数据是否就绪,要从场景出发,而不是从数据库出发。
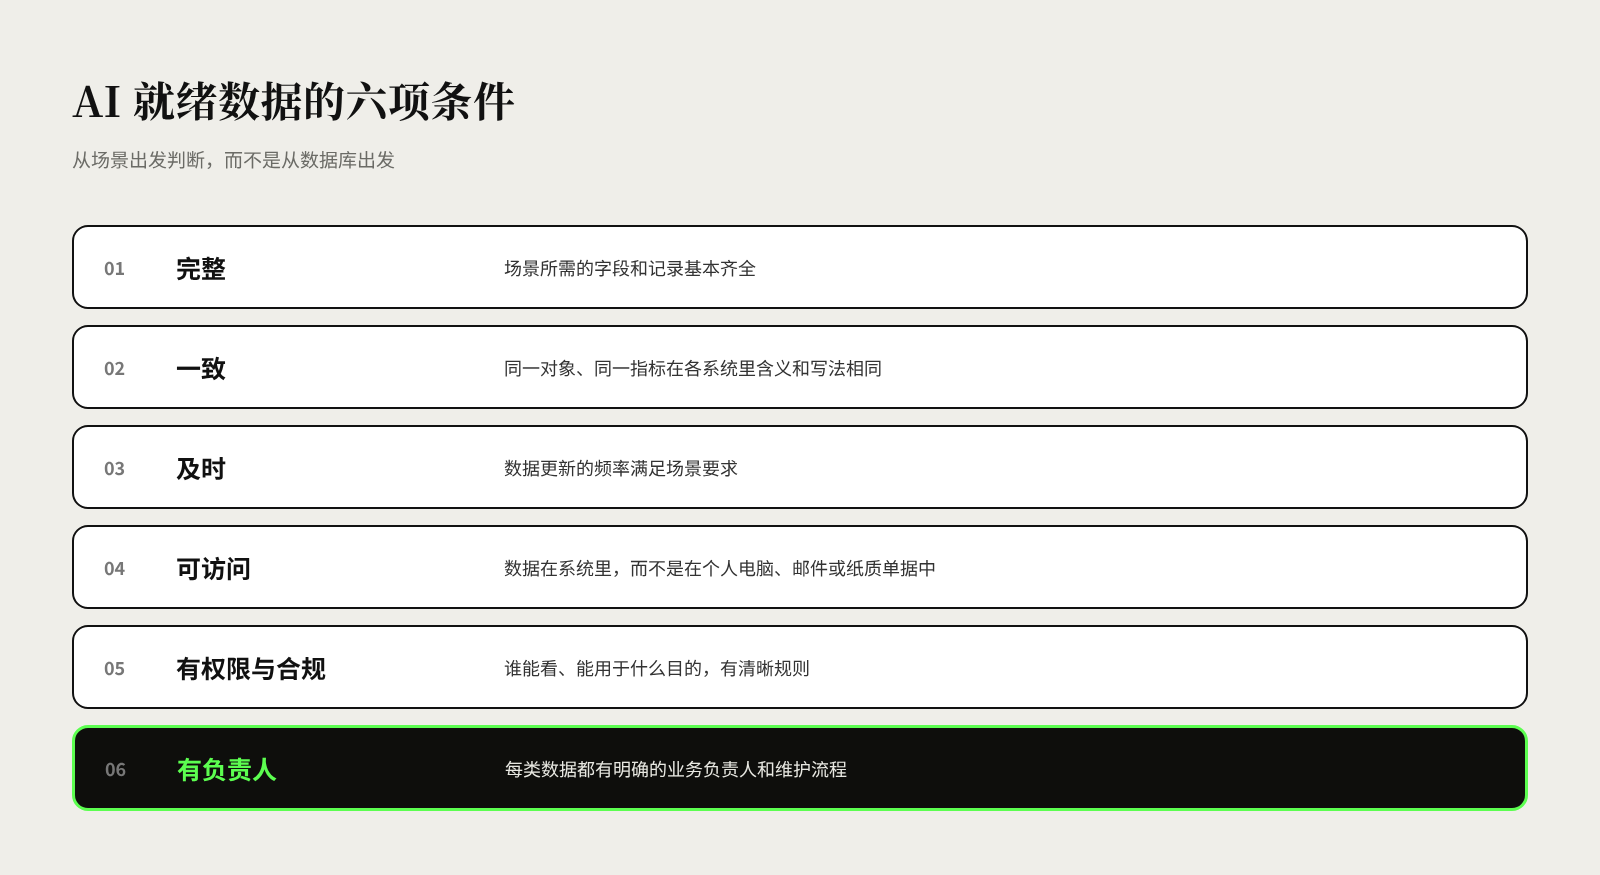
下表列出了 AI 就绪数据通常需要满足的六项条件,可作为自查清单:
| 条件 | 含义 | 自查问题 | 常见反例 |
|---|---|---|---|
| 完整 | 场景所需的字段和记录基本齐全 | 关键字段的缺失比例是多少? | 三成订单没有填写客户行业 |
| 一致 | 同一对象、同一指标在各系统里含义和写法相同 | 同一客户、同一产品是否只有一个标识? | 一个客户在三个系统里有三个名称 |
| 及时 | 数据更新的频率满足场景要求 | 数据多久更新一次,AI 用的是不是最新版本? | 库存每晚才同步,白天的 AI 回答总是滞后 |
| 可访问 | 数据存放在可被系统读取的位置和格式中 | 数据是否在系统里,而不是在个人电脑、邮件或纸质单据中? | 价格政策只存在于某个主管的表格里 |
| 有权限与合规 | 谁能看、能用于什么目的,有清晰规则 | 是否涉及个人信息?使用目的是否合规? | 把含客户手机号的完整名单直接发给外部 AI 工具 |
| 有负责人 | 每类数据都有明确的业务负责人和维护流程 | 数据出错时,知道找谁、多久能改好吗? | 产品资料由谁更新“看情况” |
表中的条件需要按场景确定标准。例如,用 AI 起草营销文案时,对数据及时性要求不高;而用 AI 回答客户的库存和交期询问,数据就必须接近实时。
还有两点值得注意。第一,Gartner 强调,数据就绪是一个依靠元数据(描述数据的数据,如字段含义、来源、更新时间)来对齐、校验和管理数据的过程,而不是“一次性完成”的任务,需要持续改进(来源)。第二,合同、邮件、制度文件等非结构化数据同样需要管理:过期的制度文件如果仍在知识库里,AI 客服就可能按旧政策回答客户。
如何为 AI 准备数据?分步指南
为 AI 准备数据,最有效的做法不是先做一个覆盖全公司的“数据大工程”,而是围绕一个具体场景,把相关数据理到可用。先让一个场景的数据达标,再把方法复制到下一个场景。
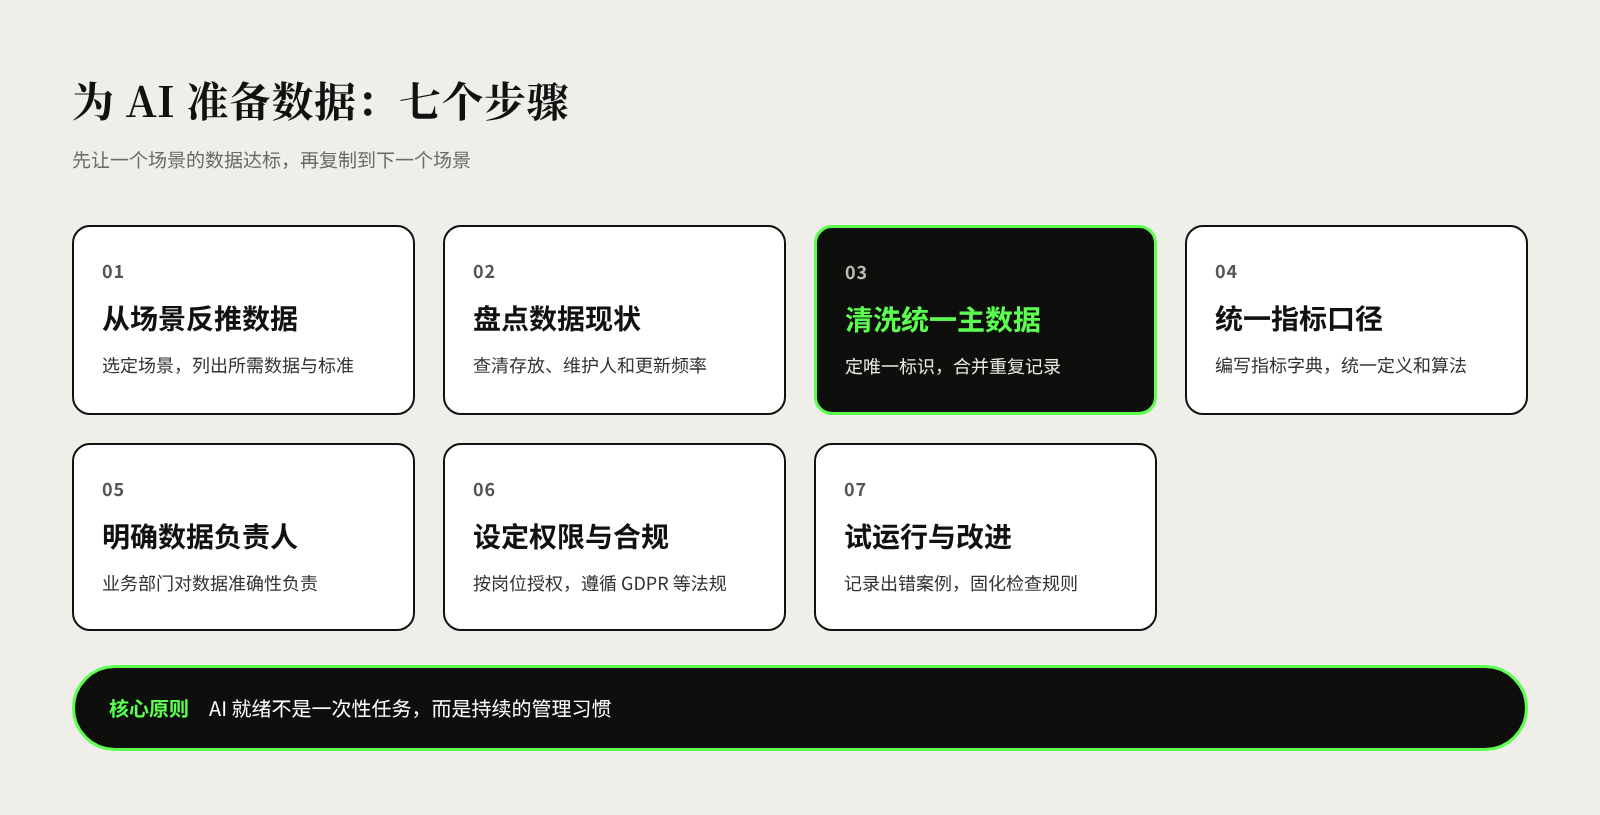
第 1 步:从一个业务场景反推需要的数据。 先选一个价值明确的场景,再列出它需要哪些数据。例如,用 AI 自动核对供应商发票,需要采购订单、收货记录、发票、供应商资料和合同价格。列清单时,同时写下每类数据要达到什么标准。
第 2 步:盘点数据现状。 针对清单逐项确认:数据存放在哪个系统或文件里、由谁维护、多久更新一次、格式是什么。再抽取一部分样本检查质量,例如抽 200 张发票,看有多少能和订单、收货记录对上。盘点的产出是一份数据清单和问题清单。
第 3 步:清洗并统一主数据。 优先处理场景依赖最大的主数据,通常是客户、产品和供应商。先定规则,例如客户以统一社会信用代码或税号为唯一标识,再合并重复记录、补齐关键字段。更重要的是从源头控制:新增客户或产品时,必须按统一规则录入并经过审核,否则清洗完不久又会变乱。
第 4 步:统一指标口径。 把场景涉及的关键指标写成一份“指标字典”,说明每个指标的定义、计算方法、数据来源和负责人。例如,明确“毛利”是否扣除运费和返利。口径一旦确定,报表、看板和 AI 都使用同一份定义。
第 5 步:建立数据负责人和更新机制。 每类关键数据都应指定一位业务部门的负责人,例如客户资料归销售运营,产品资料归产品或采购部门,由他们对准确性负责。同时约定更新频率、质量检查方式和问题反馈渠道,让发现错误的人知道该找谁。
第 6 步:设定权限,确保合规。 按岗位设定谁能查看和使用哪些数据,涉及个人信息时尤其要谨慎。以欧盟《通用数据保护条例》(GDPR)为例,第 5 条要求个人数据的处理遵循合法公平透明、目的限制、数据最小化、准确性、存储期限限制、完整性与保密性等原则,并由数据控制者对合规负责、能够证明合规;第 25 条要求在设计阶段和默认设置中就落实数据保护,例如采用假名化、默认只处理必要的个人数据(来源)。在中国等其他地区经营的企业,也应对照当地的个人信息保护法规。实际操作中,向外部 AI 工具提供数据前,应先去除或替换不必要的个人信息。
第 7 步:小范围试运行,持续改进。 数据准备好后,先在小范围内运行 AI 场景,记录 AI 出错的案例,追查是数据问题还是模型问题。把发现的数据问题交给对应的负责人修正,并把检查规则固定下来。这样,第二个场景可以复用已经理好的主数据和指标字典,准备时间会明显缩短。
如何判断数据准备是否到位?
判断数据是否准备到位,不能只凭感觉,也不能等 AI 上线后看效果再说。最实用的办法,是为场景涉及的关键数据设几个简单、可定期统计的质量指标。
可以从以下几个方面入手:
- 重复率。 客户、产品、供应商中疑似重复的记录占多少。例如,每月统计一次名称相近、税号相同的客户记录数量,看是否在下降。
- 缺失率。 场景所需的关键字段有多少是空的,例如订单的交货地址、产品的规格和单位。
- 一致率。 同一数据在不同系统之间能否对上,例如 ERP 中的库存与仓库系统的库存差异,或订单金额与发票金额的差异。
- 更新延迟。 业务发生后多久能在系统里看到,例如门店的销售多久同步到总部、价格调整多久生效。
- 问题处理时长。 数据问题从发现到修正需要几天,有没有积压的问题没人处理。
这些指标不需要复杂的工具,起步阶段用一张每月更新的表格就能跟踪。关键是指标要有负责人、有目标值,并在管理例会上定期查看。例如,一家连锁餐饮企业准备用 AI 分析各门店的食材损耗时,先把“门店报损记录的缺失率”和“报损录入延迟”作为两个指标,连续跟踪两个月达标后才开始建模。指标稳定达标,才是启动 AI 场景的信号。
关于 AI 数据准备的常见问题
必须把所有数据都清理干净,才能开始做 AI 吗? 不必。更务实的做法是围绕一个场景,只把这个场景需要的数据理到可用。全面的数据治理可以随着场景增加逐步推进。
中小企业没有专门的数据团队,怎么办? 可以先在业务部门指定数据负责人,用简单的清单和规则管理关键数据。很多数据问题靠统一录入规则、定期检查就能明显改善,不一定需要复杂的工具。
已经上了 ERP 或 CRM,数据是不是就 AI 就绪了? 不一定。系统只是提供了存放数据的地方,数据是否完整、一致、有人维护,取决于日常管理。另外,AI 场景常常需要把多个系统的数据结合起来,口径统一仍然必不可少。
数据准备工作应该由业务部门还是 IT 部门牵头? 应由业务部门牵头、IT 部门支持。数据的含义和对错只有业务人员最清楚,IT 部门则负责系统、接口和权限等技术实现。两者缺一不可。
把企业数据交给外部 AI 工具安全吗? 关键在于事先评估。应确认服务商如何存储和使用数据、是否会用于训练模型,并去除不必要的个人信息和敏感商业信息。涉及个人数据时,还要确认使用目的符合 GDPR 等适用法规的要求。
参考资料
- Lack of AI-Ready Data Puts AI Projects at Risk,Gartner,2025 年 2 月
- Gartner Survey Finds 45% of Organizations With High AI Maturity Keep AI Projects Operational for at Least Three Years,Gartner,2025 年 6 月
- Gartner Data & Analytics Summit 2026 London: Day 1 Highlights,Gartner,2026 年 5 月
- Despite increased investment and early enthusiasm, data and risk remain key challenges to scaling Generative AI, reveals new Deloitte Survey,Deloitte,2024 年 8 月
- Regulation (EU) 2016/679 (General Data Protection Regulation),欧盟官方公报(EUR-Lex),2016 年 4 月


