Cuando muchas empresas hablan de IA, lo primero que discuten es qué modelo elegir y qué herramienta comprar. Pero al ponerse manos a la obra descubren que lo que bloquea el proyecto suele ser otra cosa: datos de clientes duplicados, códigos de producto sin unificar, datos clave dispersos en las hojas de cálculo de cada persona y nadie capaz de decir qué cifra es la correcta. El primer obstáculo para implantar IA no suele ser el modelo, sino los datos: inexactos, incompletos, imposibles de encontrar o sin nadie que se responsabilice de ellos.
Entonces, ¿qué datos debe poner en orden una empresa antes de avanzar con la IA? Este artículo explica por qué el cuello de botella de los proyectos de IA suele estar en los datos, los cinco tipos de problemas de datos más habituales en las empresas, las condiciones que deben cumplir los «datos listos para IA», los siete pasos para preparar los datos a partir de un caso de uso de negocio y cómo comprobar con indicadores sencillos si los datos están bien preparados, y termina respondiendo a varias preguntas frecuentes.
¿Por qué el cuello de botella de los proyectos de IA suele estar en los datos?
La calidad de lo que produce la IA depende de los datos que es capaz de ver. Los errores, las lagunas y las contradicciones de los datos no los corrige la IA por sí sola; al contrario, los amplifica, más rápido y a mayor escala.
Varias encuestas apuntan al mismo problema:
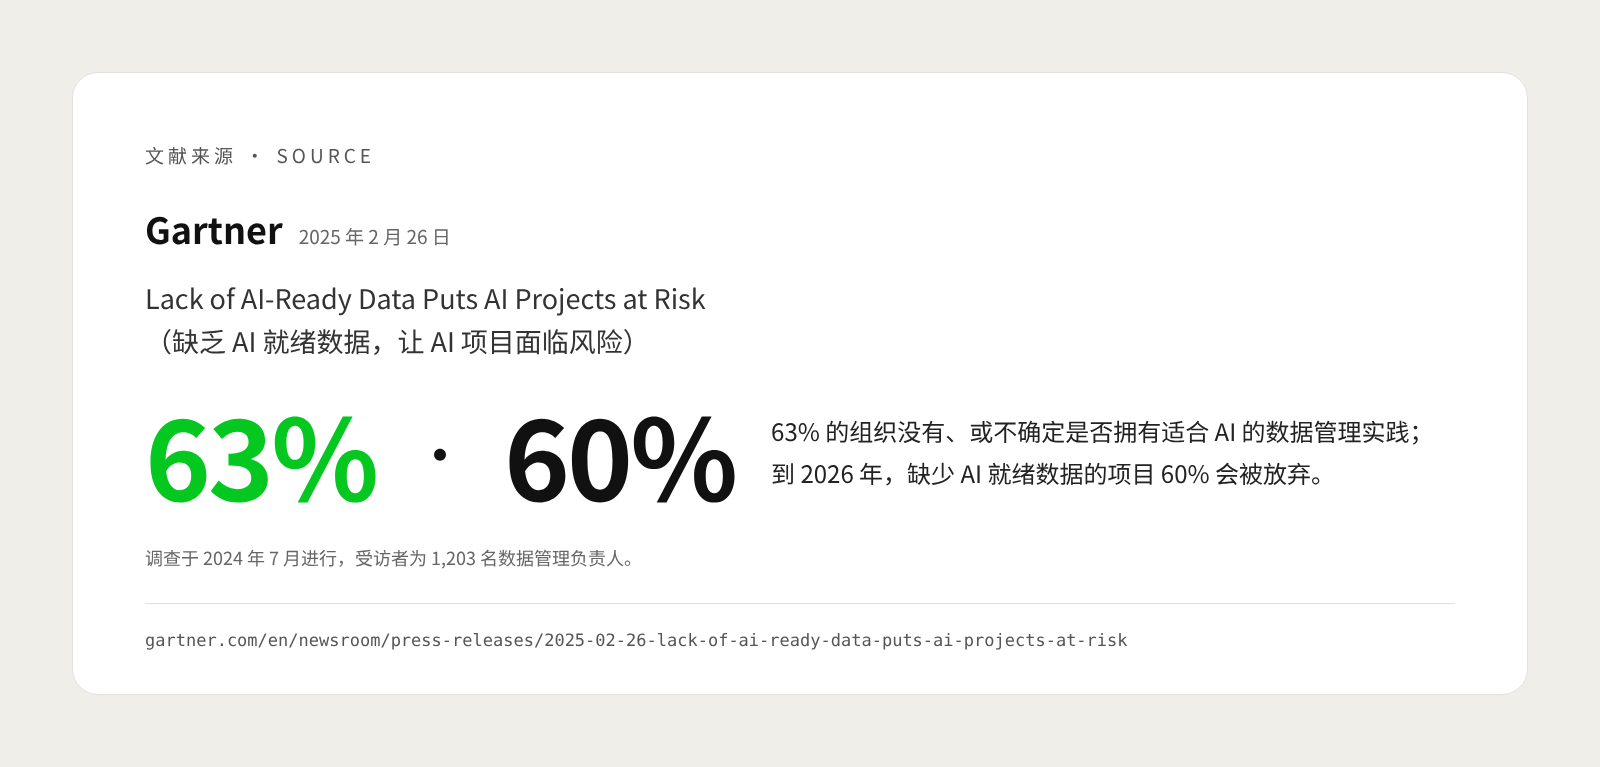
- La gestión de datos de la mayoría de las empresas aún no está a la altura. Según una encuesta de Gartner publicada en febrero de 2025, entre los 1.203 responsables de gestión de datos consultados en julio de 2024, el 63 % afirmó que su organización no cuenta con las prácticas de gestión de datos adecuadas para la IA, o que no está seguro de contar con ellas. Gartner prevé además que, de aquí a 2026, las organizaciones abandonarán el 60 % de los proyectos de IA que no cuenten con el respaldo de «datos listos para IA» (fuente).
- Las empresas maduras tampoco se libran de los datos. Una encuesta de Gartner del cuarto trimestre de 2024 a 432 participantes de Estados Unidos, Reino Unido, Francia, Alemania, India y Japón concluyó que, con independencia del grado de madurez en IA, la disponibilidad y la calidad de los datos son uno de los principales desafíos de la implantación de IA: así lo señaló el 34 % de los responsables de organizaciones con baja madurez y también el 29 % de los de organizaciones con alta madurez (fuente).
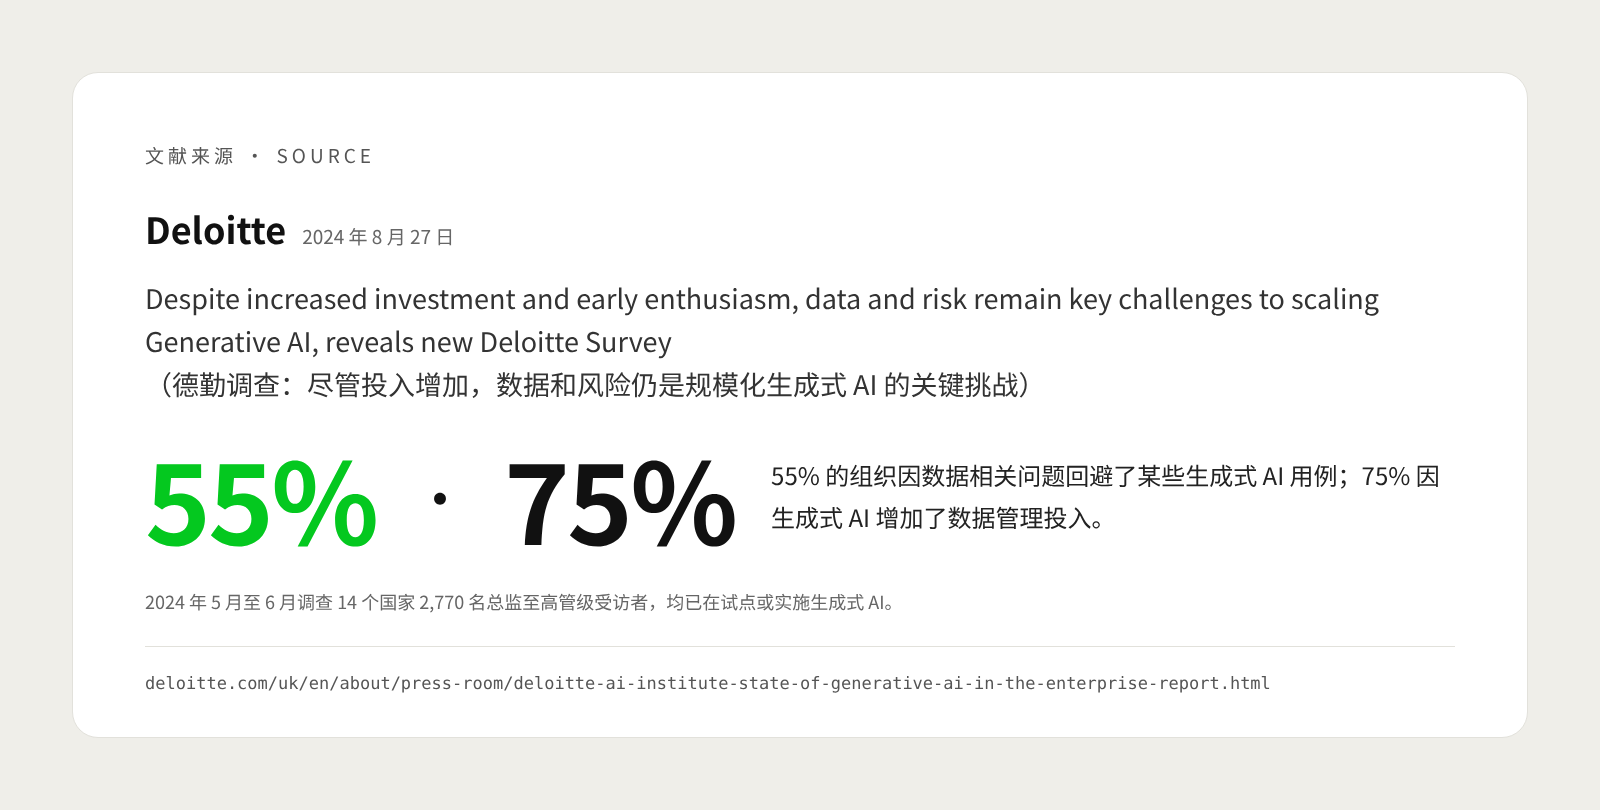
- Los problemas de datos reducen directamente el alcance del uso de la IA. Una encuesta de Deloitte realizada entre mayo y junio de 2024 a 2.770 encuestados de nivel director a ejecutivo en 14 países mostró que el 55 % de las organizaciones evitó ciertos casos de uso de IA generativa por problemas relacionados con los datos, y que el 75 % aumentó su inversión en gestión de datos a causa de la IA generativa (fuente). Conviene tener en cuenta que todos los encuestados tenían experiencia en IA y ya estaban pilotando o implantando IA generativa, de modo que van más avanzados que la empresa media.
¿Por qué los problemas de datos pesan tanto en los proyectos de IA? Hay dos razones. La primera: cuando un informe tradicional contiene un error, quien lo lee suele darse cuenta por experiencia de que «esta cifra no cuadra»; la IA, en cambio, formula recomendaciones directamente a partir de datos erróneos e incluso puede ejecutar acciones de forma automática. La segunda: la IA es más «exigente» con los datos. Gartner señala que los datos listos para IA deben ser representativos del caso de uso concreto, con todos sus patrones, errores, valores atípicos y situaciones inesperadas (fuente).
Por ejemplo, una empresa de distribución quiere usar IA para predecir las necesidades de reposición de cada almacén. Si en las ventas históricas se mezclan muchas anulaciones por devoluciones y las ventas cero de los periodos sin stock se interpretan como «ausencia de demanda», lo que el modelo aprende es un patrón equivocado: cuanto más «segura» sea la previsión, mayor será la desviación en la reposición.
¿Cuáles son los problemas de datos más habituales en las empresas?
La mayoría de los problemas de datos de las empresas no tienen nada de misterioso: son problemas cotidianos de gestión acumulados durante años. Normalmente son una simple «molestia», pero en un proyecto de IA se convierten en «obstáculos».
Un mismo cliente escrito de varias maneras. Ventas registra «Comercial Fulano, S. L. (zona este)», finanzas registra «Fulano Comercial (Shanghái)» y en el sistema de atención al cliente aparece además un contacto con un número de móvil. Por ejemplo, al analizar el valor de los clientes, la IA puede dividir en tres clientes corrientes a un gran cliente con un volumen de compra anual elevado, y con ello también se falsean el límite de crédito y las condiciones comerciales.
Datos maestros sin unificar. Los datos maestros (Master Data) son los datos básicos relativamente estables y compartidos por varios procesos: clientes, proveedores, productos, materiales, empleados, etc. Por ejemplo, si un mismo producto tiene un código distinto en el sistema de ventas, en el almacén y en finanzas, para responder a «¿cuál es el margen bruto real de este producto?» la IA tendrá que empezar por adivinar qué códigos corresponden a lo mismo.
Datos dispersos entre hojas de cálculo y sistemas distintos. La lista de precios está en el ordenador del responsable de compras, las reglas de las promociones en un archivo adjunto de un correo y los ajustes de inventario de las tiendas en un grupo de chat. La IA ni puede acceder a esos datos ni distinguir cuál es la versión más reciente.
Criterios sin homogeneizar. Cada departamento entiende de forma distinta el mismo indicador. Por ejemplo, las «ventas» de comercial incluyen impuestos y no descuentan las devoluciones, mientras que las «ventas» de finanzas excluyen impuestos y ya descuentan las devoluciones; en la «entrega puntual», unos calculan según la fecha prometida y otros según la fecha solicitada por el cliente. Entre dos criterios así, la respuesta de la IA siempre será considerada errónea por alguna de las partes.
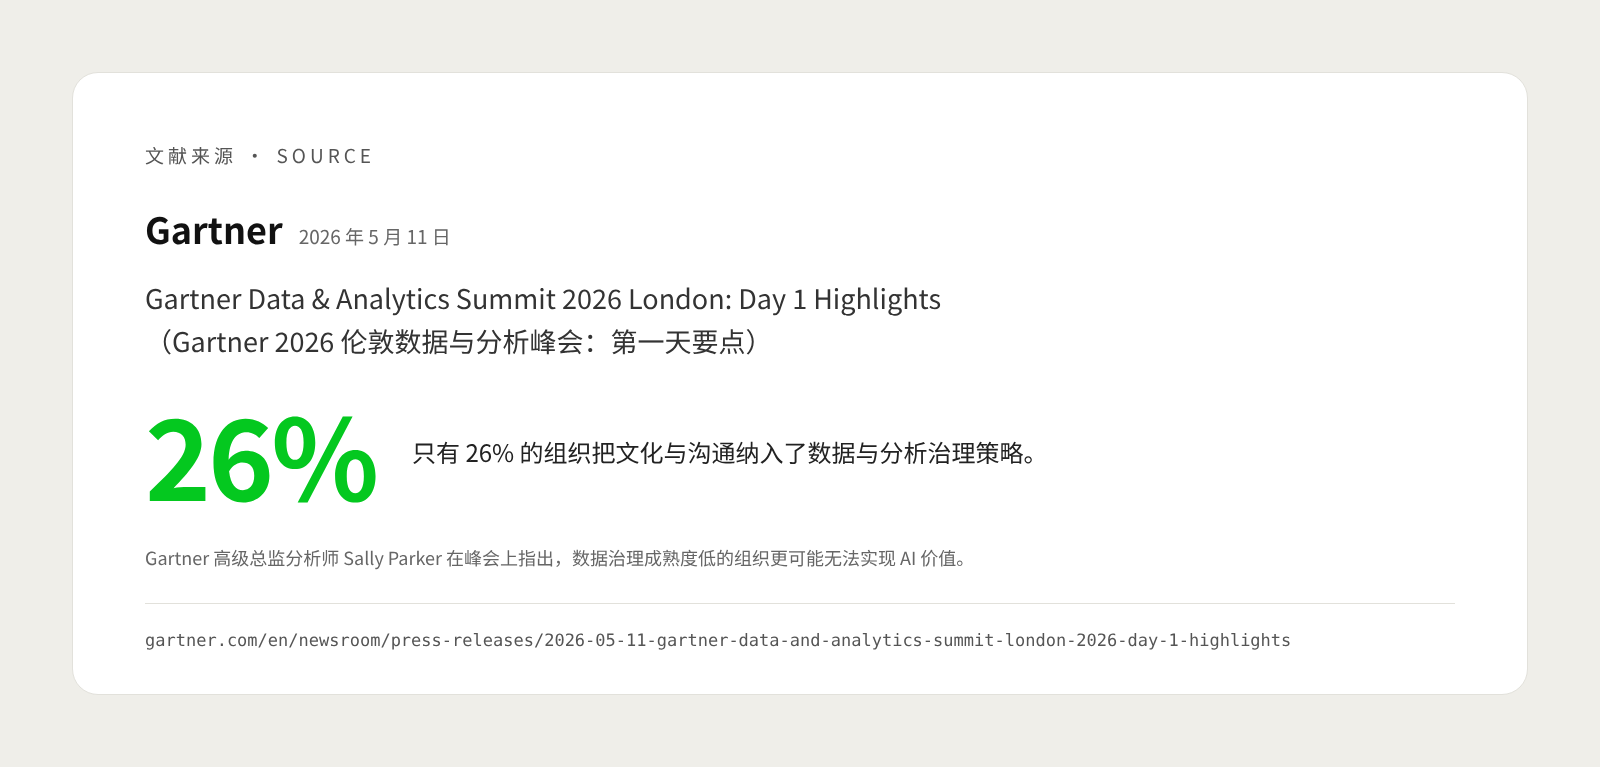
Nadie se responsabiliza de los datos. Se detecta que la dirección de un cliente es incorrecta o que las especificaciones de un producto han caducado, pero no se sabe a quién pedirle que lo corrija; todos los departamentos usan los datos, pero nadie responde de su exactitud. Sally Parker, directora senior analista de Gartner, señaló en la Gartner Data & Analytics Summit de Londres, en mayo de 2026, que las organizaciones con baja madurez en gobierno del dato tienen muchas más probabilidades de no lograr el valor de la IA; en la misma intervención se indicó que solo el 26 % de las organizaciones incluye la cultura y la comunicación en su estrategia de gobierno de datos y análisis (fuente). Esto demuestra que la gestión de datos no es solo un asunto técnico, sino también de reparto de responsabilidades y de hábitos.
¿Qué datos pueden considerarse «listos para IA»?
«Listos para IA» no significa que todos los datos de la empresa sean perfectos, sino que la parte de los datos que sustenta un caso de uso de IA concreto alcanza un estándar utilizable. Para saber si los datos están listos hay que partir del caso de uso, no de la base de datos.
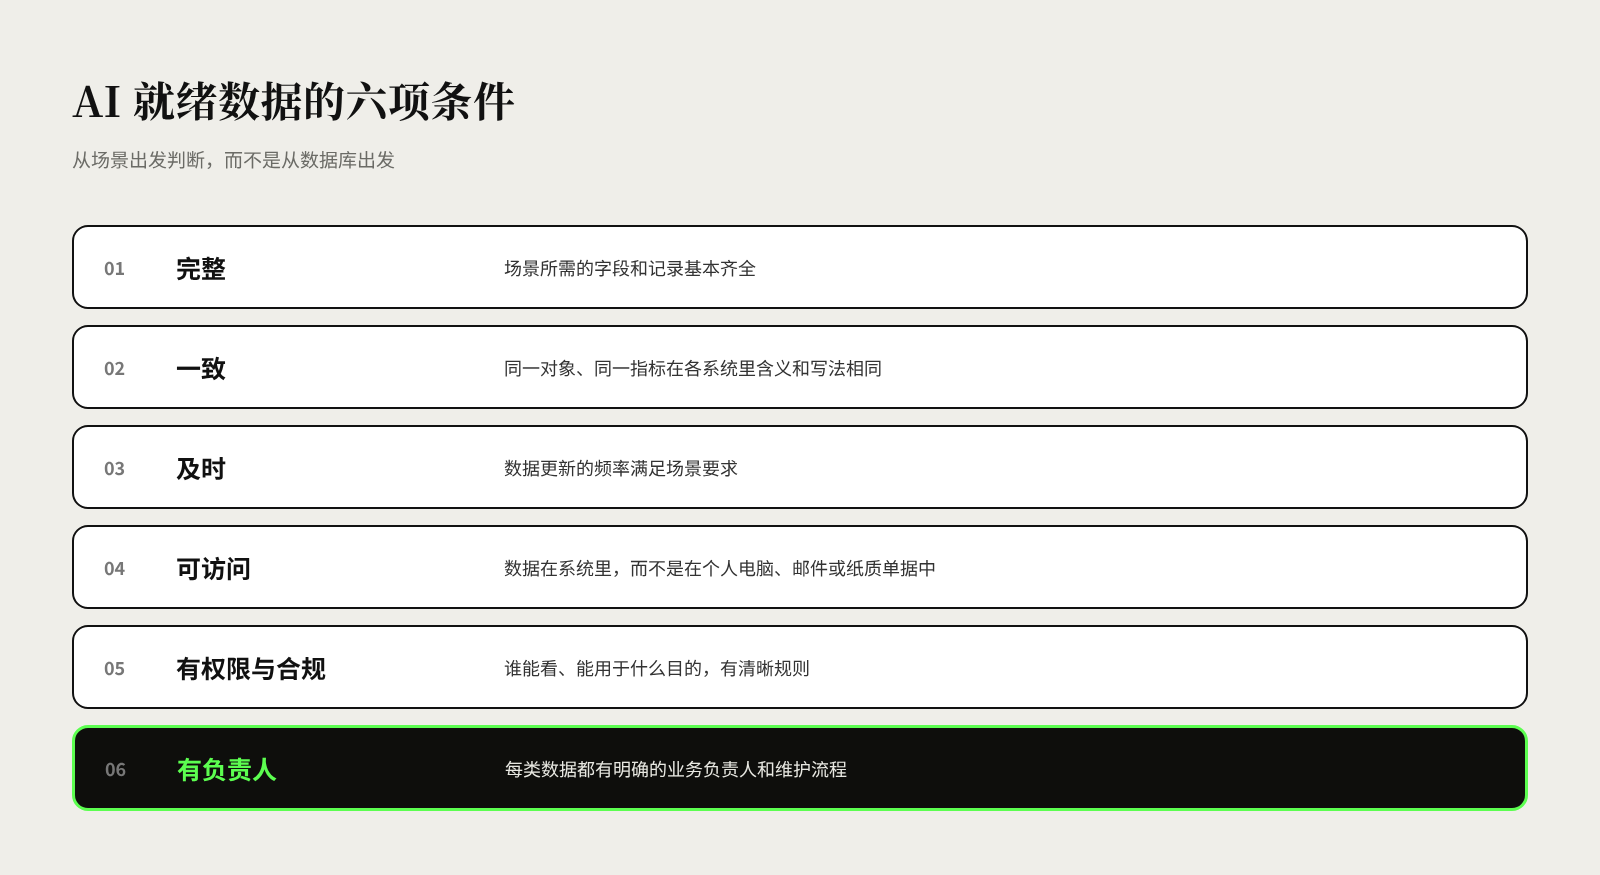
La siguiente tabla recoge las seis condiciones que suelen cumplir los datos listos para IA y puede servir como lista de autoevaluación:
| Condición | Significado | Pregunta de autoevaluación | Contraejemplo habitual |
|---|---|---|---|
| Completos | Los campos y registros que necesita el caso de uso están básicamente completos | ¿Qué porcentaje de los campos clave falta? | El 30 % de los pedidos no tiene indicado el sector del cliente |
| Coherentes | El mismo objeto o el mismo indicador tiene el mismo significado y la misma forma de escribirse en todos los sistemas | ¿Cada cliente y cada producto tienen un único identificador? | Un cliente tiene tres nombres en tres sistemas |
| Actualizados | La frecuencia de actualización cumple los requisitos del caso de uso | ¿Cada cuánto se actualizan los datos? ¿La IA usa la versión más reciente? | El inventario se sincroniza solo por la noche, así que las respuestas de la IA durante el día siempre van retrasadas |
| Accesibles | Los datos están en una ubicación y un formato que los sistemas pueden leer | ¿Están los datos en el sistema, y no en ordenadores personales, correos o documentos en papel? | La política de precios solo existe en la hoja de cálculo de un responsable |
| Con permisos y conformes a la normativa | Existen reglas claras sobre quién puede verlos y para qué finalidad pueden usarse | ¿Incluyen datos personales? ¿La finalidad de uso es conforme a la normativa? | Enviar a una herramienta de IA externa la lista completa con los móviles de los clientes |
| Con responsable | Cada tipo de dato tiene un responsable de negocio claro y un proceso de mantenimiento | Cuando hay un error en los datos, ¿sabes a quién acudir y cuánto tardará en corregirse? | Quién actualiza los datos de producto es algo que «depende» |
Los criterios de la tabla deben fijarse según cada caso de uso. Por ejemplo, para redactar textos de marketing con IA, la exigencia de actualización de los datos es baja; en cambio, para que la IA responda a las consultas de clientes sobre inventario y plazos de entrega, los datos tienen que ser casi en tiempo real.
Hay además dos cuestiones que conviene tener presentes. La primera: Gartner subraya que la preparación de los datos es un proceso que se apoya en los metadatos (datos que describen los datos, como el significado de los campos, su origen o la fecha de actualización) para alinear, validar y gestionar los datos, y no una tarea «que se hace una sola vez»; requiere mejora continua (fuente). La segunda: los datos no estructurados, como contratos, correos y documentos de políticas, también necesitan gestión: si en la base de conocimiento siguen estando documentos de políticas caducados, la IA de atención al cliente puede responder a los clientes conforme a la política antigua.
¿Cómo preparar los datos para la IA? Guía paso a paso
La forma más eficaz de preparar los datos para la IA no es empezar por un «gran proyecto de datos» que abarque toda la empresa, sino centrarse en un caso de uso concreto y poner en orden los datos relacionados hasta dejarlos utilizables. Primero se llevan al nivel exigido los datos de un caso de uso y después se replica el método en el siguiente.
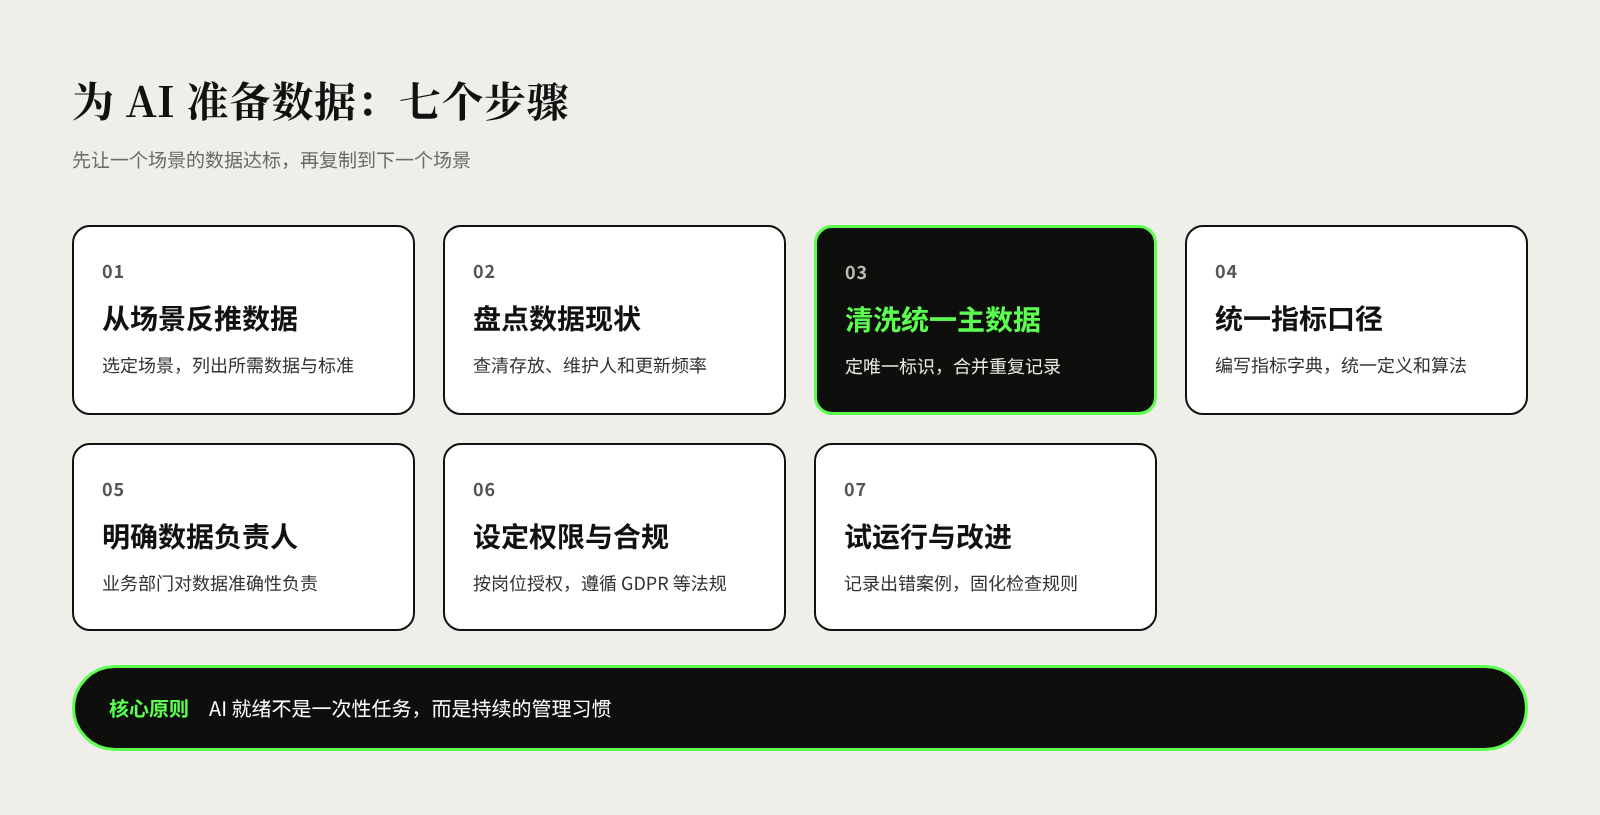
Paso 1: deduce los datos necesarios a partir de un caso de uso de negocio. Elige primero un caso de uso con un valor claro y después enumera qué datos necesita. Por ejemplo, para usar IA en la conciliación automática de facturas de proveedores, hacen falta pedidos de compra, registros de recepción, facturas, datos de proveedores y precios de contrato. Al elaborar la lista, anota también qué estándar debe alcanzar cada tipo de dato.
Paso 2: inventaría la situación de los datos. Con la lista en la mano, confirma uno por uno en qué sistema o archivo están los datos, quién los mantiene, cada cuánto se actualizan y en qué formato están. Después, extrae una parte como muestra para comprobar la calidad; por ejemplo, toma 200 facturas y mira cuántas se pueden casar con los pedidos y los registros de recepción. El resultado del inventario es una lista de datos y una lista de problemas.
Paso 3: depura y unifica los datos maestros. Trata primero los datos maestros de los que más depende el caso de uso, que normalmente son clientes, productos y proveedores. Empieza por fijar reglas, por ejemplo que el identificador único del cliente sea el código de identificación fiscal; después fusiona los registros duplicados y completa los campos clave. Lo más importante es controlarlo desde el origen: al dar de alta un cliente o un producto, hay que introducirlo siguiendo las reglas unificadas y pasar por una revisión; de lo contrario, poco después de la depuración volverá a desordenarse.
Paso 4: unifica los criterios de los indicadores. Recoge los indicadores clave del caso de uso en un «diccionario de indicadores» que explique la definición, el método de cálculo, la fuente de datos y el responsable de cada uno. Por ejemplo, aclara si el «margen bruto» descuenta o no los costes de transporte y los rappels. Una vez fijado el criterio, los informes, los paneles y la IA utilizan la misma definición.
Paso 5: establece responsables de los datos y un mecanismo de actualización. Cada tipo de dato clave debe tener asignado un responsable del área de negocio; por ejemplo, los datos de clientes corresponden a operaciones comerciales y los datos de producto, a producto o compras, y ellos responden de su exactitud. Acuerda también la frecuencia de actualización, la forma de comprobar la calidad y el canal para comunicar incidencias, de modo que quien detecte un error sepa a quién acudir.
Paso 6: define los permisos y garantiza el cumplimiento normativo. Define por puesto quién puede consultar y usar qué datos, con especial cautela cuando haya datos personales. Tomemos como ejemplo el Reglamento General de Protección de Datos (RGPD) de la Unión Europea: su artículo 5 exige que el tratamiento de datos personales respete los principios de licitud, lealtad y transparencia, limitación de la finalidad, minimización de datos, exactitud, limitación del plazo de conservación, e integridad y confidencialidad, y que el responsable del tratamiento sea responsable del cumplimiento y capaz de demostrarlo; el artículo 25 exige aplicar la protección de datos desde el diseño y por defecto, por ejemplo mediante la seudonimización y tratando por defecto solo los datos personales necesarios (fuente). Las empresas que operan en China u otras regiones también deben tener en cuenta la normativa local de protección de datos personales. En la práctica, antes de facilitar datos a una herramienta de IA externa, hay que eliminar o sustituir la información personal que no sea necesaria.
Paso 7: prueba piloto a pequeña escala y mejora continua. Cuando los datos estén preparados, ejecuta primero el caso de uso de IA a pequeña escala, registra los casos en los que la IA se equivoca e investiga si el origen es un problema de datos o del modelo. Traslada los problemas de datos detectados a su responsable para que los corrija y deja fijadas las reglas de comprobación. Así, el segundo caso de uso podrá reutilizar los datos maestros y el diccionario de indicadores ya ordenados, y el tiempo de preparación se reducirá de forma notable.
¿Cómo saber si los datos están bien preparados?
Para saber si los datos están bien preparados no basta con la intuición, ni se puede esperar a ver los resultados una vez que la IA esté en producción. Lo más práctico es fijar, para los datos clave del caso de uso, unos cuantos indicadores de calidad sencillos que se puedan calcular periódicamente.
Puedes empezar por los siguientes aspectos:
- Tasa de duplicados. Qué proporción de los registros de clientes, productos y proveedores son presuntos duplicados. Por ejemplo, cuenta una vez al mes los registros de clientes con nombres parecidos y el mismo identificador fiscal, y comprueba si la cifra va bajando.
- Tasa de datos ausentes. Cuántos de los campos clave que necesita el caso de uso están vacíos, por ejemplo la dirección de entrega del pedido o las especificaciones y la unidad del producto.
- Tasa de coherencia. Si un mismo dato cuadra entre sistemas distintos, por ejemplo la diferencia entre el inventario del ERP y el del sistema de almacén, o entre el importe del pedido y el de la factura.
- Retraso de actualización. Cuánto tarda en verse en el sistema lo que ocurre en el negocio, por ejemplo cada cuánto se sincronizan las ventas de las tiendas con la central o cuánto tarda en aplicarse un cambio de precios.
- Tiempo de resolución de incidencias. Cuántos días pasan desde que se detecta un problema de datos hasta que se corrige, y si hay problemas acumulados de los que nadie se ocupa.
Estos indicadores no requieren herramientas complejas; al principio, una hoja de cálculo que se actualice cada mes basta para seguirlos. Lo fundamental es que cada indicador tenga un responsable y un valor objetivo, y que se revise periódicamente en las reuniones de gestión. Por ejemplo, una cadena de restauración que quería usar IA para analizar las mermas de ingredientes en cada local empezó fijando como indicadores la «tasa de datos ausentes en los registros de mermas de los locales» y el «retraso en la introducción de las mermas», y solo empezó a construir el modelo cuando ambos cumplieron el objetivo durante dos meses seguidos. Que los indicadores se mantengan de forma estable en el nivel objetivo es la señal para poner en marcha el caso de uso de IA.
Preguntas frecuentes sobre la preparación de datos para la IA
¿Hay que dejar todos los datos perfectamente limpios antes de empezar con la IA? No. Lo más realista es centrarse en un caso de uso y poner en orden, hasta dejarlos utilizables, solo los datos que ese caso necesita. El gobierno del dato a escala global puede avanzar poco a poco a medida que aumentan los casos de uso.
Una pyme sin equipo de datos propio, ¿qué puede hacer? Puede empezar designando responsables de datos en las áreas de negocio y gestionando los datos clave con listas y reglas sencillas. Muchos problemas de datos mejoran de forma notable con reglas de introducción unificadas y revisiones periódicas, sin necesidad de herramientas complejas.
Si ya tenemos un ERP o un CRM, ¿están nuestros datos listos para IA? No necesariamente. El sistema solo ofrece un lugar donde guardar los datos; que estén completos, sean coherentes y alguien los mantenga depende de la gestión diaria. Además, los casos de uso de IA suelen necesitar combinar datos de varios sistemas, por lo que la unificación de criterios sigue siendo imprescindible.
¿Quién debe liderar la preparación de datos, el área de negocio o el departamento de TI? Debe liderarla el área de negocio, con el apoyo de TI. Solo las personas de negocio saben mejor que nadie qué significan los datos y si son correctos, mientras que TI se encarga de la implementación técnica de sistemas, interfaces y permisos. Ambas partes son imprescindibles.
¿Es seguro entregar datos de la empresa a herramientas de IA externas? Depende de que se evalúe de antemano. Hay que confirmar cómo almacena y utiliza el proveedor los datos y si los usará para entrenar modelos, y eliminar la información personal y la información comercial sensible que no sea necesaria. Cuando se trate de datos personales, también hay que comprobar que la finalidad de uso cumple los requisitos de la normativa aplicable, como el RGPD.
Referencias
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, febrero de 2025
- Gartner Survey Finds 45% of Organizations With High AI Maturity Keep AI Projects Operational for at Least Three Years, Gartner, junio de 2025
- Gartner Data & Analytics Summit 2026 London: Day 1 Highlights, Gartner, mayo de 2026
- Despite increased investment and early enthusiasm, data and risk remain key challenges to scaling Generative AI, reveals new Deloitte Survey, Deloitte, agosto de 2024
- Regulation (EU) 2016/679 (General Data Protection Regulation), Diario Oficial de la Unión Europea (EUR-Lex), abril de 2016


