Wenn Unternehmen über KI sprechen, geht es zunächst meist darum, welches Modell gewählt und welches Tool gekauft werden soll. Doch sobald es an die Umsetzung geht, zeigt sich, dass oft etwas anderes das Projekt ausbremst: doppelte Kundenstammdaten, uneinheitliche Produktnummern, wichtige Daten, die in den Tabellen einzelner Personen verstreut sind, und niemand kann sagen, welche Zahl stimmt. Die erste Hürde für die KI-Einführung ist meist nicht das Modell, sondern die Datenlage: Daten sind ungenau, unvollständig, nicht auffindbar, oder niemand fühlt sich dafür verantwortlich.
Welche Daten sollten Unternehmen also in Ordnung bringen, bevor sie KI vorantreiben? In diesem Beitrag stellen wir vor, warum der Engpass bei KI-Projekten so häufig in den Daten liegt, welche fünf Datenprobleme in Unternehmen am häufigsten auftreten, welche Bedingungen „KI-fähige Daten“ erfüllen sollten, in welchen sieben Schritten sich Daten ausgehend von einem Geschäftsszenario vorbereiten lassen und wie sich mit einfachen Kennzahlen beurteilen lässt, ob die Daten bereit sind. Zum Schluss beantworten wir einige häufige Fragen.
Warum liegt der Engpass bei KI-Projekten so oft in den Daten?
Die Qualität der KI-Ergebnisse hängt von den Daten ab, die sie sehen kann. Fehler, Lücken und Widersprüche in den Daten werden von der KI nicht automatisch korrigiert, sondern schneller und in größerem Umfang verstärkt.
Mehrere Untersuchungen weisen auf dasselbe Problem hin:
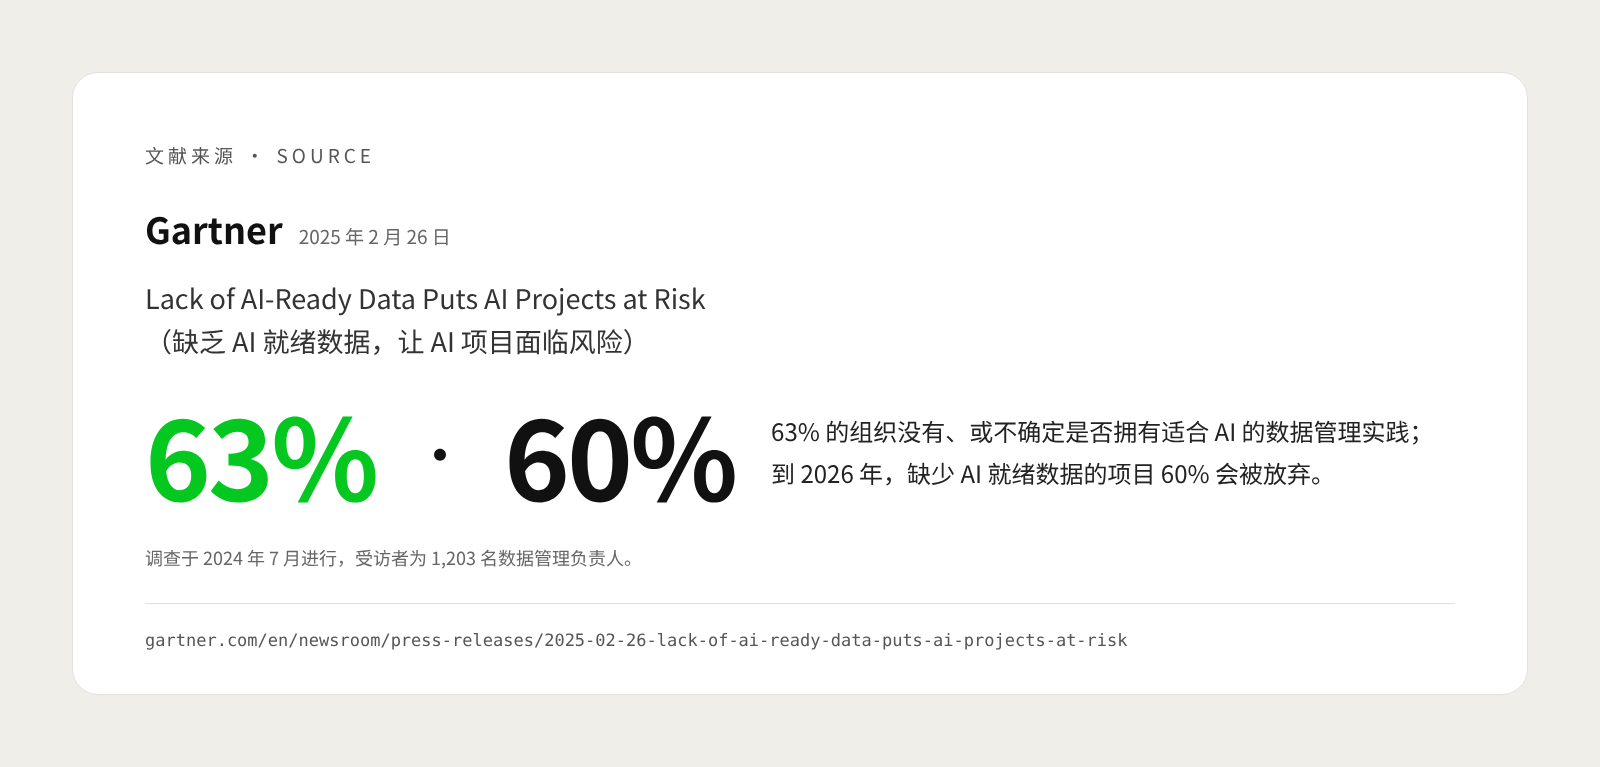
- Das Datenmanagement der meisten Unternehmen hält noch nicht Schritt. Einer im Februar 2025 veröffentlichten Gartner-Umfrage zufolge gaben 63 % der im Juli 2024 befragten 1.203 Verantwortlichen für Datenmanagement an, ihre Organisation verfüge nicht über Datenmanagement-Praktiken, die für KI geeignet sind, oder sie seien sich dessen nicht sicher. Gartner prognostiziert zudem, dass bis 2026 60 % der KI-Projekte, denen „KI-fähige Daten“ fehlen, von den Unternehmen aufgegeben werden (Quelle).
- Auch reife Unternehmen kommen an den Daten nicht vorbei. Eine Gartner-Umfrage im vierten Quartal 2024 unter 432 Befragten in den USA, Großbritannien, Frankreich, Deutschland, Indien und Japan ergab, dass Verfügbarkeit und Qualität der Daten unabhängig vom KI-Reifegrad zu den größten Herausforderungen bei der KI-Umsetzung zählen: 34 % der Verantwortlichen in Organisationen mit niedrigem Reifegrad sahen das so, aber auch 29 % in Organisationen mit hohem Reifegrad (Quelle).
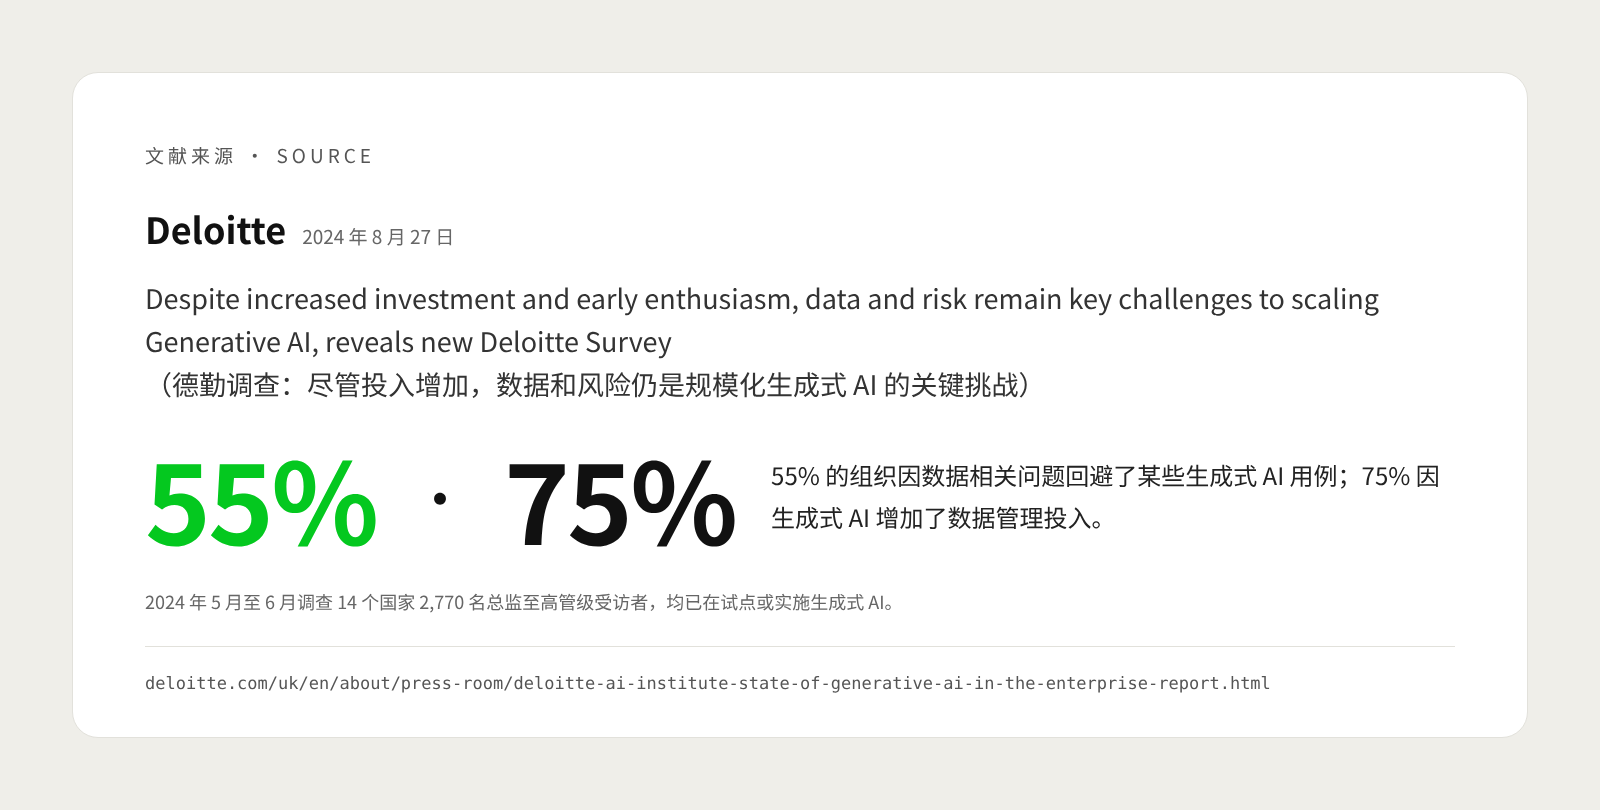
- Datenprobleme schränken den Einsatzbereich von KI unmittelbar ein. Einer Deloitte-Umfrage unter 2.770 Befragten von Direktoren- bis C-Level-Ebene in 14 Ländern (Mai bis Juni 2024) zufolge haben 55 % der Organisationen wegen datenbezogener Probleme bestimmte Anwendungsfälle generativer KI gemieden; 75 % haben ihre Investitionen in das Datenmanagement wegen generativer KI erhöht (Quelle). Dabei ist zu beachten, dass alle Befragten dieser Umfrage KI-Erfahrung haben und bereits generative KI pilotieren oder einsetzen; sie sind also weiter als ein durchschnittliches Unternehmen.
Warum treten Datenprobleme in KI-Projekten so deutlich zutage? Dafür gibt es zwei Gründe. Erstens: Wenn ein klassischer Bericht falsch ist, bemerkt die Person, die ihn liest, oft aus Erfahrung, dass „diese Zahl nicht stimmt“; KI hingegen gibt auf Basis fehlerhafter Daten direkt Empfehlungen oder führt sogar selbstständig Aktionen aus. Zweitens stellt KI höhere Ansprüche an die Daten. Gartner weist darauf hin, dass KI-fähige Daten das konkrete Anwendungsszenario repräsentieren müssen, einschließlich seiner Muster, Fehler, Ausreißer und unerwarteten Fälle (Quelle).
Ein Beispiel: Ein Handelsunternehmen möchte mit KI den Nachschubbedarf der einzelnen Lager vorhersagen. Enthalten die historischen Verkaufsdaten viele Retourenstornierungen, und wird der Nullabsatz während Lieferengpässen als „keine Nachfrage“ gewertet, lernt das Modell ein falsches Muster – je „selbstsicherer“ die Prognose, desto größer die Abweichung beim Nachschub.
Welche Datenprobleme treten in Unternehmen am häufigsten auf?
Die Datenprobleme der meisten Unternehmen sind nicht mysteriös, sondern alltägliche Verwaltungsprobleme, die sich über lange Zeit angesammelt haben. Im Alltag sind sie bloß „lästig“, im KI-Projekt werden sie zum „Hindernis“.
Derselbe Kunde, mehrere Schreibweisen. Der Vertrieb erfasst „Muster Handels GmbH, Region Ost“, die Buchhaltung „Muster Handel (Hamburg)“, und im Kundenservice-System steht wieder nur eine Kontaktperson mit Mobilnummer. Bei der Analyse des Kundenwerts kann eine KI so einen Großkunden mit hohem Jahresumsatz in drei durchschnittliche Kunden aufspalten, und Kreditlimit und Konditionen werden entsprechend falsch.
Uneinheitliche Stammdaten. Stammdaten (Master Data) sind verhältnismäßig stabile, von mehreren Prozessen gemeinsam genutzte Grunddaten wie Kunden, Lieferanten, Produkte, Materialien und Mitarbeitende. Hat dasselbe Produkt im Vertriebssystem, im Lager und in der Buchhaltung jeweils eine eigene Nummer, muss die KI bei der Frage „Wie hoch ist die tatsächliche Marge dieses Produkts?“ zunächst raten, welche Nummern dasselbe Produkt bezeichnen.
Daten in Tabellen und verschiedenen Systemen verstreut. Die Preisliste liegt auf dem Rechner des Einkaufsleiters, die Aktionsregeln im E-Mail-Anhang, die Bestandskorrekturen der Filialen im Chat. Auf solche Daten kann die KI weder zugreifen, noch kann sie erkennen, welche Version die aktuelle ist.
Uneinheitliche Definitionen. Verschiedene Abteilungen verstehen dieselbe Kennzahl unterschiedlich. Der „Umsatz“ des Vertriebs enthält beispielsweise Steuern und berücksichtigt keine Retouren, der „Umsatz“ der Finanzabteilung ist ohne Steuern und nach Abzug der Retouren; bei „pünktlicher Lieferung“ rechnen die einen nach dem zugesagten Termin, die anderen nach dem Wunschtermin des Kunden. Zwischen zwei Definitionen wird die Antwort der KI zwangsläufig von einer Seite als falsch angesehen.
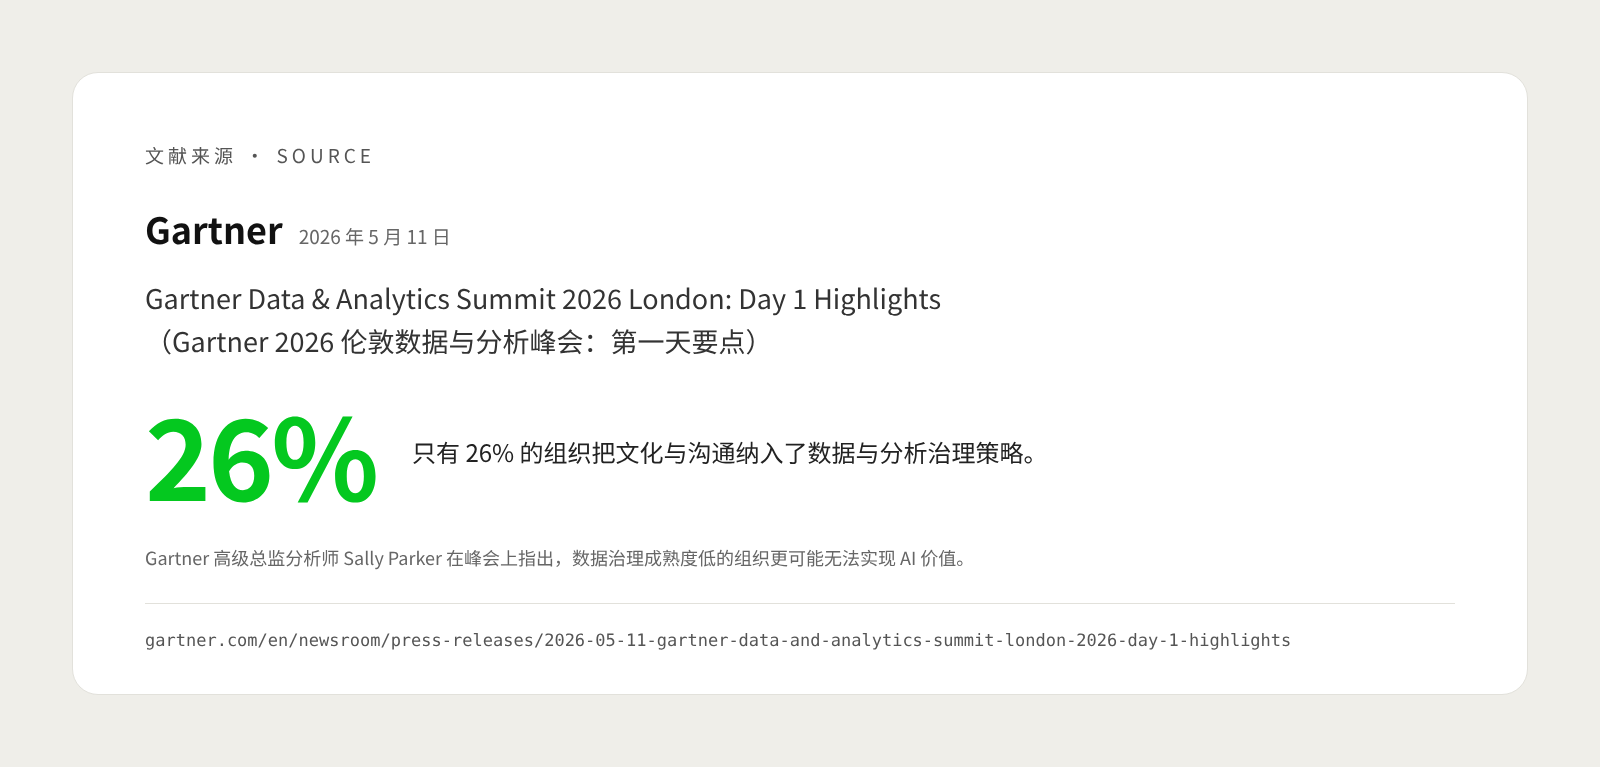
Niemand ist für die Daten verantwortlich. Man stellt fest, dass eine Kundenadresse falsch oder eine Produktspezifikation veraltet ist, weiß aber nicht, an wen man sich zur Korrektur wenden soll; jede Abteilung nutzt die Daten, aber niemand verantwortet ihre Richtigkeit. Sally Parker, Senior Director Analyst bei Gartner, wies im Mai 2026 auf dem Gartner Data & Analytics Summit in London darauf hin, dass Organisationen mit geringer Reife der Data Governance deutlich häufiger den Wert von KI nicht realisieren; im selben Vortrag wurde erwähnt, dass nur 26 % der Organisationen Kultur und Kommunikation in ihre Strategie für Data & Analytics Governance einbeziehen (Quelle). Das zeigt: Datenmanagement ist nicht nur eine technische Frage, sondern auch eine Frage von Aufgabenverteilung und Gewohnheiten.
Wann gelten Daten als „KI-fähig“?
„KI-fähig“ bedeutet nicht, dass alle Unternehmensdaten makellos sind, sondern dass der Teil der Daten, der ein bestimmtes KI-Szenario trägt, den nötigen Standard erreicht. Ob Daten bereit sind, beurteilt man vom Szenario aus, nicht von der Datenbank aus.
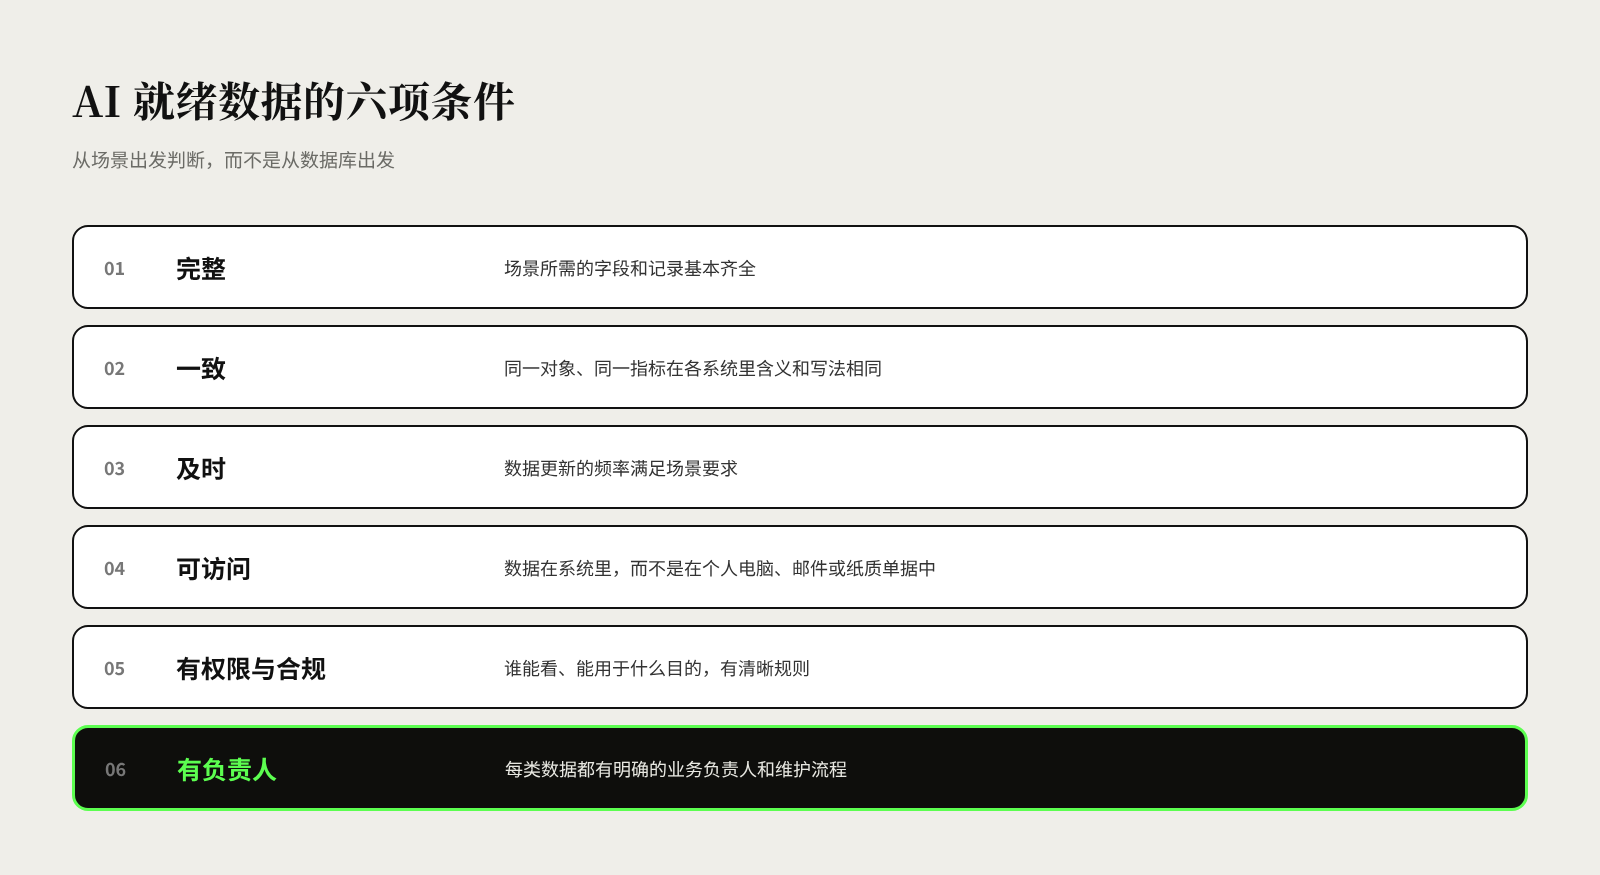
Die folgende Tabelle nennt die sechs Bedingungen, die KI-fähige Daten in der Regel erfüllen müssen, und kann als Checkliste zur Selbstprüfung dienen:
| Bedingung | Bedeutung | Frage zur Selbstprüfung | Typisches Gegenbeispiel |
|---|---|---|---|
| Vollständig | Die für das Szenario nötigen Felder und Datensätze sind im Wesentlichen vorhanden | Wie hoch ist der Anteil fehlender Werte bei den Schlüsselfeldern? | Bei 30 % der Aufträge ist die Branche des Kunden nicht eingetragen |
| Konsistent | Dasselbe Objekt und dieselbe Kennzahl haben in allen Systemen dieselbe Bedeutung und Schreibweise | Gibt es für denselben Kunden und dasselbe Produkt nur eine Kennung? | Ein Kunde hat in drei Systemen drei verschiedene Namen |
| Aktuell | Die Aktualisierungshäufigkeit genügt den Anforderungen des Szenarios | Wie oft werden die Daten aktualisiert, und nutzt die KI die neueste Version? | Der Bestand wird nur nachts synchronisiert, KI-Antworten tagsüber hinken stets hinterher |
| Zugänglich | Die Daten liegen an einem Ort und in einem Format, die Systeme lesen können | Sind die Daten im System und nicht auf privaten Rechnern, in E-Mails oder auf Papierbelegen? | Die Preisrichtlinie existiert nur in der Tabelle eines Abteilungsleiters |
| Berechtigt und konform | Klare Regeln, wer die Daten sehen und wofür nutzen darf | Sind personenbezogene Daten betroffen? Ist der Verwendungszweck zulässig? | Eine vollständige Liste mit Kundenmobilnummern wird direkt an ein externes KI-Tool gesendet |
| Mit Verantwortlichem | Für jede Datenart gibt es einen klaren fachlichen Verantwortlichen und einen Pflegeprozess | Weiß man bei fehlerhaften Daten, an wen man sich wendet und wie lange die Korrektur dauert? | Wer die Produktdaten aktualisiert, „kommt darauf an“ |
Die Maßstäbe in der Tabelle müssen je Szenario festgelegt werden. Zum Entwerfen von Marketingtexten mit KI sind die Anforderungen an die Aktualität gering; wenn KI dagegen Kundenanfragen zu Bestand und Lieferzeit beantworten soll, müssen die Daten nahezu in Echtzeit vorliegen.
Zwei weitere Punkte sind zu beachten. Erstens betont Gartner, dass Datenbereitschaft ein Prozess ist, bei dem Daten mithilfe von Metadaten (Daten über Daten, etwa Feldbedeutung, Herkunft und Aktualisierungszeitpunkt) abgeglichen, geprüft und gesteuert werden, und keine „einmalige Aufgabe“; sie erfordert fortlaufende Verbesserung (Quelle). Zweitens müssen auch unstrukturierte Daten wie Verträge, E-Mails und Richtliniendokumente gepflegt werden: Bleiben veraltete Richtlinien in der Wissensdatenbank, kann ein KI-Kundenservice Kunden nach einer überholten Regelung antworten.
Wie bereitet man Daten für KI vor? Eine Schritt-für-Schritt-Anleitung
Am wirksamsten ist es nicht, zuerst ein unternehmensweites „Daten-Großprojekt“ aufzusetzen, sondern die relevanten Daten rund um ein konkretes Szenario bis zur Nutzbarkeit zu ordnen. Bringen Sie zuerst die Daten eines Szenarios auf den erforderlichen Stand und übertragen Sie das Vorgehen dann auf das nächste.
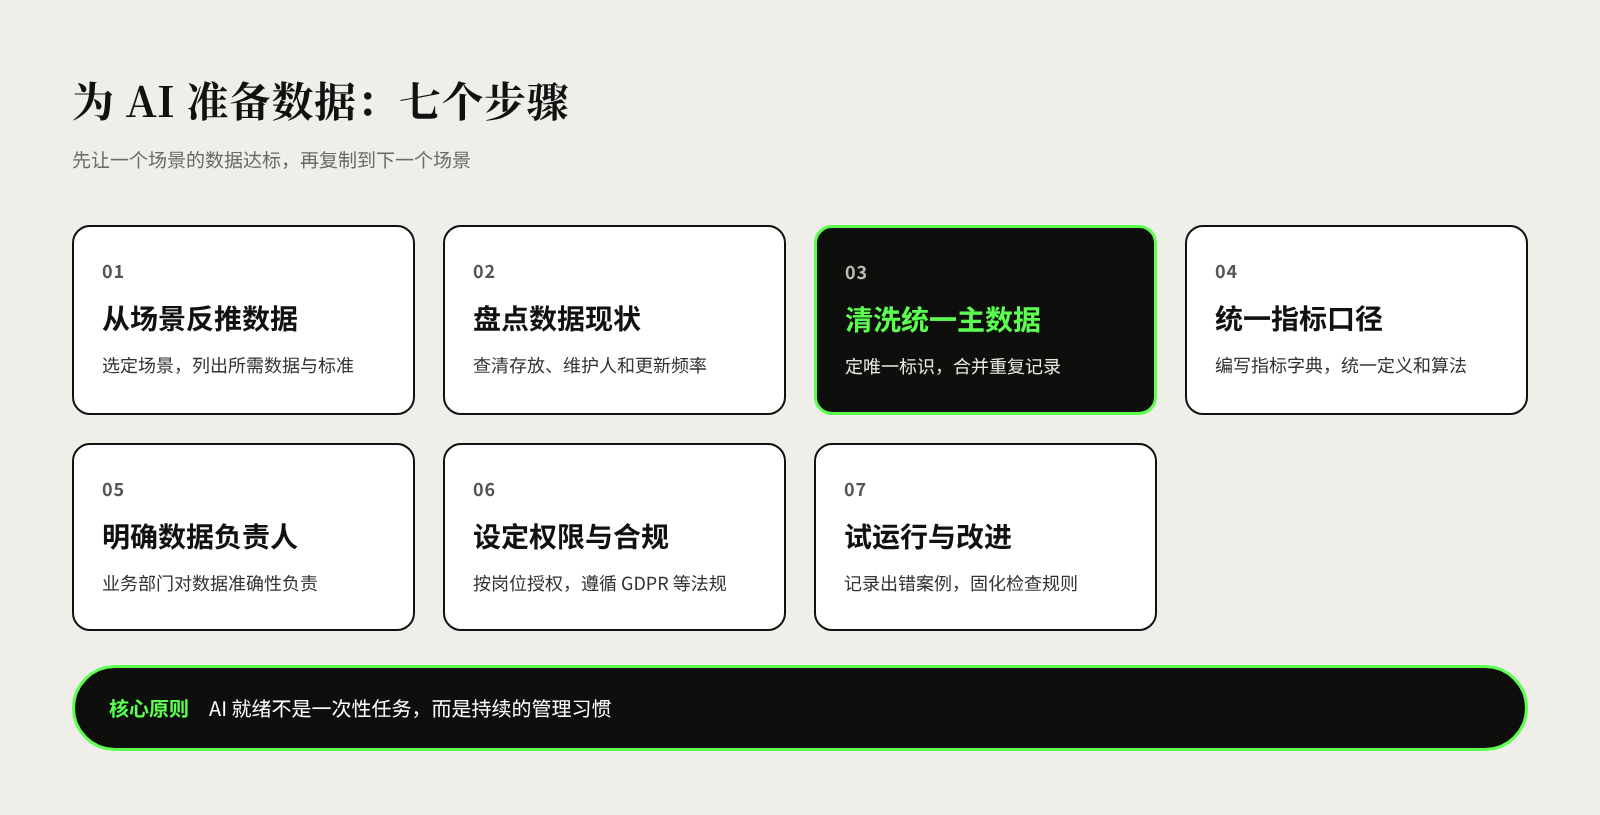
Schritt 1: Vom Geschäftsszenario aus die benötigten Daten ableiten. Wählen Sie zunächst ein Szenario mit klarem Nutzen und listen Sie dann auf, welche Daten es braucht. Für den automatischen Abgleich von Lieferantenrechnungen mit KI sind das etwa Bestellungen, Wareneingänge, Rechnungen, Lieferantenstammdaten und Vertragspreise. Halten Sie beim Erstellen der Liste zugleich fest, welchen Standard jede Datenart erreichen muss.
Schritt 2: Den Datenbestand erfassen. Klären Sie für jeden Punkt der Liste: In welchem System oder welcher Datei liegen die Daten, wer pflegt sie, wie oft werden sie aktualisiert, in welchem Format liegen sie vor? Prüfen Sie anschließend die Qualität anhand einer Stichprobe, etwa 200 Rechnungen: Wie viele lassen sich mit Bestellung und Wareneingang abgleichen? Ergebnis der Bestandsaufnahme sind eine Datenliste und eine Problemliste.
Schritt 3: Stammdaten bereinigen und vereinheitlichen. Beginnen Sie mit den Stammdaten, auf die das Szenario am stärksten angewiesen ist, in der Regel Kunden, Produkte und Lieferanten. Legen Sie zuerst Regeln fest, etwa dass Kunden über die einheitliche Unternehmenskennung oder Steuernummer eindeutig identifiziert werden, führen Sie dann doppelte Datensätze zusammen und ergänzen Sie fehlende Schlüsselfelder. Wichtiger noch ist die Kontrolle an der Quelle: Neue Kunden oder Produkte müssen nach den einheitlichen Regeln erfasst und geprüft werden, sonst herrscht kurz nach der Bereinigung wieder Unordnung.
Schritt 4: Kennzahlendefinitionen vereinheitlichen. Halten Sie die für das Szenario relevanten Kennzahlen in einem „Kennzahlenverzeichnis“ fest, das für jede Kennzahl Definition, Berechnungsweise, Datenquelle und Verantwortlichen beschreibt. Klären Sie zum Beispiel, ob die „Marge“ Fracht und Rückvergütungen abzieht. Sobald die Definition feststeht, nutzen Berichte, Dashboards und KI dieselbe Definition.
Schritt 5: Datenverantwortliche und Aktualisierungsmechanismus einrichten. Für jede wichtige Datenart sollte ein Verantwortlicher aus dem Fachbereich benannt werden, zum Beispiel Kundendaten beim Vertriebsinnendienst, Produktdaten bei Produktmanagement oder Einkauf; er verantwortet die Richtigkeit. Vereinbaren Sie außerdem Aktualisierungsfrequenz, Qualitätsprüfung und Rückmeldekanal, damit jeder, der einen Fehler entdeckt, weiß, an wen er sich wenden kann.
Schritt 6: Berechtigungen festlegen und Compliance sicherstellen. Legen Sie nach Funktion fest, wer welche Daten einsehen und nutzen darf; bei personenbezogenen Daten ist besondere Sorgfalt gefragt. Am Beispiel der EU-Datenschutz-Grundverordnung (DSGVO): Artikel 5 verlangt, dass die Verarbeitung personenbezogener Daten den Grundsätzen der Rechtmäßigkeit, Verarbeitung nach Treu und Glauben, Transparenz, Zweckbindung, Datenminimierung, Richtigkeit, Speicherbegrenzung sowie Integrität und Vertraulichkeit folgt und dass der Verantwortliche für die Einhaltung verantwortlich ist und sie nachweisen können muss; Artikel 25 verlangt, Datenschutz bereits bei der Konzeption und durch datenschutzfreundliche Voreinstellungen umzusetzen, etwa durch Pseudonymisierung und die standardmäßige Verarbeitung nur der erforderlichen personenbezogenen Daten (Quelle). Unternehmen, die in anderen Regionen wie China tätig sind, sollten sich zudem an den dortigen Datenschutzvorschriften orientieren. In der Praxis sollten nicht erforderliche personenbezogene Angaben entfernt oder ersetzt werden, bevor Daten an externe KI-Tools übergeben werden.
Schritt 7: Im kleinen Rahmen pilotieren und kontinuierlich verbessern. Sind die Daten vorbereitet, betreiben Sie das KI-Szenario zunächst in kleinem Umfang, dokumentieren Sie Fälle, in denen die KI Fehler macht, und klären Sie, ob Daten oder Modell die Ursache sind. Übergeben Sie entdeckte Datenprobleme zur Korrektur an die jeweiligen Verantwortlichen und verankern Sie die Prüfregeln dauerhaft. So kann das zweite Szenario die bereits geordneten Stammdaten und das Kennzahlenverzeichnis wiederverwenden, und die Vorbereitungszeit verkürzt sich spürbar.
Woran erkennt man, dass die Daten bereit sind?
Ob Daten bereit sind, lässt sich weder nach Gefühl beurteilen noch erst nach dem Go-live der KI am Ergebnis ablesen. Am praktischsten ist es, für die wichtigsten Daten des Szenarios einige einfache, regelmäßig messbare Qualitätskennzahlen festzulegen.
Folgende Ansatzpunkte bieten sich an:
- Dublettenquote. Wie hoch ist der Anteil verdächtiger Duplikate bei Kunden, Produkten und Lieferanten? Zählen Sie zum Beispiel monatlich die Kundendatensätze mit ähnlichem Namen und gleicher Steuernummer und prüfen Sie, ob die Zahl sinkt.
- Fehlquote. Wie viele der für das Szenario nötigen Schlüsselfelder sind leer, etwa die Lieferadresse bei Aufträgen oder Spezifikation und Einheit bei Produkten?
- Konsistenzquote. Lassen sich dieselben Daten zwischen verschiedenen Systemen abgleichen, etwa der Bestand im ERP mit dem im Lagersystem oder Auftragsbetrag und Rechnungsbetrag?
- Aktualisierungsverzögerung. Nach welcher Zeit ist ein Geschäftsvorfall im System sichtbar, etwa wie schnell Filialumsätze in der Zentrale ankommen oder Preisanpassungen wirksam werden?
- Bearbeitungsdauer von Datenproblemen. Wie viele Tage vergehen von der Entdeckung bis zur Korrektur, und gibt es Rückstände, um die sich niemand kümmert?
Für diese Kennzahlen braucht es keine komplexen Werkzeuge; zum Einstieg genügt eine monatlich aktualisierte Tabelle. Entscheidend ist, dass die Kennzahlen Verantwortliche und Zielwerte haben und regelmäßig in der Managementrunde betrachtet werden. Ein Beispiel: Eine Gastronomiekette wollte mit KI den Warenschwund in den einzelnen Filialen analysieren und legte zunächst die „Fehlquote bei den Verlustmeldungen der Filialen“ und die „Verzögerung bei der Erfassung der Verlustmeldungen“ als zwei Kennzahlen fest; erst nachdem beide zwei Monate in Folge die Zielwerte erreicht hatten, begann die Modellierung. Erst wenn die Kennzahlen stabil im Ziel liegen, ist das das Signal, das KI-Szenario zu starten.
Häufige Fragen zur Datenvorbereitung für KI
Müssen alle Daten bereinigt sein, bevor man mit KI beginnen kann? Nein. Pragmatischer ist es, sich auf ein Szenario zu konzentrieren und nur die dafür nötigen Daten bis zur Nutzbarkeit zu ordnen. Eine umfassende Data Governance kann mit der Zahl der Szenarien schrittweise ausgebaut werden.
Was tun, wenn ein mittelständisches Unternehmen kein eigenes Data-Team hat? Benennen Sie zunächst Datenverantwortliche in den Fachbereichen und verwalten Sie die wichtigsten Daten mit einfachen Checklisten und Regeln. Viele Datenprobleme lassen sich allein durch einheitliche Erfassungsregeln und regelmäßige Kontrollen deutlich verbessern; komplexe Werkzeuge sind nicht zwingend nötig.
Sind die Daten KI-fähig, wenn schon ein ERP oder CRM im Einsatz ist? Nicht unbedingt. Das System bietet lediglich den Ort, an dem Daten liegen; ob sie vollständig, konsistent und gepflegt sind, hängt vom Alltagsmanagement ab. Außerdem müssen KI-Szenarien oft Daten aus mehreren Systemen verbinden, daher bleiben einheitliche Definitionen unverzichtbar.
Sollte die Datenvorbereitung vom Fachbereich oder von der IT geleitet werden? Der Fachbereich sollte führen und die IT unterstützen. Was Daten bedeuten und ob sie stimmen, wissen nur die Fachleute am besten; die IT verantwortet die technische Umsetzung bei Systemen, Schnittstellen und Berechtigungen. Beide sind unverzichtbar.
Ist es sicher, Unternehmensdaten an externe KI-Tools zu übergeben? Entscheidend ist die vorherige Bewertung. Prüfen Sie, wie der Anbieter Daten speichert und nutzt und ob sie zum Training von Modellen verwendet werden, und entfernen Sie nicht erforderliche personenbezogene Angaben sowie sensible Geschäftsinformationen. Bei personenbezogenen Daten ist außerdem sicherzustellen, dass der Verwendungszweck den Anforderungen anwendbarer Vorschriften wie der DSGVO entspricht.
Quellen
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, Februar 2025
- Gartner Survey Finds 45% of Organizations With High AI Maturity Keep AI Projects Operational for at Least Three Years, Gartner, Juni 2025
- Gartner Data & Analytics Summit 2026 London: Day 1 Highlights, Gartner, Mai 2026
- Despite increased investment and early enthusiasm, data and risk remain key challenges to scaling Generative AI, reveals new Deloitte Survey, Deloitte, August 2024
- Regulation (EU) 2016/679 (General Data Protection Regulation), Amtsblatt der Europäischen Union (EUR-Lex), April 2016


