Quand beaucoup d'entreprises parlent d'IA, elles commencent par se demander quel modèle choisir, quel outil acheter. Mais une fois les mains dans le cambouis, elles découvrent que ce qui bloque le projet est souvent tout autre chose : des fiches clients en doublon, des codes produits non harmonisés, des données clés éparpillées dans les tableurs de chacun, et personne pour dire quel chiffre est le bon. Le premier obstacle au déploiement de l'IA n'est généralement pas le modèle, mais les données : inexactes, incomplètes, introuvables, ou sans responsable.
Alors, avant de lancer l'IA, quelles données une entreprise doit-elle d'abord remettre en ordre ? Cet article présente pourquoi le goulot d'étranglement des projets d'IA se situe souvent dans les données, les cinq catégories de problèmes de données les plus fréquentes en entreprise, les conditions que doivent remplir des « données prêtes pour l'IA », les sept étapes pour préparer les données à partir d'un cas d'usage métier, et comment juger avec des indicateurs simples si les données sont prêtes, avant de répondre à quelques questions courantes.
Pourquoi le goulot d'étranglement des projets d'IA se situe-t-il souvent dans les données ?
La qualité des résultats d'une IA dépend des données auxquelles elle a accès. Les erreurs, les lacunes et les contradictions présentes dans les données ne sont pas corrigées automatiquement par l'IA ; elles sont au contraire amplifiées, plus vite et à plus grande échelle.
Plusieurs enquêtes pointent le même problème :
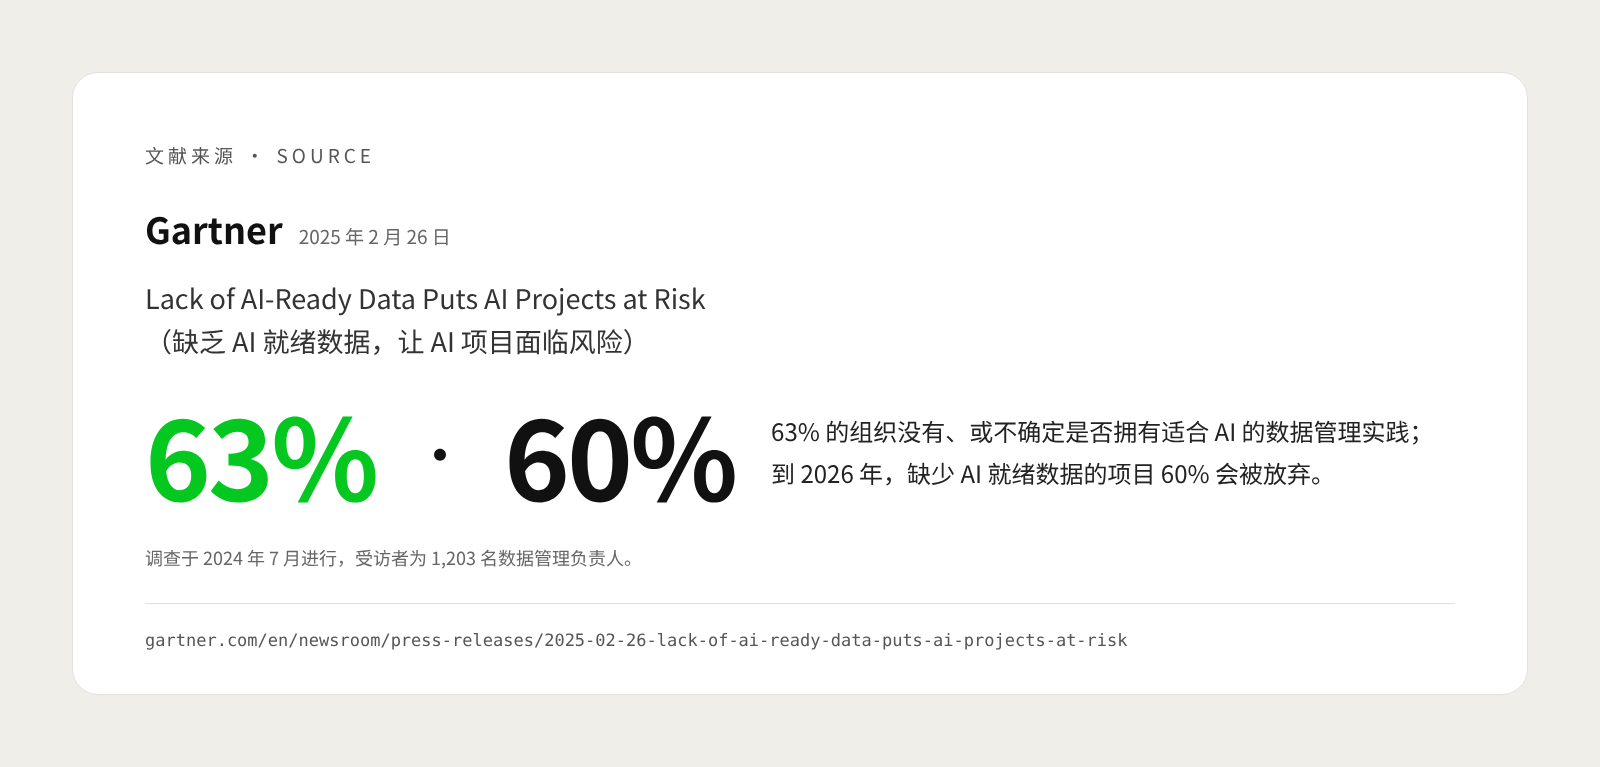
- La gestion des données de la plupart des entreprises n'a pas suivi. Selon une enquête publiée par Gartner en février 2025 auprès de 1 203 responsables de la gestion des données interrogés en juillet 2024, 63 % déclarent que leur organisation ne dispose pas des pratiques de gestion des données adaptées à l'IA, ou ne sont pas certains de les avoir. Gartner prévoit par ailleurs que, d'ici 2026, 60 % des projets d'IA dépourvus de « données prêtes pour l'IA » seront abandonnés par les entreprises (source).
- Les entreprises matures n'y échappent pas non plus. Une enquête menée par Gartner au quatrième trimestre 2024 auprès de 432 répondants aux États-Unis, au Royaume-Uni, en France, en Allemagne, en Inde et au Japon montre que, quel que soit le niveau de maturité en IA, la disponibilité et la qualité des données figurent parmi les principaux défis de la mise en œuvre de l'IA : 34 % des responsables d'organisations peu matures le disent, et 29 % dans les organisations très matures (source).
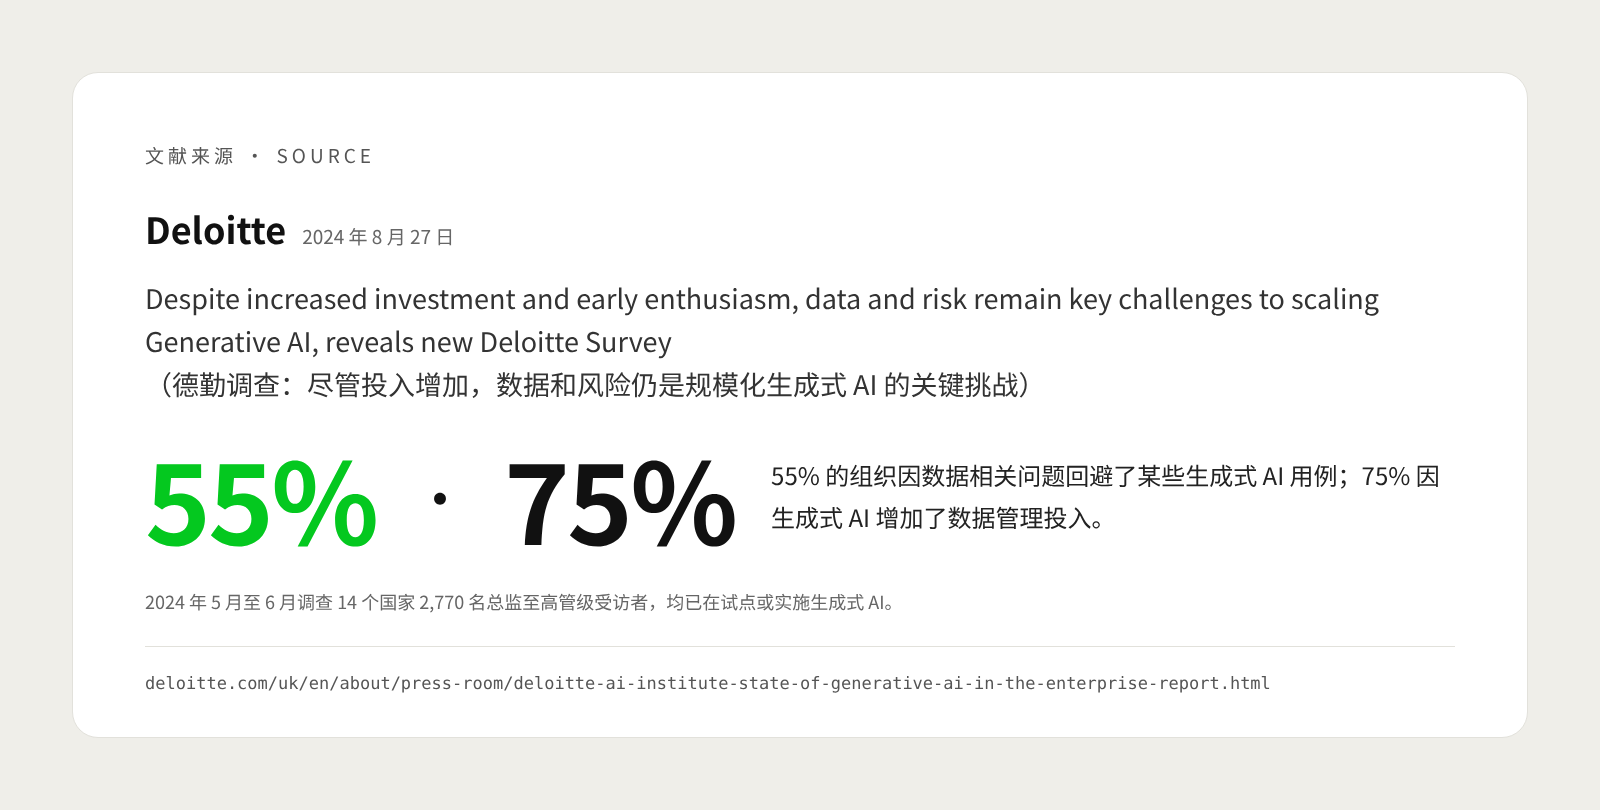
- Les problèmes de données réduisent directement le champ d'utilisation de l'IA. Selon l'enquête menée par Deloitte de mai à juin 2024 auprès de 2 770 répondants, de directeurs à dirigeants de rang C, dans 14 pays, 55 % des organisations ont écarté certains cas d'usage d'IA générative en raison de problèmes liés aux données ; 75 % ont accru leurs investissements dans la gestion des données à cause de l'IA générative (source). À noter que les répondants de cette enquête ont tous une expérience de l'IA et ont déjà lancé des pilotes ou des déploiements d'IA générative : ils sont plus avancés que l'entreprise moyenne.
Pourquoi les problèmes de données ressortent-ils tant dans les projets d'IA ? Pour deux raisons. D'abord, quand un rapport traditionnel comporte une erreur, celui qui le lit peut souvent, par expérience, s'apercevoir que « ce chiffre n'est pas bon » ; l'IA, elle, formule directement des recommandations à partir de données erronées, voire exécute des actions automatiquement. Ensuite, l'IA est plus « exigeante » envers les données. Gartner souligne que des données prêtes pour l'IA doivent être représentatives du cas d'usage concerné, y compris ses régularités, ses erreurs, ses valeurs aberrantes et ses imprévus (source).
Prenons l'exemple d'une entreprise de distribution qui souhaite utiliser l'IA pour prévoir les besoins de réapprovisionnement de chaque entrepôt. Si l'historique des ventes mêle de nombreuses écritures d'annulation de retours, et si les ventes nulles pendant les ruptures de stock sont interprétées comme une « absence de demande », le modèle apprend un schéma erroné : plus ses prévisions sont « assurées », plus l'écart de réapprovisionnement est grand.
Quels sont les problèmes de données les plus fréquents en entreprise ?
Les problèmes de données de la plupart des entreprises n'ont rien de mystérieux : ce sont des problèmes de gestion quotidienne accumulés au fil du temps. Ces problèmes ne sont que des « désagréments » en temps normal, mais deviennent des « obstacles » dans un projet d'IA.
Un même client écrit de plusieurs façons. Les ventes saisissent « Société X Commerce, Chine de l'Est », la finance saisit « X Commerce (Shanghai) », et dans l'outil du service client, c'est encore un contact avec un numéro de téléphone. Par exemple, en analysant la valeur des clients, l'IA risque de scinder en trois clients ordinaires un grand compte aux achats annuels très élevés, et la limite de crédit comme les conditions commerciales s'en trouveront faussées.
Des données de référence non harmonisées. Les données de référence (Master Data) désignent les données de base relativement stables et partagées par plusieurs processus : clients, fournisseurs, produits, matières, salariés, etc. Par exemple, si un même produit a un code dans le système de ventes, un autre à l'entrepôt et un autre encore à la finance, pour répondre à « quelle est la marge brute réelle de ce produit ? », l'IA doit d'abord deviner quels codes désignent le même article.
Des données éparpillées dans des tableurs et des systèmes différents. La grille tarifaire se trouve sur l'ordinateur du responsable des achats, les règles promotionnelles dans une pièce jointe d'e-mail, les ajustements de stock des magasins dans un groupe de messagerie. L'IA ne peut ni accéder à ces données, ni distinguer quelle version est la plus récente.
Des définitions incohérentes. Selon les services, un même indicateur ne se comprend pas de la même façon. Par exemple, le « chiffre d'affaires » du service commercial inclut les taxes et ne déduit pas les retours, alors que celui de la finance est hors taxes et net des retours ; pour la « livraison à l'heure », certains comptent par rapport à la date promise, d'autres par rapport à la date demandée par le client. Entre deux définitions, la réponse de l'IA sera forcément jugée fausse par l'un des deux camps.
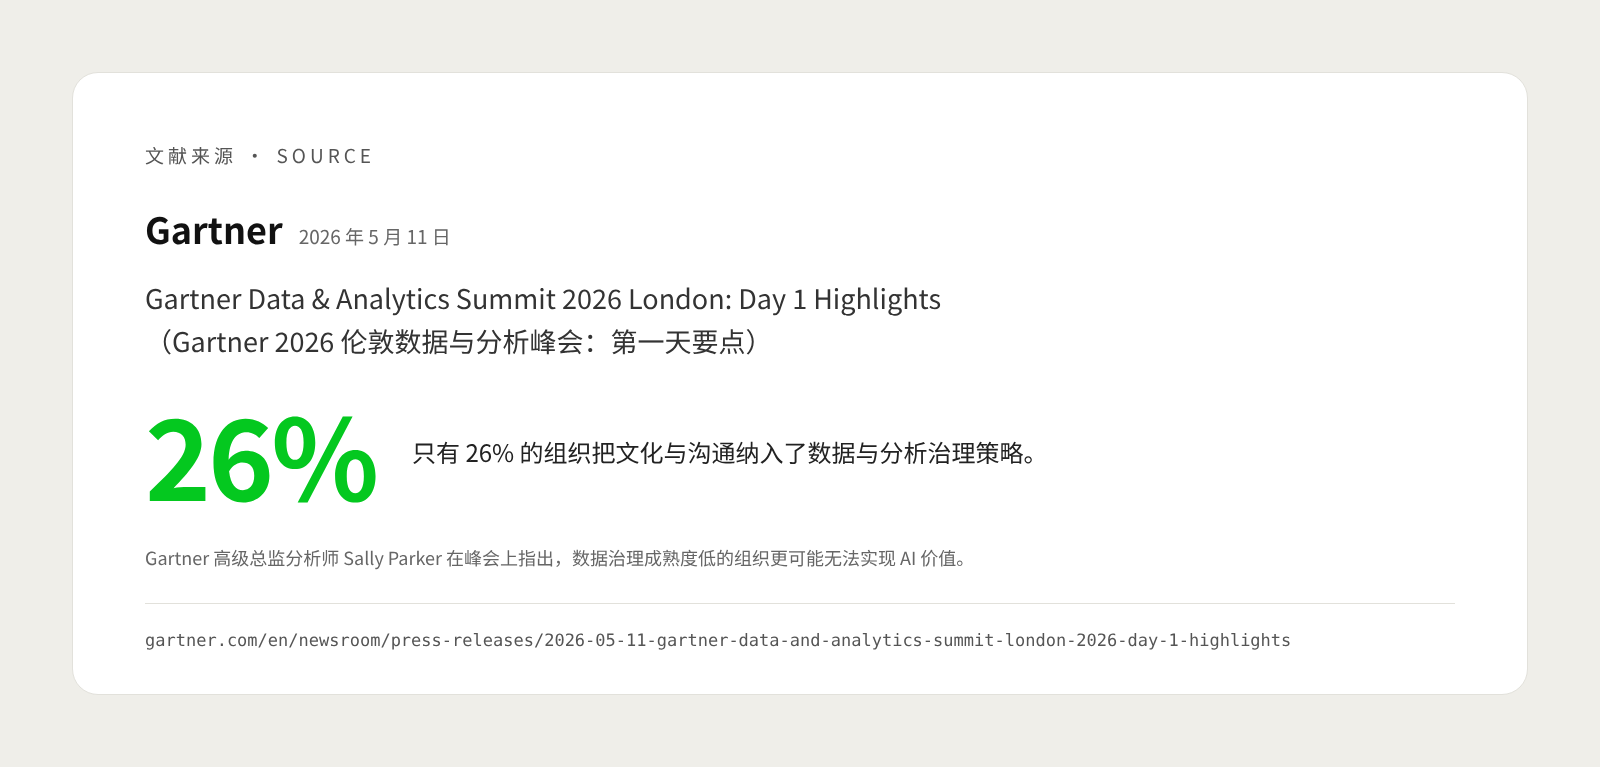
Personne n'est responsable des données. On constate qu'une adresse client est erronée ou qu'une fiche produit est périmée, mais on ne sait pas à qui demander la correction ; chaque service utilise les données, mais personne n'est responsable de leur exactitude. Sally Parker, directrice senior analyste chez Gartner, a indiqué au Gartner Data & Analytics Summit de Londres en mai 2026 que les organisations dont la maturité en gouvernance des données est faible ont nettement plus de risques de ne pas tirer de valeur de l'IA ; lors de la même intervention, il a été précisé que seules 26 % des organisations intègrent la culture et la communication dans leur stratégie de gouvernance des données et de l'analytique (source). Cela montre que la gestion des données n'est pas qu'une question technique, mais aussi une question de répartition des rôles et d'habitudes.
Qu'appelle-t-on des données « prêtes pour l'IA » ?
« Prêtes pour l'IA » ne signifie pas que toutes les données de l'entreprise soient parfaites, mais que la partie des données qui alimente un cas d'usage précis d'IA atteint un niveau de qualité exploitable. Pour juger si les données sont prêtes, il faut partir du cas d'usage, et non de la base de données.
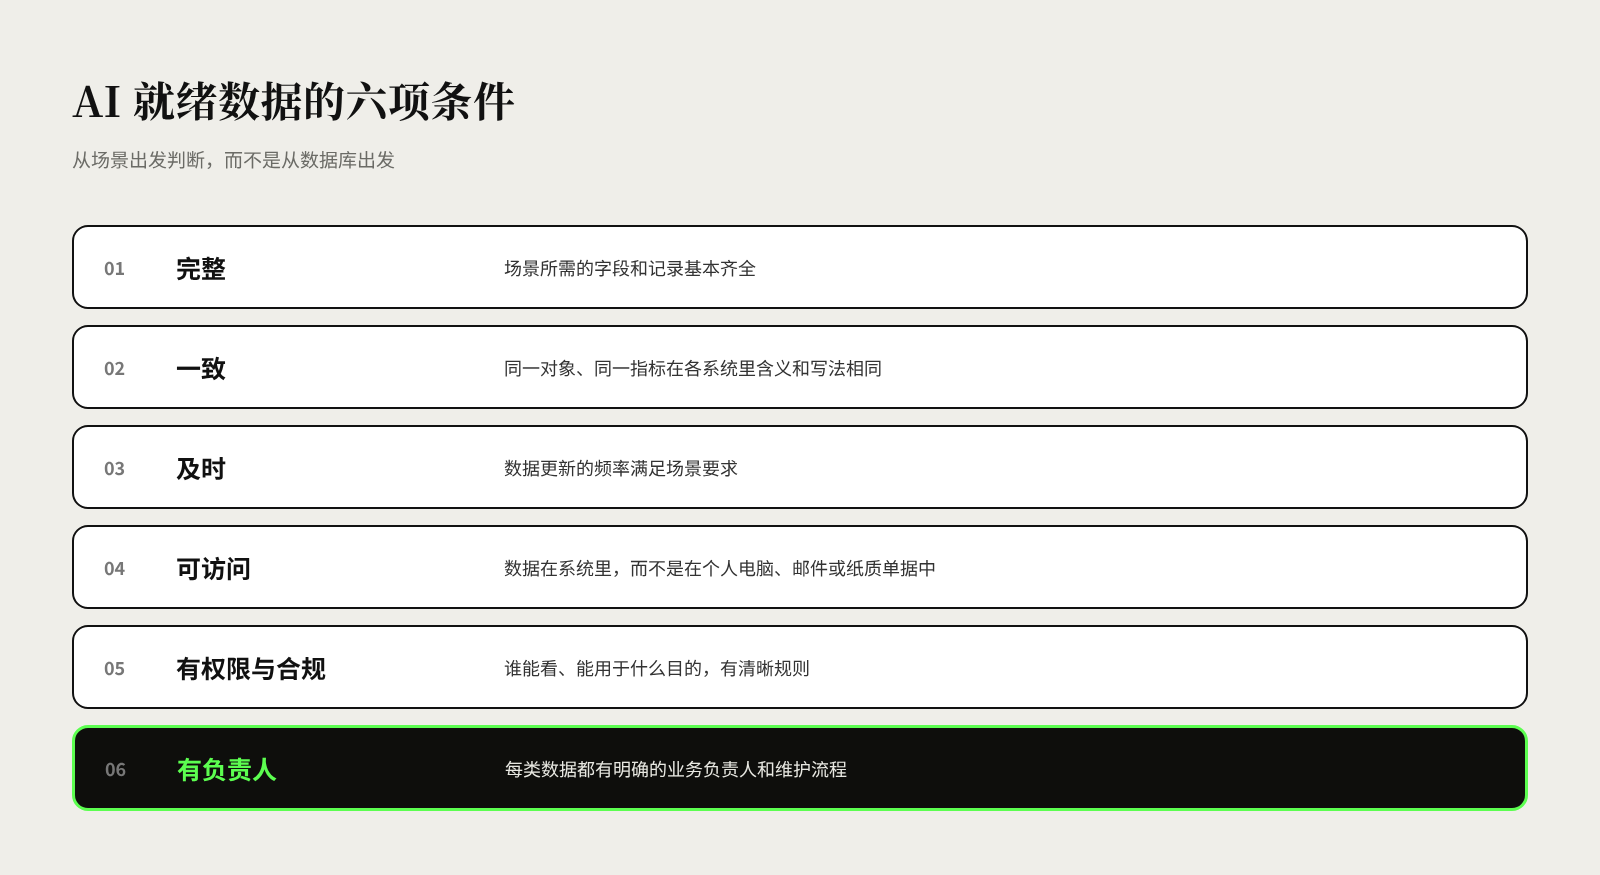
Le tableau ci-dessous présente les six conditions que doivent généralement remplir des données prêtes pour l'IA ; il peut servir de liste d'autodiagnostic :
| Condition | Signification | Question d'autodiagnostic | Contre-exemple courant |
|---|---|---|---|
| Complètes | Les champs et enregistrements nécessaires au cas d'usage sont globalement présents | Quelle est la proportion de valeurs manquantes dans les champs clés ? | Trente pour cent des commandes n'ont pas de secteur d'activité client renseigné |
| Cohérentes | Un même objet, un même indicateur a le même sens et la même écriture dans tous les systèmes | Un même client, un même produit n'a-t-il qu'un seul identifiant ? | Un client porte trois noms dans trois systèmes |
| À jour | La fréquence de mise à jour répond aux exigences du cas d'usage | À quelle fréquence les données sont-elles mises à jour, et l'IA utilise-t-elle la dernière version ? | Le stock n'est synchronisé que chaque nuit, si bien que les réponses de l'IA en journée sont toujours en retard |
| Accessibles | Les données sont stockées à un emplacement et dans un format lisibles par les systèmes | Les données sont-elles dans un système, et non sur un poste individuel, dans des e-mails ou sur des documents papier ? | La politique tarifaire n'existe que dans le tableur d'un responsable |
| Autorisées et conformes | Des règles claires définissent qui peut voir les données et à quelles fins | Des données personnelles sont-elles concernées ? La finalité d'utilisation est-elle conforme ? | Envoyer directement à un outil d'IA externe la liste complète contenant les numéros de téléphone des clients |
| Sous la responsabilité de quelqu'un | Chaque catégorie de données a un responsable métier identifié et un processus de maintenance | En cas d'erreur, sait-on à qui s'adresser et en combien de temps elle sera corrigée ? | Qui met à jour les fiches produits ? « Ça dépend » |
Les critères du tableau doivent être fixés en fonction du cas d'usage. Par exemple, pour rédiger des textes marketing avec l'IA, l'exigence de fraîcheur des données est faible ; en revanche, pour répondre aux demandes des clients sur les stocks et les délais, les données doivent être quasi temps réel.
Deux autres points méritent attention. Premièrement, Gartner souligne que la préparation des données est un processus qui s'appuie sur les métadonnées (des données qui décrivent les données, telles que la signification des champs, la source, la date de mise à jour) pour aligner, valider et gérer les données, et non une tâche « réalisée une fois pour toutes » : elle exige une amélioration continue (source). Deuxièmement, les données non structurées comme les contrats, les e-mails et les documents de politique interne doivent elles aussi être gérées : si des documents périmés restent dans la base de connaissances, un service client assisté par IA pourra répondre aux clients selon d'anciennes règles.
Comment préparer les données pour l'IA ? Guide pas à pas
Pour préparer les données pour l'IA, l'approche la plus efficace n'est pas de lancer d'abord un « grand chantier data » couvrant toute l'entreprise, mais de remettre en état exploitable les données concernées autour d'un cas d'usage précis. Faites d'abord atteindre le niveau requis aux données d'un cas d'usage, puis reproduisez la méthode sur le suivant.
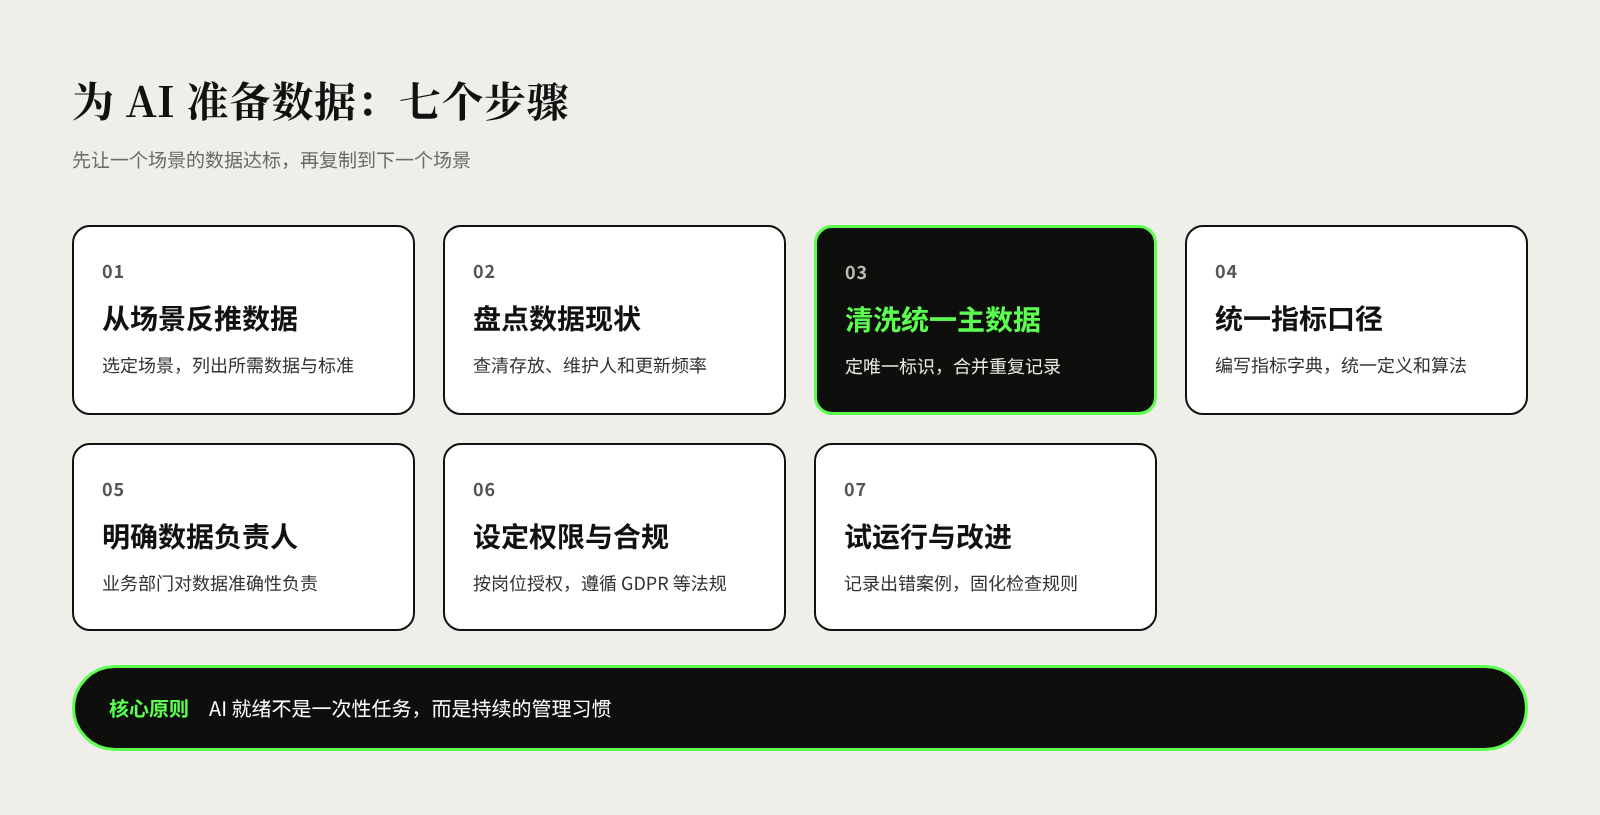
Étape 1 : partir d'un cas d'usage métier pour en déduire les données nécessaires. Choisissez d'abord un cas d'usage à la valeur claire, puis listez les données dont il a besoin. Par exemple, pour utiliser l'IA afin de rapprocher automatiquement les factures fournisseurs, il faut les commandes d'achat, les enregistrements de réception, les factures, les fiches fournisseurs et les prix contractuels. En dressant la liste, notez en même temps le niveau de qualité à atteindre pour chaque catégorie de données.
Étape 2 : faire l'inventaire de l'existant. Pour chaque élément de la liste, déterminez dans quel système ou fichier se trouvent les données, qui les maintient, à quelle fréquence elles sont mises à jour et dans quel format. Prélevez ensuite un échantillon pour contrôler la qualité, par exemple 200 factures, et voyez combien peuvent être rapprochées des commandes et des enregistrements de réception. Cet inventaire produit un catalogue des données et une liste des problèmes.
Étape 3 : nettoyer et unifier les données de référence. Traitez en priorité les données de référence dont le cas d'usage dépend le plus, en général les clients, les produits et les fournisseurs. Commencez par fixer des règles, par exemple identifier chaque client par un identifiant unique tel que le numéro d'identification fiscale, puis fusionnez les doublons et complétez les champs clés. Plus important encore, maîtrisez la source : toute création d'un client ou d'un produit doit suivre les règles de saisie unifiées et passer par une validation, faute de quoi tout sera de nouveau en désordre peu après le nettoyage.
Étape 4 : harmoniser les définitions des indicateurs. Rédigez un « dictionnaire des indicateurs » pour les indicateurs clés du cas d'usage, précisant pour chacun sa définition, sa méthode de calcul, sa source de données et son responsable. Par exemple, indiquez clairement si la « marge brute » déduit les frais de transport et les remises de fin d'année. Une fois la définition arrêtée, les rapports, les tableaux de bord et l'IA utilisent tous la même.
Étape 5 : établir des responsables des données et un mécanisme de mise à jour. Chaque catégorie de données clés doit avoir un responsable côté métier : par exemple, les fiches clients relèvent des opérations commerciales, les fiches produits du service produit ou achats, qui répondent de leur exactitude. Convenez aussi de la fréquence de mise à jour, des modalités de contrôle qualité et du canal de remontée des problèmes, afin que celui qui découvre une erreur sache à qui s'adresser.
Étape 6 : définir les droits d'accès et garantir la conformité. Définissez par poste qui peut consulter et utiliser quelles données, avec une vigilance particulière pour les données personnelles. Prenons le Règlement général sur la protection des données (RGPD) de l'Union européenne : son article 5 exige que le traitement des données personnelles respecte les principes de licéité, loyauté et transparence, de limitation des finalités, de minimisation des données, d'exactitude, de limitation de la conservation, d'intégrité et de confidentialité, le responsable du traitement devant répondre de la conformité et être en mesure de la démontrer ; son article 25 impose d'intégrer la protection des données dès la conception et par défaut, par exemple par la pseudonymisation et le traitement par défaut des seules données personnelles nécessaires (source). Les entreprises qui exercent leur activité en Chine ou dans d'autres régions doivent également se référer à la réglementation locale sur la protection des données personnelles. En pratique, avant de transmettre des données à un outil d'IA externe, il convient de supprimer ou de remplacer les informations personnelles non nécessaires.
Étape 7 : tester à petite échelle et s'améliorer en continu. Une fois les données prêtes, faites d'abord fonctionner le cas d'usage d'IA à petite échelle, consignez les cas où l'IA se trompe et déterminez s'il s'agit d'un problème de données ou de modèle. Confiez les problèmes de données identifiés aux responsables concernés pour correction, et figez les règles de contrôle. Ainsi, le deuxième cas d'usage pourra réutiliser les données de référence et le dictionnaire des indicateurs déjà remis en ordre, et le temps de préparation sera nettement réduit.
Comment savoir si la préparation des données est suffisante ?
Pour juger si les données sont prêtes, on ne peut se fier à son intuition, ni attendre de voir les résultats après la mise en production de l'IA. La méthode la plus pratique consiste à définir, pour les données clés du cas d'usage, quelques indicateurs de qualité simples, mesurables régulièrement.
On peut partir des axes suivants :
- Taux de doublons. La part des enregistrements suspectés d'être en doublon parmi les clients, les produits et les fournisseurs. Par exemple, comptez chaque mois le nombre de fiches clients aux noms proches et au numéro fiscal identique, et vérifiez qu'il diminue.
- Taux de valeurs manquantes. La proportion de champs clés vides pour le cas d'usage, par exemple l'adresse de livraison d'une commande, ou les caractéristiques et l'unité d'un produit.
- Taux de cohérence. Les mêmes données concordent-elles d'un système à l'autre : par exemple, l'écart entre le stock de l'ERP et celui du système d'entrepôt, ou entre le montant d'une commande et celui de la facture.
- Délai de mise à jour. Combien de temps après un événement métier il devient visible dans le système, par exemple le délai de remontée des ventes d'un magasin au siège, ou de prise d'effet d'un changement de prix.
- Délai de traitement des problèmes. Combien de jours s'écoulent entre la découverte d'un problème de données et sa correction, et s'il reste des problèmes en suspens dont personne ne s'occupe.
Ces indicateurs ne nécessitent pas d'outils complexes : au démarrage, un tableur mis à jour chaque mois suffit pour les suivre. L'essentiel est que les indicateurs aient un responsable, une valeur cible, et soient examinés régulièrement en comité de gestion. Par exemple, une enseigne de restauration qui voulait utiliser l'IA pour analyser les pertes de denrées de ses restaurants a d'abord retenu comme indicateurs le « taux de valeurs manquantes des déclarations de pertes » et le « délai de saisie des pertes » ; ce n'est qu'après deux mois consécutifs d'objectifs atteints qu'elle a commencé la modélisation. Des indicateurs durablement au niveau cible sont le signal pour lancer un cas d'usage d'IA.
Questions fréquentes sur la préparation des données pour l'IA
Faut-il nettoyer toutes les données avant de se lancer dans l'IA ? Non. Il est plus pragmatique de se concentrer sur un cas d'usage et de ne remettre en état exploitable que les données dont il a besoin. Une gouvernance des données globale peut progresser au fur et à mesure que les cas d'usage se multiplient.
Que faire quand une PME n'a pas d'équipe data dédiée ? Vous pouvez commencer par désigner des responsables des données dans les services métier, et gérer les données clés avec des listes et des règles simples. Beaucoup de problèmes de données s'améliorent nettement avec des règles de saisie unifiées et des contrôles réguliers, sans nécessairement recourir à des outils complexes.
Un ERP ou un CRM déjà en place signifie-t-il que les données sont prêtes pour l'IA ? Pas nécessairement. Un système offre seulement un lieu de stockage ; que les données soient complètes, cohérentes et maintenues dépend de la gestion au quotidien. De plus, les cas d'usage d'IA exigent souvent de croiser des données de plusieurs systèmes, et l'harmonisation des définitions reste indispensable.
La préparation des données doit-elle être pilotée par les métiers ou par la DSI ? Elle doit être pilotée par les métiers, avec le soutien de la DSI. Seuls les utilisateurs métier connaissent vraiment le sens des données et savent si elles sont justes ; la DSI se charge de la mise en œuvre technique : systèmes, interfaces et droits d'accès. L'un ne va pas sans l'autre.
Est-il sûr de confier les données de l'entreprise à un outil d'IA externe ? Tout dépend de l'évaluation préalable. Vérifiez comment le prestataire stocke et utilise les données, et s'il les utilise pour entraîner des modèles, et supprimez les informations personnelles et les informations commerciales sensibles qui ne sont pas nécessaires. Lorsque des données personnelles sont concernées, assurez-vous aussi que la finalité d'utilisation respecte les exigences des réglementations applicables, comme le RGPD.
Références
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, février 2025
- Gartner Survey Finds 45% of Organizations With High AI Maturity Keep AI Projects Operational for at Least Three Years, Gartner, juin 2025
- Gartner Data & Analytics Summit 2026 London: Day 1 Highlights, Gartner, mai 2026
- Despite increased investment and early enthusiasm, data and risk remain key challenges to scaling Generative AI, reveals new Deloitte Survey, Deloitte, août 2024
- Regulation (EU) 2016/679 (General Data Protection Regulation), Journal officiel de l'Union européenne (EUR-Lex), avril 2016


