Para una empresa de distribución mayorista, el inventario es la mayor partida de capital circulante y también la más difícil de controlar. En el almacén se acumula mercancía que no rota y que está a punto de caducar, mientras que los productos estrella que los clientes necesitan con urgencia se agotan. Muchas empresas siguen pidiendo según la experiencia del comprador y una hoja de Excel, y cuando esa persona cambia, el ritmo se desordena. El valor de la previsión de demanda con IA no está en dar una cifra «exacta», sino en convertir el pedido de una decisión intuitiva en otra con fundamento, verificable y capaz de mejorar de forma continua.
Entonces, ¿en qué supera exactamente la previsión con IA a los métodos tradicionales, qué puede y qué no puede hacer, y por dónde debe empezar la empresa? En este artículo explicamos las causas de fondo de los problemas de inventario en la distribución mayorista, en qué se diferencian los métodos tradicionales de la previsión con aprendizaje automático, qué datos puede utilizar la previsión con IA y cuáles son sus límites, cómo medir la precisión de las previsiones y un método de implantación por pasos que arranca con unos pocos SKU clave.
¿Por qué en la distribución mayorista siempre hay «roturas y excedentes» a la vez?
Que coexistan roturas de stock y excedentes parece contradictorio, pero en realidad son las dos caras del mismo problema. La causa de fondo es que existe una desviación sistemática entre las cantidades pedidas y la demanda real, y la mayoría de las empresas ni ve esa desviación ni dispone de un modo de corregirla de forma continua.
Los problemas de inventario en la distribución mayorista suelen tener estos orígenes:
- Demasiadas referencias y demasiados clientes para gestionarlos a mano. Los distribuidores suelen trabajar con un gran número de SKU (unidades de mantenimiento de stock) y atender a muchas tiendas, restaurantes o distribuidores intermedios. Los compradores solo pueden vigilar de cerca unas decenas de productos principales; el resto se repone, en su mayoría, por costumbre.
- La demanda se amplifica con la volatilidad de los pedidos. Los clientes finales suelen pedir por lotes y acumular existencias de golpe, de modo que el volumen de pedidos se dispara antes de las fiestas y durante las promociones. Si ese pico puntual se toma por la norma, en el siguiente ciclo se pedirá de más; y, al revés, si se ignoran los patrones estacionales, en temporada alta habrá roturas.
- Fuerte presión por caducidad y mermas. Alimentación, bebidas, droguería y otras categorías tienen fecha de caducidad: pedir de más no solo inmoviliza capital, sino que puede obligar a rebajar el producto próximo a caducar o a darlo de baja directamente.
- Registro incompleto de las roturas de stock. Cuando el cliente pide y no hay existencias, el pedido suele cancelarse o sustituirse por otro producto, y en el sistema solo queda «cuánto se vendió», no «cuánto se quería comprar». Pedir con esos datos lleva a infravalorar de forma constante la demanda de los productos más vendidos.
- Dependencia de la experiencia individual. La experiencia es muy útil en entornos estables, pero es difícil de replicar y cuesta responder a «cuánto pedimos esta vez y por qué».
Por ejemplo, un distribuidor de congelados que abastece a restaurantes preparó el stock antes del Año Nuevo chino con las cantidades del año anterior. Este año, varios grandes clientes adelantaron sus compras y se quedó sin existencias dos semanas antes de las fiestas; después, al reponer con el nivel del pico previo, algunas referencias se acumularon hasta rozar su fecha de caducidad. El problema no es que los compradores no se esfuercen, sino que tener en cuenta a la vez la estacionalidad, los clientes, las promociones y los plazos de entrega supera la capacidad de una sola cabeza.
¿En qué se diferencia la previsión de demanda con IA de los métodos tradicionales?
El método de pedido tradicional se basa sobre todo en el criterio personal, o en la media móvil (el promedio de las ventas de las últimas semanas o meses) para estimar la demanda del siguiente periodo. La diferencia de la previsión con aprendizaje automático es que puede considerar a la vez un gran número de factores de influencia, genera una previsión para cada SKU y cada grupo de clientes por separado, y se actualiza de forma continua con los nuevos datos.
La siguiente tabla compara las principales diferencias entre ambos tipos de métodos:
| Aspecto | Criterio personal / media móvil | Previsión con aprendizaje automático |
|---|---|---|
| Base | Ventas medias de un periodo pasado y criterio personal | Ventas históricas más múltiples factores de influencia |
| Factores considerados | Normalmente solo las propias ventas | Promociones, precios, estacionalidad, festivos, clima, pedidos de clientes, etc. |
| Cobertura | Las referencias clave se vigilan a mano; el resto, por costumbre | Permite prever todos los SKU uno a uno |
| Promociones y festivos | Dependen de ajustes manuales | Aprende su efecto a partir de los datos históricos |
| Frecuencia de actualización | Ajuste mensual o trimestral | Puede actualizarse cada semana o incluso cada día con datos nuevos |
| Interpretabilidad | Fácil de entender | Requiere mostrar de forma específica los principales factores de influencia |
| Requisitos de datos | Bajos | Exige un histórico razonablemente completo y limpio |
| Escenarios adecuados | Demanda estable y pocas referencias | Muchas referencias, con clara influencia de promociones y estacionalidad |
Conviene subrayar que el aprendizaje automático no siempre es mejor que los métodos sencillos. Con una demanda estable y pocas referencias, la media móvil puede bastar; la ventaja del aprendizaje automático se aprecia sobre todo con muchas referencias y factores de influencia complejos.
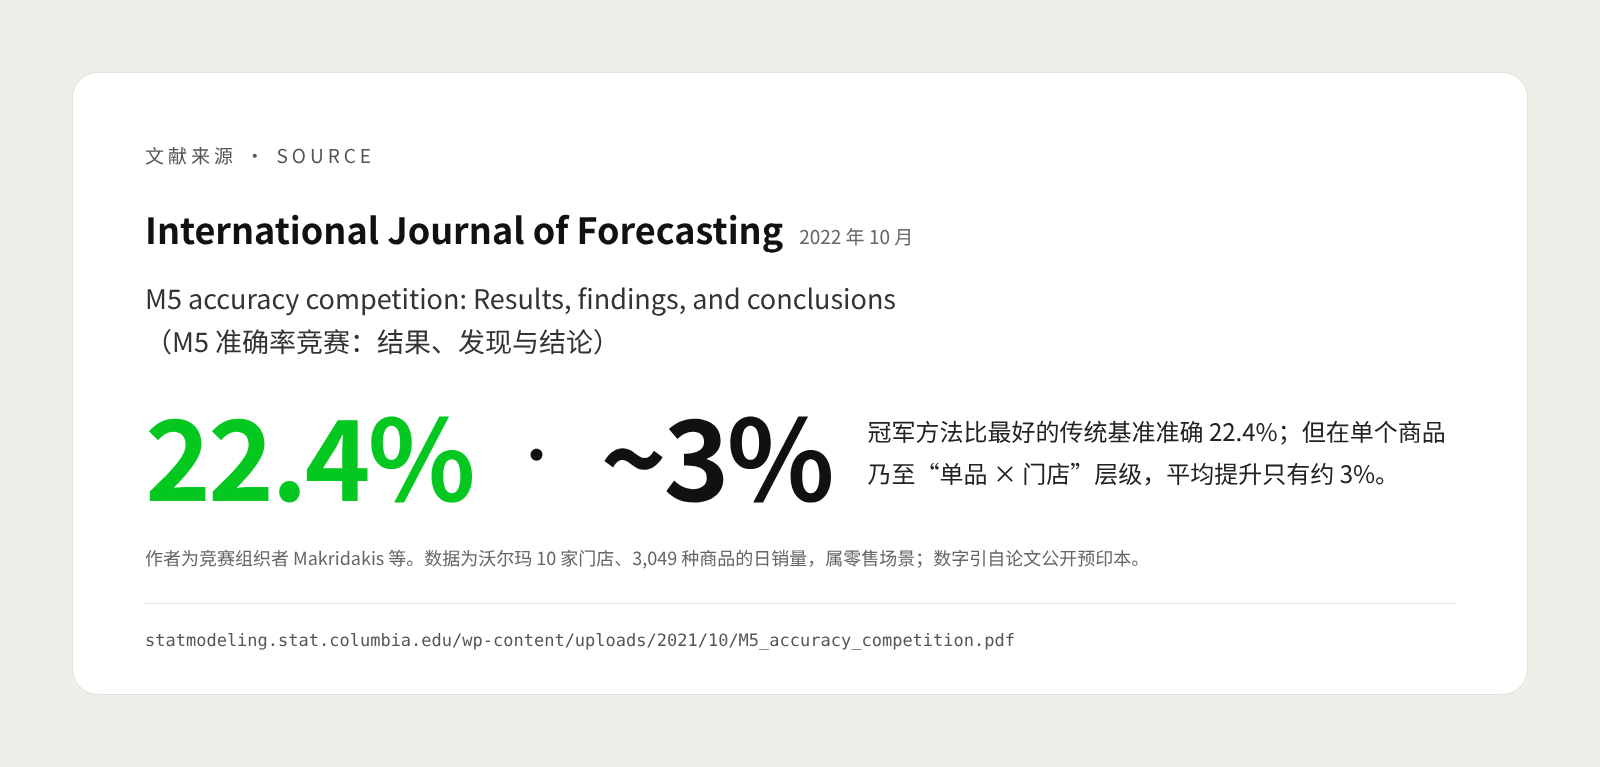
El ámbito académico lo ha contrastado con solidez. En la célebre competición de previsión M5, los participantes debían predecir las ventas diarias de 3.049 productos en 10 tiendas del minorista estadounidense Walmart. Según el artículo de los organizadores publicado en la revista International Journal of Forecasting, el método ganador fue un 22,4 % más preciso que el mejor método de referencia tradicional, la mayoría de los métodos mejor clasificados se basaban en un algoritmo de aprendizaje automático llamado LightGBM, y todas las soluciones premiadas utilizaban información externa como precios, promociones y fechas especiales como los festivos (fuente). Pero el artículo también señala que, cuanto más fino es el nivel, menor es la mejora: a nivel de producto individual, e incluso de «producto × tienda», la mejora media de los métodos frente a la referencia es de solo un 3 % aproximadamente. Estas cifras proceden de un entorno minorista y del preprint público del artículo, y no pueden trasladarse sin más a las empresas de distribución mayorista, pero ilustran dos cosas: la información externa sí es útil, y cuanto más detallada es la previsión, más difícil resulta.
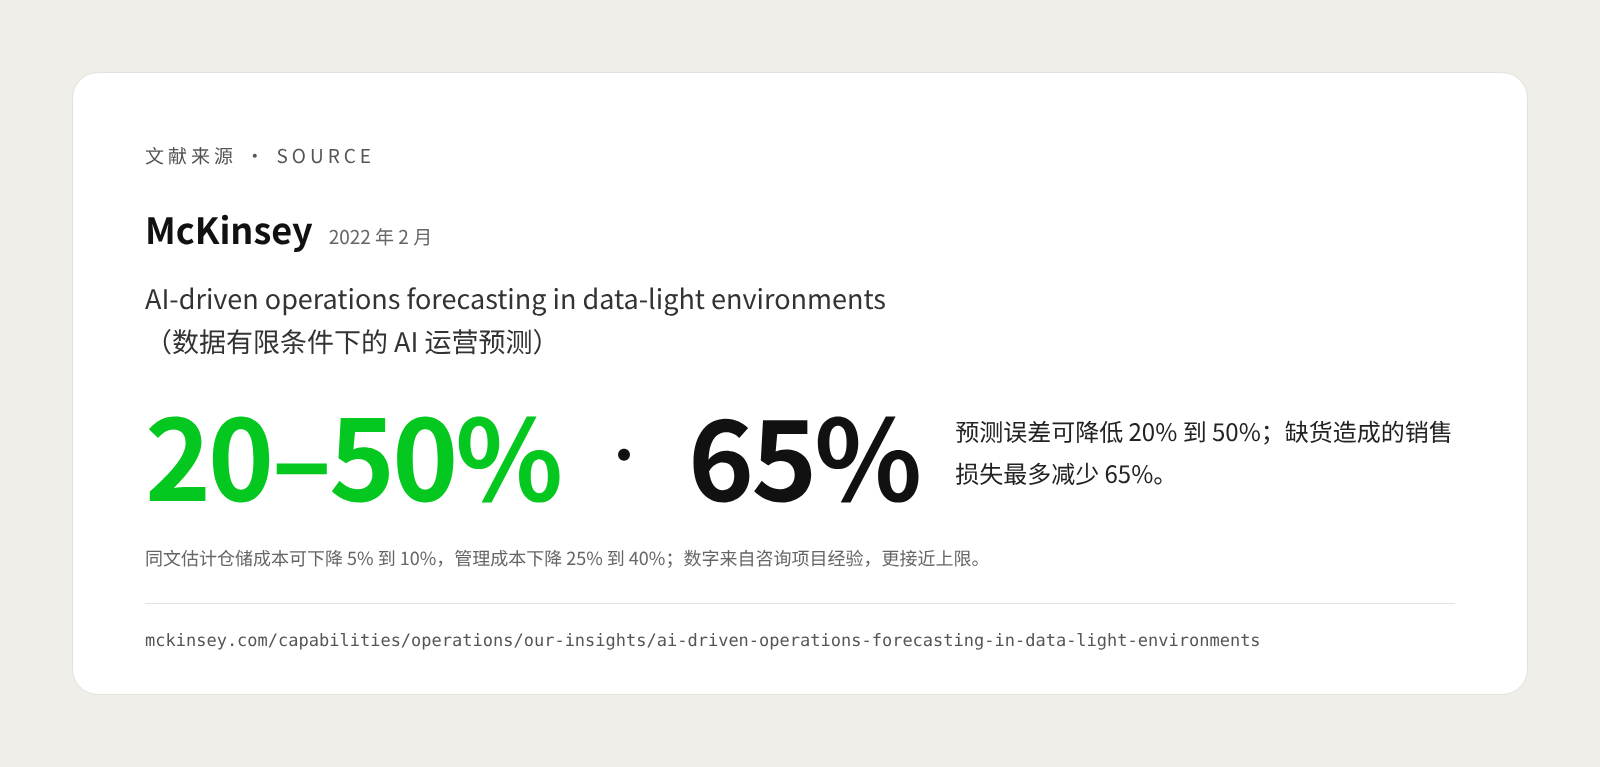
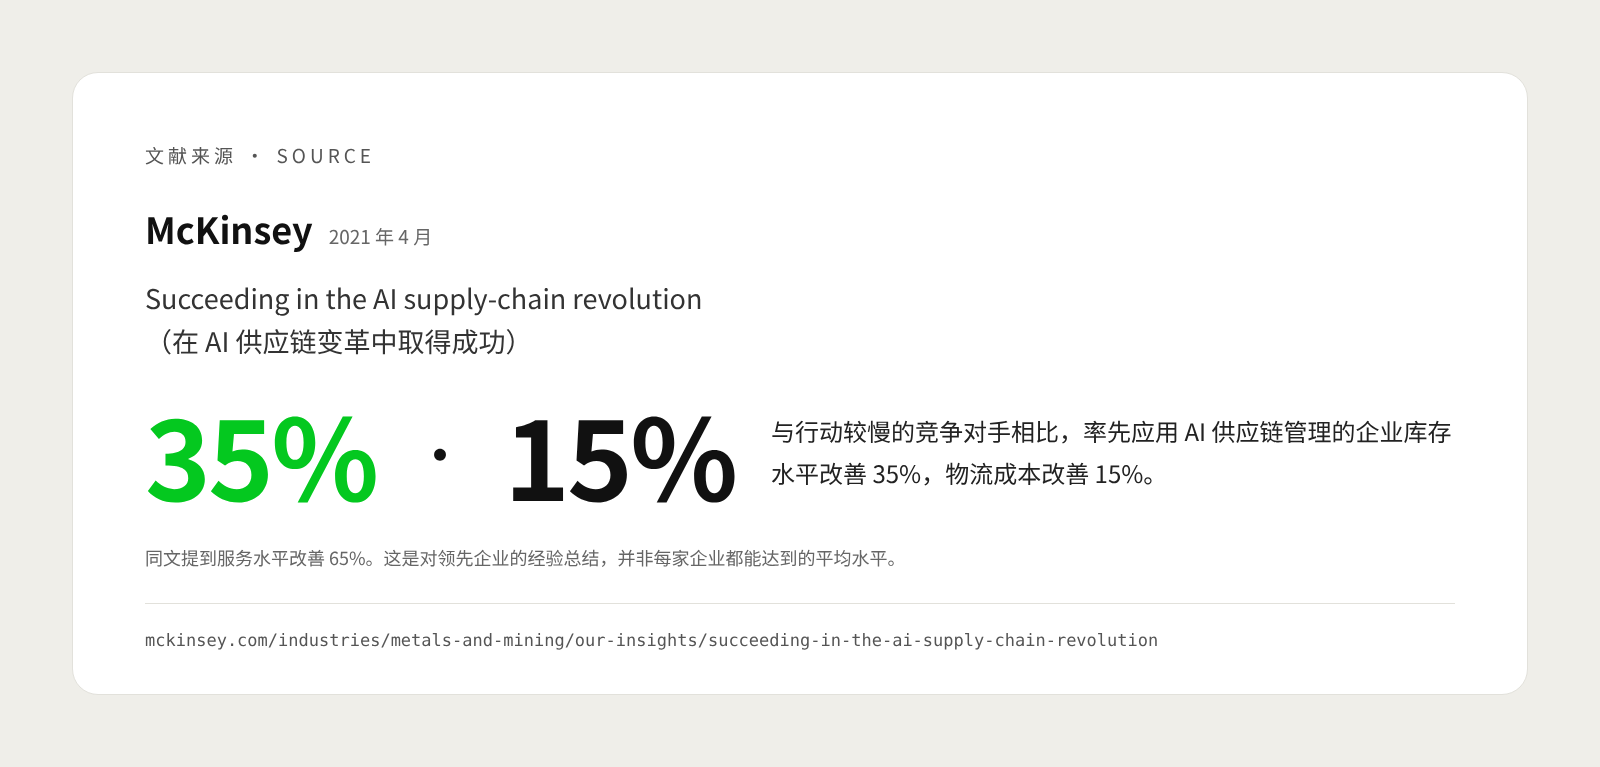
La experiencia en proyectos de las consultoras ofrece cifras más optimistas. El artículo de McKinsey de 2022 «AI-driven operations forecasting in data-light environments» estima que aplicar la previsión con IA a la gestión de la cadena de suministro puede reducir el error de previsión entre un 20 % y un 50 %, disminuir hasta un 65 % las ventas perdidas por roturas de stock, reducir entre un 5 % y un 10 % los costes de almacenamiento y entre un 25 % y un 40 % los costes de administración (fuente). Otro artículo de McKinsey de 2021, «Succeeding in the AI supply-chain revolution», señala que, frente a competidores más lentos, las empresas que fueron las primeras en aplicar con éxito la IA a su cadena de suministro mejoraron un 15 % los costes logísticos, un 35 % los niveles de inventario y un 65 % los niveles de servicio (fuente). Estas cifras son una síntesis de la experiencia de proyectos de consultoría y se acercan más al «techo cuando se hace bien» que al promedio que alcanza cualquier empresa.
¿Qué datos puede utilizar la previsión con IA? ¿En qué casos no funciona?
La eficacia de la previsión con IA depende en gran medida de los datos que se le suministren. Cuanto más cercanos a la demanda real sean los datos, más útil será la previsión; y cuando no existe un histórico en el que apoyarse, hasta el mejor modelo solo puede ofrecer una referencia.
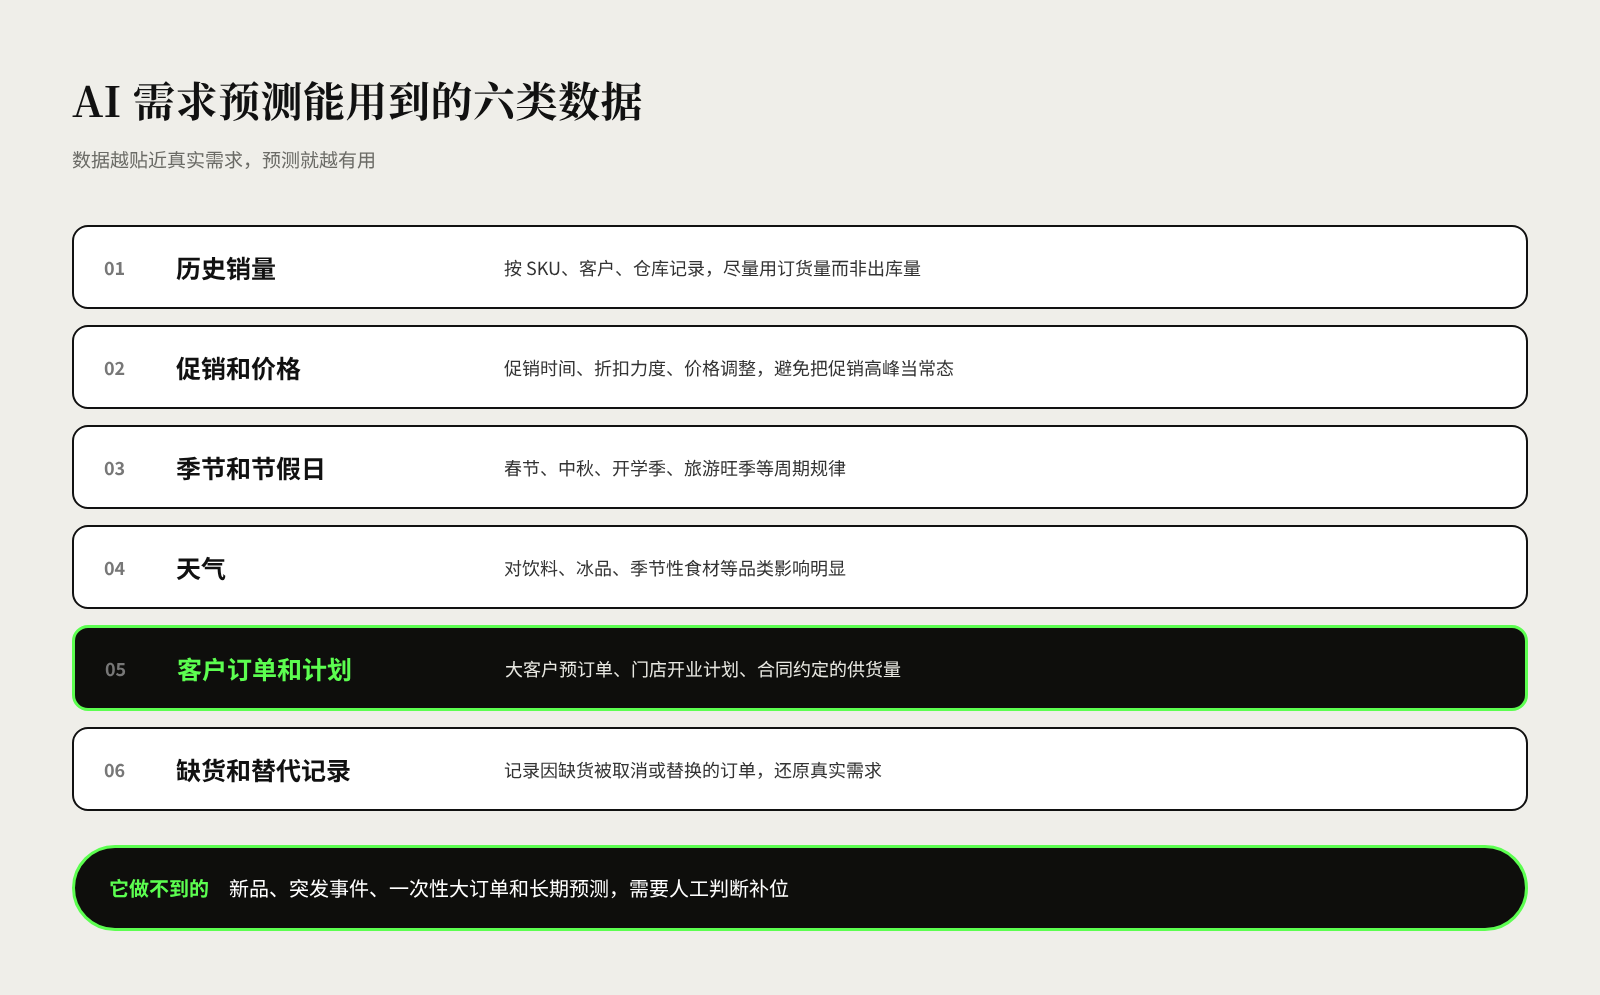
Para una empresa de distribución mayorista, los datos más habituales son:
- Ventas históricas. Es el dato más importante, y lo ideal es registrarlo por SKU, cliente y almacén, por día o por semana. Conviene usar, en la medida de lo posible, las cantidades que pidió el cliente y no solo las efectivamente expedidas, porque las salidas se ven afectadas por las roturas de stock.
- Promociones y precios. Fechas de las promociones, intensidad del descuento y cambios de precio. Sin estos registros, el modelo confundirá los picos provocados por las promociones con demanda normal.
- Estacionalidad y festivos. Año Nuevo chino, Festival del Medio Otoño, vuelta al cole, temporada alta turística, etc. La demanda de muchas categorías tiene patrones periódicos muy marcados.
- Clima. Influye claramente en categorías como las bebidas, los helados o los ingredientes de temporada. McKinsey, en los artículos citados, también sitúa el clima entre los datos externos habituales en la previsión.
- Pedidos y planes de los clientes. Los pedidos anticipados de los grandes clientes, los planes de apertura de tiendas y los volúmenes de suministro fijados por contrato suelen explicar mejor la demanda de las próximas semanas que los datos históricos.
- Registros de roturas de stock y sustituciones. Anotar qué pedidos se cancelaron o se sustituyeron por falta de existencias ayuda a reconstruir la demanda real que quedó reprimida.
Igual de importante es conocer los límites de la previsión con IA:
- Productos nuevos. Sin histórico de ventas, el modelo difícilmente puede predecir de forma directa. Lo habitual es tomar como referencia el historial de productos similares o basarse sobre todo en el criterio humano durante el lanzamiento.
- Imprevistos. Pandemias, fenómenos meteorológicos extremos, interrupciones del suministro o una bajada repentina de precios de la competencia son sucesos de los que no se puede aprender a partir de datos históricos. McKinsey también advierte de que periodos anómalos como el de la pandemia perturban los modelos y exigen suavizar los datos o tratarlos por separado; cuando la demanda fluctúa con fuerza, un modelo que depende en exceso del histórico deja de funcionar.
- Pedidos grandes y puntuales. La compra masiva ocasional de un cliente, si no se etiqueta, hará que el modelo sobrestime la demanda posterior.
- Previsiones a largo plazo. Cuanto más largo es el horizonte de previsión, mayor es la incertidumbre. La IA se desenvuelve mejor en previsiones móviles de unas semanas a unos meses.
Por ejemplo, cuando un distribuidor de droguería incorporó un nuevo detergente en cápsulas, el modelo no pudo ofrecer una previsión fiable; el equipo de compras puede basarse en la curva de lanzamiento de otras novedades de la misma marca para fijar el primer pedido y traspasar poco a poco la tarea al modelo cuando se hayan acumulado unas semanas de ventas reales.
¿Cómo medir si la previsión es acertada?
Medir la precisión de la previsión sirve para juzgar si está mejorando y si merece confianza, no para perseguir una cifra bonita. Lo más importante no es qué indicador se elija, sino compararlo de forma continua con una línea base, usando el mismo indicador y el mismo criterio.
El indicador más común es el MAPE (error porcentual absoluto medio). Su significado es intuitivo: en cada periodo, qué porcentaje se ha desviado la previsión respecto a lo real, y después se calcula el promedio. Por ejemplo, si un producto vendió realmente 100 cajas y la previsión era de 80, el error de ese periodo es del 20 %. Cuanto más bajo es el MAPE, más precisa es la previsión.
Pero el MAPE tiene un defecto muy relevante para las empresas de distribución. El manual de previsión «Forecasting: Principles and Practice», escrito por académicos de la Universidad de Monash (Monash University), señala que cuando las ventas reales son cero no se puede calcular el error porcentual, que cuando son casi cero el error se vuelve enorme y que penaliza de forma asimétrica la sobreestimación y la subestimación (fuente). Las empresas de distribución mayorista tienen muchísimos SKU de cola larga, y muchos productos no registran ventas en determinados días o semanas, por lo que calcular el MAPE directamente da resultados distorsionados con facilidad.
Por eso, en la práctica se pueden combinar los siguientes enfoques:
- Error absoluto medio (MAE). Calcula directamente cuántas unidades o cajas se desvía de media la previsión respecto a lo real; la unidad coincide con la del negocio y es fácil de entender.
- Error ponderado por ventas. Suma los errores de todos los productos y los divide entre las ventas totales; los productos más vendidos pesan más, lo que se acerca más al impacto real sobre el negocio.
- Comparación con métodos sencillos. El MASE (error absoluto escalado medio), que presenta el manual citado, compara el error del modelo con el del método más simple, usar las ventas del periodo anterior como previsión; un resultado inferior a 1 indica que el modelo supera al método sencillo.
- Sesgo. Consiste en ver si la previsión tiende a ser sistemáticamente alta o baja. Un sesgo alto constante provoca excedentes y uno bajo, roturas de stock, y merece más atención que el mero tamaño del error.
Por último, la precisión de la previsión es solo un indicador intermedio. Lo que realmente hay que mirar es si han mejorado los resultados de negocio: tasa de roturas de stock, días de rotación del inventario, importe de las mermas por caducidad y tasa de cumplimiento de pedidos.
¿Cómo implantar paso a paso la previsión con IA y la reposición inteligente? Guía por pasos
Implantar la previsión con IA no exige cubrir todos los productos desde el principio. Demostrar primero el efecto en unos pocos SKU clave y ampliar el alcance de forma gradual es el camino de menor riesgo y el que más fácilmente obtiene el respaldo del equipo.
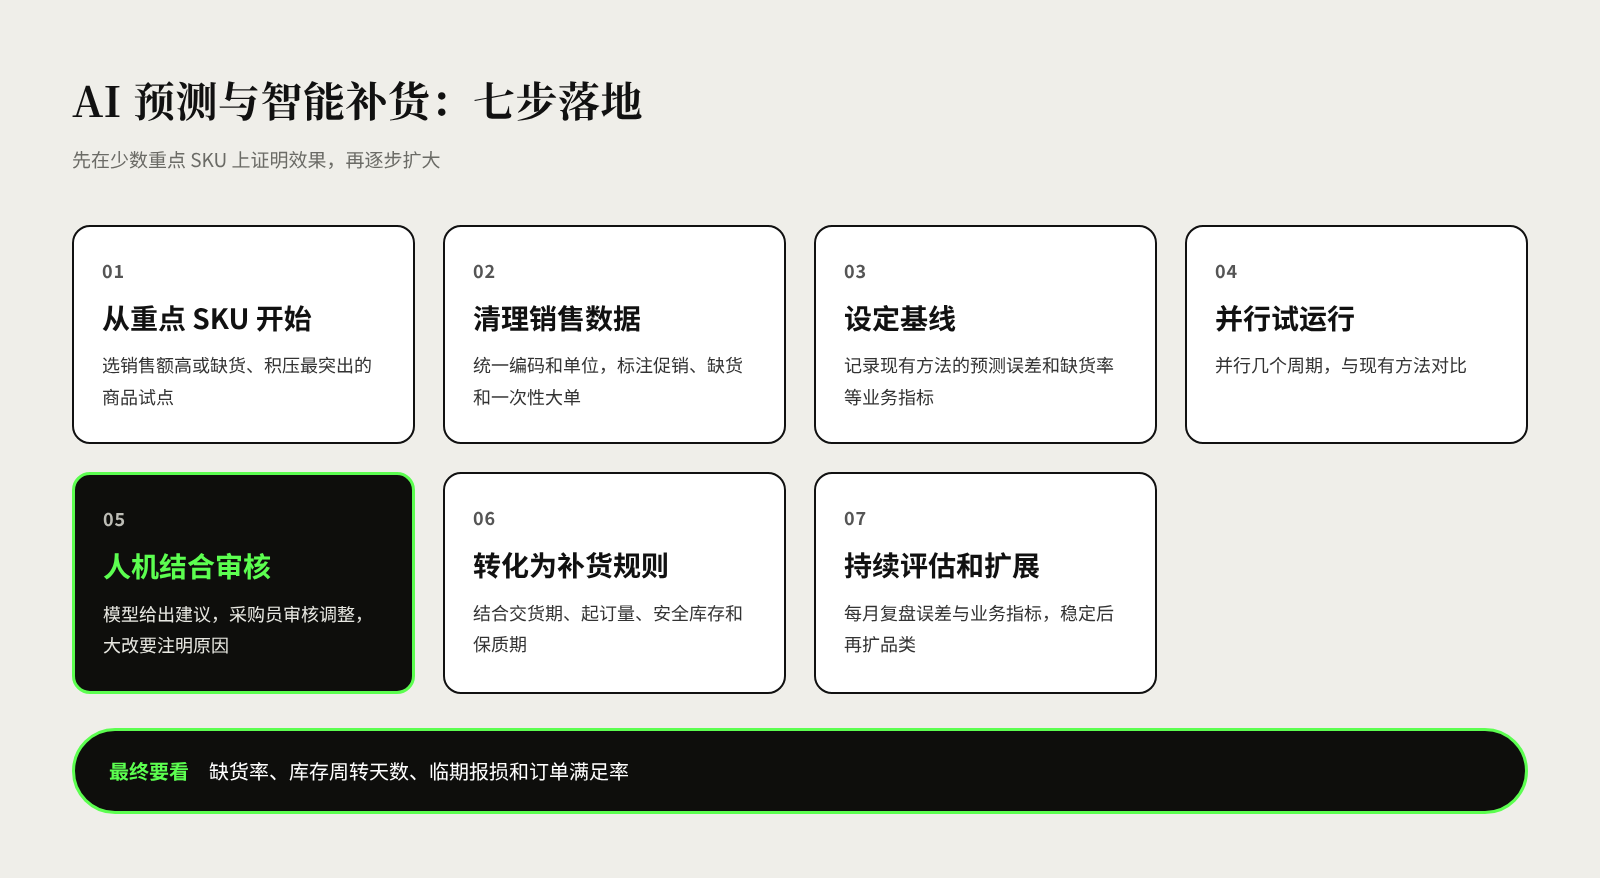
Paso 1: empezar por unos pocos SKU clave. Selecciona entre unas decenas y uno o dos centenares de SKU con un gran peso en las ventas, o en los que los problemas de roturas y excedentes sean más acusados, y utilízalos como primer grupo piloto. Por ejemplo, elige los productos con más ventas y añade las categorías con más mermas en el último medio año.
Paso 2: limpiar y ordenar los datos de ventas. Exporta al menos uno o dos años de pedidos históricos, unifica los códigos de producto y las unidades de medida, marca los periodos de promoción, los periodos de rotura de stock y los pedidos grandes y puntuales, y elimina las devoluciones y los traspasos internos. La limpieza de datos suele ser el paso que más tiempo lleva y el que más decide el éxito.
Paso 3: fijar una línea base. Antes de incorporar la IA, registra el error de previsión del método actual (la experiencia del comprador o la media móvil), así como indicadores de negocio como la tasa de roturas de stock, los días de rotación del inventario y las mermas por caducidad. Sin línea base no se puede juzgar si la IA ha aportado realmente una mejora.
Paso 4: prueba piloto a pequeña escala, comparando con el método actual. Deja que el modelo y el método actual funcionen en paralelo durante varios ciclos de pedido y compara su rendimiento con el mismo conjunto de indicadores. En esta fase no hace falta pedir de inmediato según el resultado del modelo; lo importante es observar en qué productos funciona bien y en cuáles mal.
Paso 5: establecer un mecanismo de revisión que combine personas y máquina. El modelo propone las cantidades a pedir y el comprador las revisa y ajusta, sobre todo en productos nuevos, en productos en promoción y en los que se sabe que tienen circunstancias especiales. Pide a los compradores que, ante una modificación importante, anoten brevemente el motivo, por ejemplo: «el mes que viene un gran cliente abre dos tiendas nuevas». Esas notas mejoran la calidad de la decisión del momento y son información muy valiosa para perfeccionar el modelo.
Paso 6: convertir la previsión en reglas de reposición. La previsión solo responde a «cuánto se venderá»; la reposición también debe responder a «cuánto pedir y cuándo». Hay que definir reglas de reposición claras que tengan en cuenta el plazo de entrega del proveedor, el pedido mínimo, el stock de seguridad, la capacidad de almacenamiento y la caducidad. Por ejemplo, para los productos de caducidad corta, fija un stock de seguridad más bajo y pedidos más frecuentes y de menor tamaño.
Paso 7: evaluar y ampliar de forma continua. Cada mes, revisa el error de previsión, el sesgo y los indicadores de negocio, y analiza las causas en los productos con mayor error. Cuando el resultado en los SKU piloto sea estable, amplía poco a poco a más categorías y almacenes, y actualiza el modelo periódicamente con datos nuevos.
Preguntas frecuentes sobre la previsión de demanda con IA y la reposición inteligente
¿Tienen las pequeñas y medianas empresas de distribución datos suficientes para la previsión con IA? En la mayoría de los casos, sí. Con uno o dos años de pedidos registrados por SKU ya se puede empezar por los productos clave. McKinsey, en los artículos citados, también considera que, aunque los datos sean limitados, los de la mayoría de las empresas bastan para beneficiarse de la previsión con IA, aunque hay que elegir métodos adecuados para volúmenes de datos pequeños.
¿Sustituirá la previsión con IA a los compradores? No, pero el foco de su trabajo cambiará. Los cálculos diarios y las propuestas de reposición se encargan al sistema, y los compradores dedican su energía a negociar con proveedores, incorporar productos nuevos, gestionar excepciones y valorar la demanda de los grandes clientes.
¿A partir de qué precisión se considera buena una previsión? No existe un estándar único; la dificultad de la previsión varía mucho según la categoría y el nivel. Lo más práctico es compararse con la propia línea base y comprobar si el error baja de forma sostenida y si las roturas y los excedentes disminuyen a la vez.
¿Hay que implantar antes un nuevo ERP o un sistema específico? No necesariamente. Mientras se puedan exportar de los sistemas actuales los datos completos de pedidos, inventario y productos, se puede empezar el piloto. Pero si los datos de pedidos y de inventario están dispersos en varias hojas de cálculo con criterios incoherentes, ordenar primero la base de datos suele ser más urgente que incorporar una herramienta de previsión.
Referencias
- AI-driven operations forecasting in data-light environments, McKinsey, febrero de 2022
- Succeeding in the AI supply-chain revolution, McKinsey, abril de 2021
- M5 accuracy competition: Results, findings, and conclusions (preprint completo), Makridakis, Spiliotis, Assimakopoulos, International Journal of Forecasting, octubre de 2022 (información de la revista)
- Forecasting: Principles and Practice (3.ª edición): evaluación de la precisión de las previsiones, Rob J Hyndman, George Athanasopoulos, Monash University, consultado en noviembre de 2026


