Für Großhändler ist der Bestand der größte Posten im Umlaufvermögen – und der am schwersten zu steuernde. Im Lager stapeln sich Ladenhüter und Ware kurz vor Ablauf des Mindesthaltbarkeitsdatums, während zugleich ein Verkaufsschlager fehlt, den Kunden dringend brauchen. Viele Unternehmen bestellen noch immer nach der Erfahrung ihrer Einkäufer und mithilfe einer Excel-Tabelle; wechselt die Person, gerät der Rhythmus durcheinander. Der Sinn einer KI-Bedarfsprognose liegt nicht darin, eine „zielgenaue“ Zahl zu liefern, sondern darin, das Bestellen von einer Bauchentscheidung zu einer fundierten, überprüfbaren und kontinuierlich verbesserbaren Entscheidung zu machen.
Wo genau ist die KI-Prognose den klassischen Methoden überlegen, was kann sie leisten und was nicht, und wie sollten Unternehmen starten? In diesem Beitrag behandeln wir die Ursachen von Bestandsproblemen im Großhandel, den Unterschied zwischen klassischen Methoden und maschinellen Prognosen, die Daten, die eine KI-Prognose nutzen kann, und ihre Grenzen, die Frage, wie sich die Prognosegüte messen lässt, sowie ein schrittweises Vorgehen, das mit wenigen wichtigen SKUs beginnt.
Warum haben Großhändler oft „zu wenig und zu viel zugleich“ auf Lager?
Dass Fehlbestände und Überbestände gleichzeitig auftreten, wirkt widersprüchlich, ist aber in Wahrheit zwei Seiten desselben Problems. Die Ursache ist eine systematische Abweichung zwischen der bestellten Menge und dem tatsächlichen Bedarf – die meisten Unternehmen sehen diese Abweichung weder, noch können sie sie fortlaufend korrigieren.
Die Bestandsprobleme im Großhandel haben in der Regel mehrere Ursachen:
- Viele Artikel, viele Kunden – kaum zu überblicken. Händler führen oft eine große Zahl von SKUs (Bestandseinheiten) und beliefern zahlreiche Filialen, Restaurants oder nachgelagerte Händler. Einkäufer können nur einige Dutzend Top-Artikel im Blick behalten; der Rest wird meist nach Gewohnheit nachbestellt.
- Schwankungen werden entlang der Lieferkette verstärkt. Nachgelagerte Kunden bestellen häufig in großen Chargen und decken sich gebündelt ein; vor Feiertagen und in Aktionszeiträumen springen die Bestellmengen plötzlich nach oben. Wird eine solche kurzfristige Spitze als Normalfall behandelt, wird in der nächsten Runde zu viel bestellt; wer umgekehrt saisonale Muster ignoriert, hat in der Hochsaison Fehlbestände.
- Hoher Druck durch Restlaufzeiten und Schwund. Lebensmittel, Getränke und Haushaltschemie haben ein Verfallsdatum. Zu große Bestellmengen binden nicht nur Kapital, sondern führen auch zu Abverkauf kurz vor Ablauf oder zu Totalabschreibungen.
- Lückenhafte Erfassung von Fehlmengen. Ist beim Kundenwunsch nichts auf Lager, wird die Bestellung oft storniert oder auf einen anderen Artikel umgestellt. Im System steht dann nur, „wie viel verkauft wurde“, nicht aber, „wie viel gekauft werden sollte“. Wer mit solchen Daten bestellt, unterschätzt den Bedarf bei Verkaufsschlagern fortwährend.
- Abhängigkeit von persönlicher Erfahrung. Erfahrung ist in stabilen Umfeldern sehr wertvoll, lässt sich aber kaum übertragen – und die Frage „Wie viel bestellen wir diesmal, und warum?“ ist damit schwer zu beantworten.
Ein Beispiel: Ein Tiefkühlgroßhändler, der Gastronomiebetriebe beliefert, bevorratet sich vor dem chinesischen Neujahrsfest mit den Mengen des Vorjahres. Weil mehrere Großkunden in diesem Jahr früher einkauften, sind schon zwei Wochen vor dem Fest einzelne Artikel ausverkauft. Nach den Feiertagen wird dann auf Basis der Vorfeiertagsspitze nachbestellt – und manche Artikel stauen sich bis kurz vor Ablauf der Haltbarkeit. Das Problem liegt nicht an mangelndem Einsatz der Einkäufer, sondern daran, dass es die menschliche Leistungsfähigkeit übersteigt, Saison, Kunden, Aktionen und Lieferzeiten gleichzeitig im Kopf zu behalten.
Worin unterscheidet sich die KI-Bedarfsprognose von klassischen Methoden?
Die klassische Bestellung beruht meist auf Erfahrungswerten oder auf dem gleitenden Durchschnitt (dem Mittel der Absatzmengen der letzten Wochen oder Monate), aus dem der Bedarf der nächsten Periode abgeleitet wird. Maschinelle Prognosen unterscheiden sich darin, dass sie viele Einflussfaktoren gleichzeitig berücksichtigen können, für jede SKU und jede Kundengruppe eine eigene Prognose erstellen und sich mit neuen Daten laufend aktualisieren.
Die folgende Tabelle stellt die wichtigsten Unterschiede der beiden Ansätze gegenüber:
| Vergleichskriterium | Erfahrungswert / gleitender Durchschnitt | Maschinelle Prognose |
|---|---|---|
| Grundlage | Durchschnittlicher Absatz der letzten Zeit und persönliche Einschätzung | Absatzhistorie plus verschiedene Einflussfaktoren |
| Berücksichtigte Faktoren | In der Regel nur die Absatzmenge selbst | Aktionen, Preise, Saison, Feiertage, Wetter, Kundenbestellungen usw. |
| Abdeckung | Wichtige Artikel werden manuell überwacht, der Rest nach Gewohnheit | Alle SKUs können einzeln prognostiziert werden |
| Umgang mit Aktionen und Feiertagen | Manuelle Anpassung nötig | Lernt den Einfluss aus historischen Daten |
| Aktualisierungsfrequenz | Monatliche oder quartalsweise Anpassung | Wöchentlich oder sogar täglich mit neuen Daten möglich |
| Nachvollziehbarkeit | Leicht verständlich | Haupteinflussfaktoren müssen gesondert dargestellt werden |
| Anforderungen an die Daten | Gering | Vollständige, saubere Historie erforderlich |
| Geeignete Szenarien | Stabiler Bedarf, wenige Artikel | Viele Artikel, deutlicher Einfluss von Aktionen und Saison |
Wichtig ist: Maschinelles Lernen ist nicht immer besser als einfache Methoden. Bei stabilem Bedarf und wenigen Artikeln kann der gleitende Durchschnitt völlig ausreichen; die Stärke maschineller Verfahren zeigt sich vor allem bei vielen Artikeln und komplexen Einflussfaktoren.
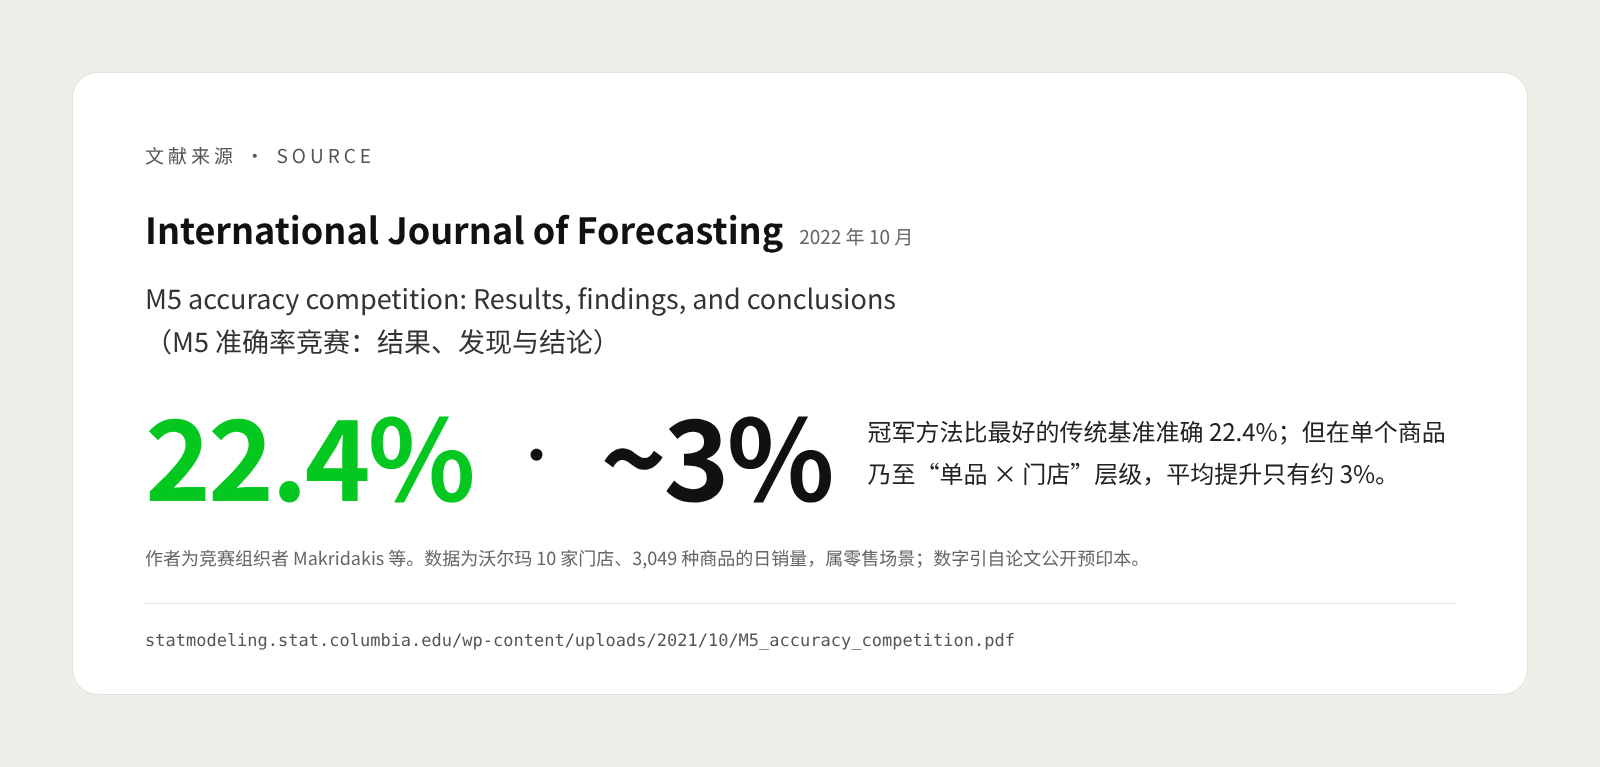
Die Wissenschaft hat dies solide belegt. Beim bekannten M5-Prognosewettbewerb sollten die Teilnehmer die tägliche Absatzmenge von 3.049 Produkten in 10 Filialen des US-Einzelhändlers Walmart vorhersagen. Der von den Veranstaltern im International Journal of Forecasting veröffentlichte Beitrag zeigt: Die Siegermethode war 22,4 % genauer als der beste klassische Benchmark, die meisten der bestplatzierten Methoden basierten auf dem Machine-Learning-Algorithmus LightGBM, und alle prämierten Lösungen nutzten externe Informationen wie Preise, Aktionen und besondere Kalendertage wie Feiertage (Quelle). Der Beitrag weist aber auch darauf hin, dass der Zugewinn mit zunehmender Detailtiefe schrumpft: Auf Ebene einzelner Produkte bis hin zu „Produkt × Filiale“ lag die durchschnittliche Verbesserung der Methoden gegenüber dem Benchmark nur bei rund 3 %. Diese Zahlen stammen aus dem Einzelhandel und dem öffentlich zugänglichen Preprint des Beitrags und lassen sich nicht unmittelbar auf Großhandelsunternehmen übertragen; sie zeigen jedoch zweierlei: Externe Informationen helfen tatsächlich, und je feiner die Prognose, desto schwieriger ist sie.
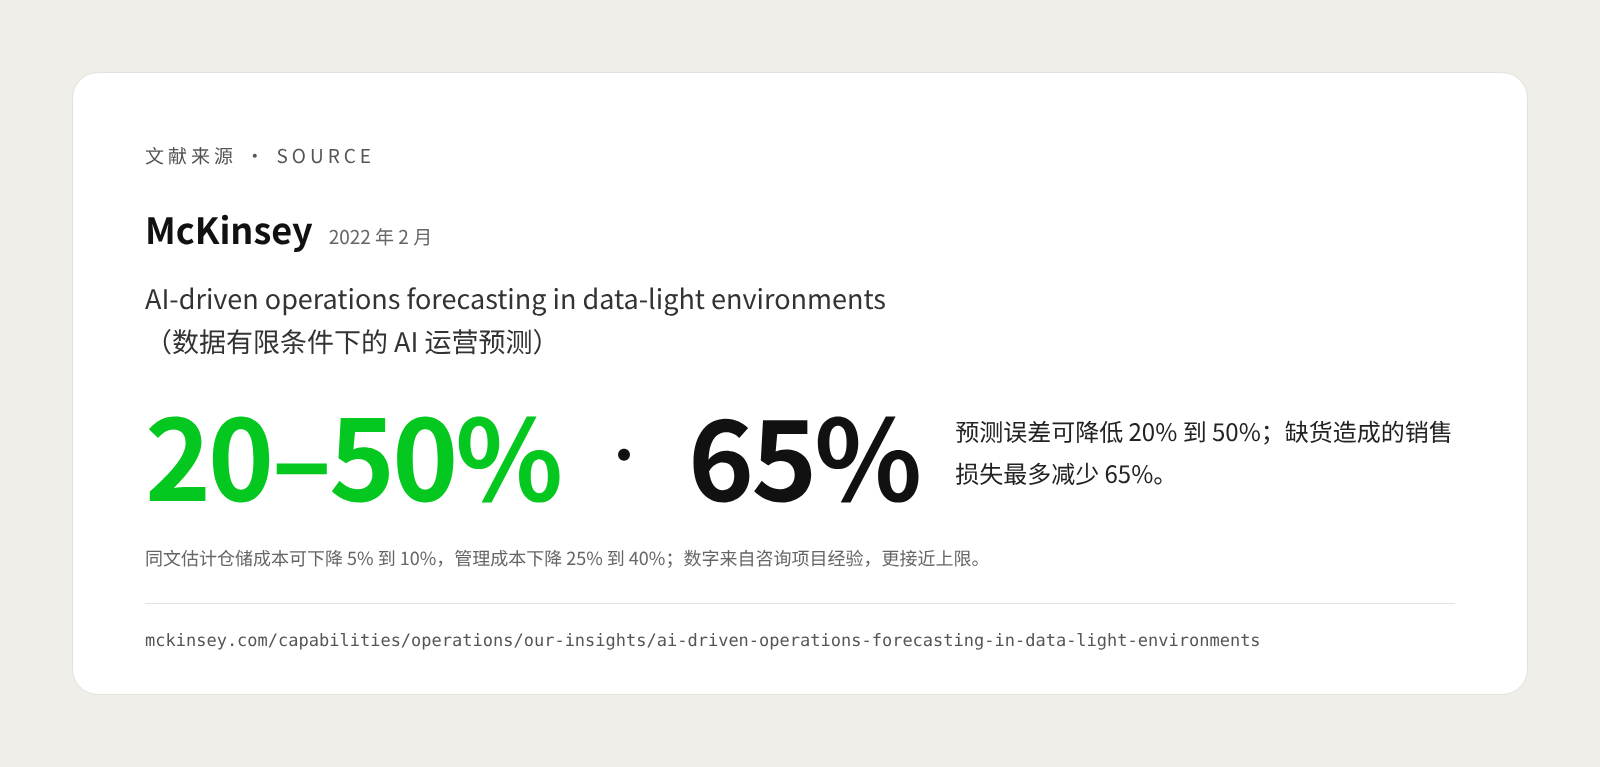
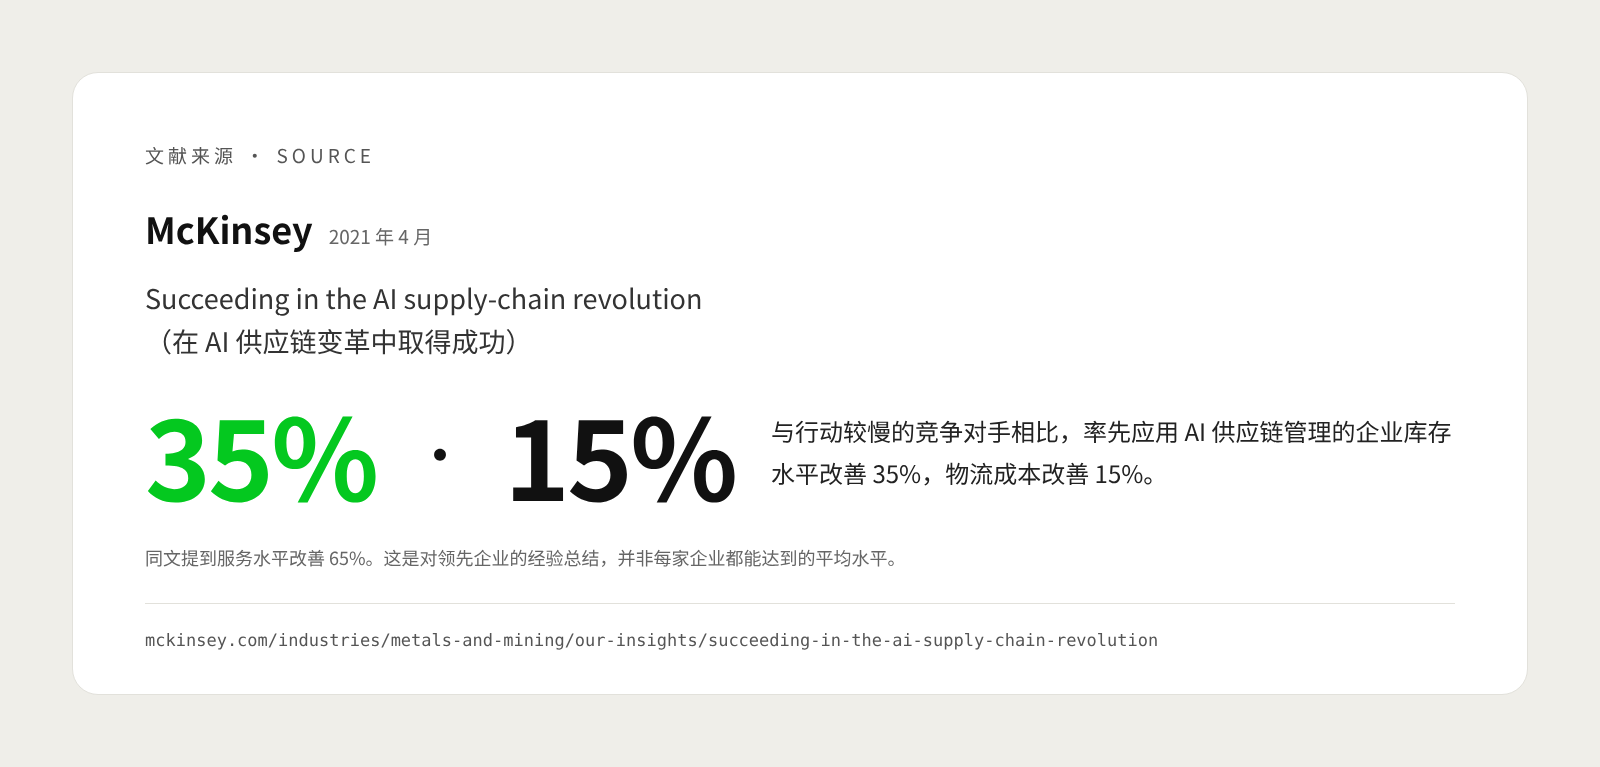
Erfahrungen aus Beratungsprojekten liefern optimistischere Zahlen. In ihrem Artikel „AI-driven operations forecasting in data-light environments“ von 2022 schätzt McKinsey, dass sich durch den Einsatz von KI-Prognosen im Supply-Chain-Management die Prognosefehler um 20 bis 50 % senken lassen, durch Fehlbestände bedingte Umsatzverluste um bis zu 65 % sinken, die Lagerkosten um 5 bis 10 % und die Verwaltungskosten um 25 bis 40 % (Quelle). Ein weiterer McKinsey-Artikel von 2021, „Succeeding in the AI supply-chain revolution“, nennt, dass Unternehmen, die KI im Supply-Chain-Management als Erste erfolgreich einsetzten, gegenüber langsameren Wettbewerbern ihre Logistikkosten um 15 %, ihr Bestandsniveau um 35 % und ihr Serviceniveau um 65 % verbessert haben (Quelle). Diese Zahlen sind aus Beratungsprojekten abgeleitete Erfahrungswerte; sie entsprechen eher der „Obergrenze bei guter Umsetzung“ als dem Durchschnitt, den jedes Unternehmen erreicht.
Welche Daten kann eine KI-Prognose nutzen – und wo stößt sie an Grenzen?
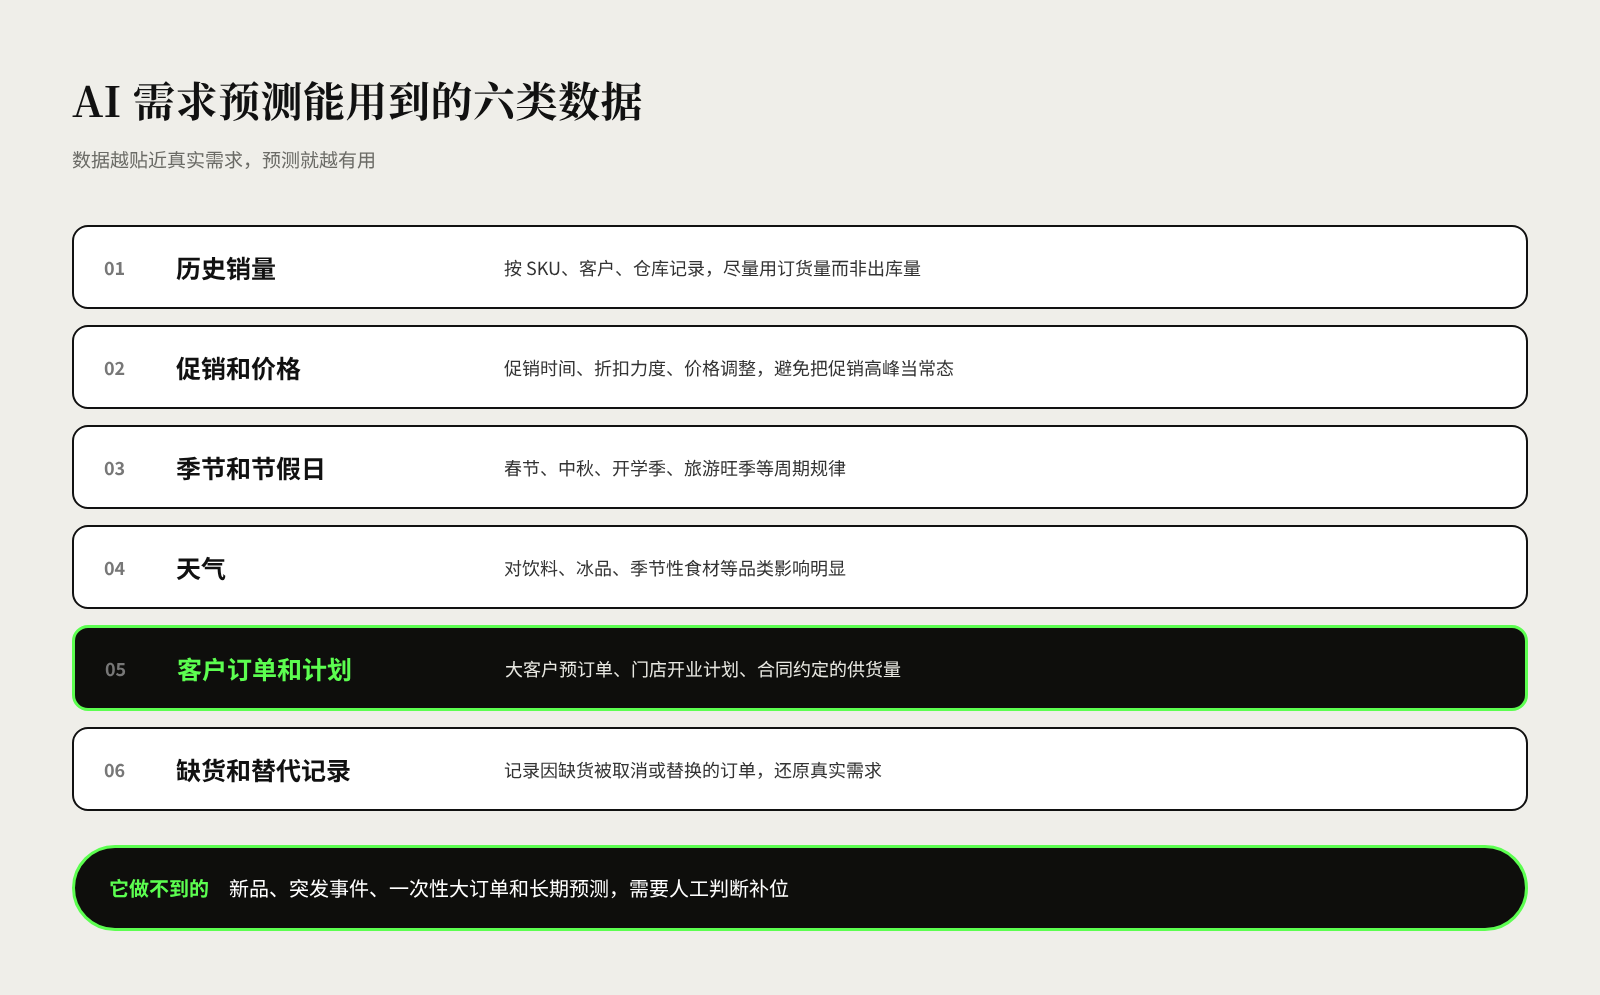
Die Wirkung einer KI-Prognose hängt maßgeblich von den Daten ab, mit denen sie gespeist wird. Je näher die Daten am tatsächlichen Bedarf liegen, desto nützlicher ist die Prognose; wo es keine Historie gibt, kann selbst das beste Modell nur Anhaltspunkte liefern.
Für Großhandelsunternehmen kommen in der Regel folgende Daten infrage:
- Absatzhistorie. Die wichtigste Datengrundlage, idealerweise nach SKU, Kunde und Lager sowie täglich oder wöchentlich erfasst. Nach Möglichkeit sollten die bestellten Mengen der Kunden verwendet werden und nicht nur die tatsächlich ausgelieferten, denn die Liefermengen werden durch Fehlbestände verzerrt.
- Aktionen und Preise. Aktionszeiträume, Rabatthöhe, Preisanpassungen. Fehlen diese Angaben, hält das Modell aktionsbedingte Spitzen irrtümlich für normalen Bedarf.
- Saison und Feiertage. Neujahrsfest, Mondfest, Schulbeginn, touristische Hochsaison und Ähnliches. Bei vielen Warengruppen folgt der Bedarf deutlichen zyklischen Mustern.
- Wetter. Es wirkt sich spürbar auf Getränke, Eis und saisonale Zutaten aus. McKinsey nennt das Wetter in dem oben genannten Artikel ebenfalls als eine der gängigen externen Datenquellen für Prognosen.
- Kundenbestellungen und Planungen. Vorbestellungen großer Kunden, geplante Filialeröffnungen und vertraglich vereinbarte Liefermengen sagen über den Bedarf der kommenden Wochen oft mehr aus als die Historie.
- Fehlmengen und Ersatzlieferungen. Die Erfassung, welche Bestellungen wegen Fehlbeständen storniert oder ersetzt wurden, hilft dabei, den unterdrückten tatsächlichen Bedarf zu rekonstruieren.
Ebenso wichtig ist es, die Grenzen der KI-Prognose zu kennen:
- Neuprodukte. Für Artikel ohne Absatzhistorie kann das Modell kaum direkt prognostizieren. Üblich ist es, sich an der Historie ähnlicher Produkte zu orientieren oder in der Anfangsphase überwiegend auf manuelle Einschätzung zu setzen.
- Unvorhergesehene Ereignisse. Pandemien, extreme Wetterlagen, Lieferunterbrechungen oder plötzliche Preissenkungen von Wettbewerbern lassen sich aus historischen Daten nicht lernen. McKinsey weist zudem darauf hin, dass Ausnahmezeiten wie die Pandemie die Modelle stören und die Daten geglättet oder gesondert behandelt werden müssen; bei starken Nachfrageschwankungen versagen Modelle, die sich zu stark auf historische Daten stützen.
- Einmalige Großaufträge. Ein zufälliger Großeinkauf eines Kunden führt, wenn er nicht gekennzeichnet wird, dazu, dass das Modell den späteren Bedarf überschätzt.
- Langfristprognosen. Je länger der Prognosehorizont, desto größer die Unsicherheit. KI eignet sich besser für rollierende Prognosen über einige Wochen bis Monate.
Ein Beispiel: Führt ein Haushaltschemie-Großhändler ein neues Waschmittel-Pod ein, kann das Modell keine verlässliche Prognose liefern. Das Einkaufsteam kann die Einführungskurven anderer Neuprodukte derselben Marke heranziehen, um die Erstbestellmenge festzulegen, und das Modell erst dann schrittweise übernehmen lassen, wenn sich einige Wochen echte Verkaufsdaten angesammelt haben.
Wie lässt sich messen, ob die Prognose stimmt?
Die Messung der Prognosegüte soll zeigen, ob sich die Prognose verbessert und ob man ihr vertrauen kann – nicht, eine schöne Zahl zu erzielen. Entscheidend ist nicht, welche Kennzahl man wählt, sondern dass man durchgängig dieselbe Kennzahl nach derselben Berechnungsweise verwendet und stets mit einer Basislinie vergleicht.
Die gebräuchlichste Kennzahl ist der MAPE (Mean Absolute Percentage Error, mittlerer absoluter prozentualer Fehler). Seine Bedeutung ist anschaulich: Man ermittelt, um wie viel Prozent Prognose und Ist-Wert in jeder Periode voneinander abweichen, und bildet daraus den Durchschnitt. Wurden beispielsweise 100 Kartons eines Artikels verkauft und lag die Prognose bei 80 Kartons, beträgt der Fehler dieser Periode 20 %. Je niedriger der MAPE, desto genauer die Prognose.
Der MAPE hat jedoch einen Nachteil, der für Händler besonders ins Gewicht fällt. Das von Wissenschaftlern der Monash University verfasste Lehrbuch „Forecasting: Principles and Practice“ weist darauf hin, dass sich der prozentuale Fehler nicht berechnen lässt, wenn der tatsächliche Absatz null ist, dass der Fehler extrem groß wird, wenn der tatsächliche Absatz nahe null liegt, und dass Über- und Unterschätzungen nicht symmetrisch bestraft werden (Quelle). Großhändler führen eine Vielzahl von Long-Tail-SKUs, von denen viele an manchen Tagen oder in manchen Wochen überhaupt nicht verkauft werden; wer hier direkt den MAPE berechnet, erhält leicht verzerrte Ergebnisse.
In der Praxis bieten sich daher mehrere Ansätze in Kombination an:
- Mittlerer absoluter Fehler (MAE). Er berechnet direkt, um wie viele Stück oder Kartons Prognose und Ist-Wert im Durchschnitt abweichen; die Einheit entspricht dem Geschäft und ist leicht verständlich.
- Nach Absatz gewichteter Fehler. Die Fehler aller Artikel werden summiert und durch den Gesamtabsatz geteilt. Verkaufsstarke Artikel haben so mehr Gewicht, was den tatsächlichen Einfluss auf das Geschäft besser abbildet.
- Vergleich mit einfachen Methoden. Der MASE (Mean Absolute Scaled Error, mittlerer absoluter skalierter Fehler), den das genannte Lehrbuch vorstellt, setzt den Fehler des Modells ins Verhältnis zur einfachsten Methode, nämlich den Absatz der Vorperiode als Prognose zu verwenden; ein Wert unter 1 zeigt, dass das Modell besser ist als die einfache Methode.
- Bias. Er zeigt, ob die Prognose dauerhaft zu hoch oder dauerhaft zu niedrig liegt. Dauerhaft zu hohe Prognosen führen zu Überbeständen, dauerhaft zu niedrige zu Fehlbeständen – das verdient mehr Aufmerksamkeit als die bloße Größe des Fehlers.
Schließlich ist die Prognosegenauigkeit nur eine Zwischenkennzahl. Entscheidend ist, ob sich die Geschäftsergebnisse verbessern: Fehlbestandsquote, Lagerreichweite in Tagen, Abschreibungen wegen ablaufender Haltbarkeit und Lieferfähigkeit.
Wie gelingt die Einführung von KI-Prognose und intelligenter Nachschubplanung Schritt für Schritt?
Für die Einführung einer KI-Prognose muss man nicht von Anfang an das gesamte Sortiment abdecken. Zunächst bei wenigen wichtigen SKUs die Wirkung zu belegen und den Umfang dann schrittweise zu erweitern, ist der risikoärmste Weg und der, der die meiste Zustimmung im Team findet.
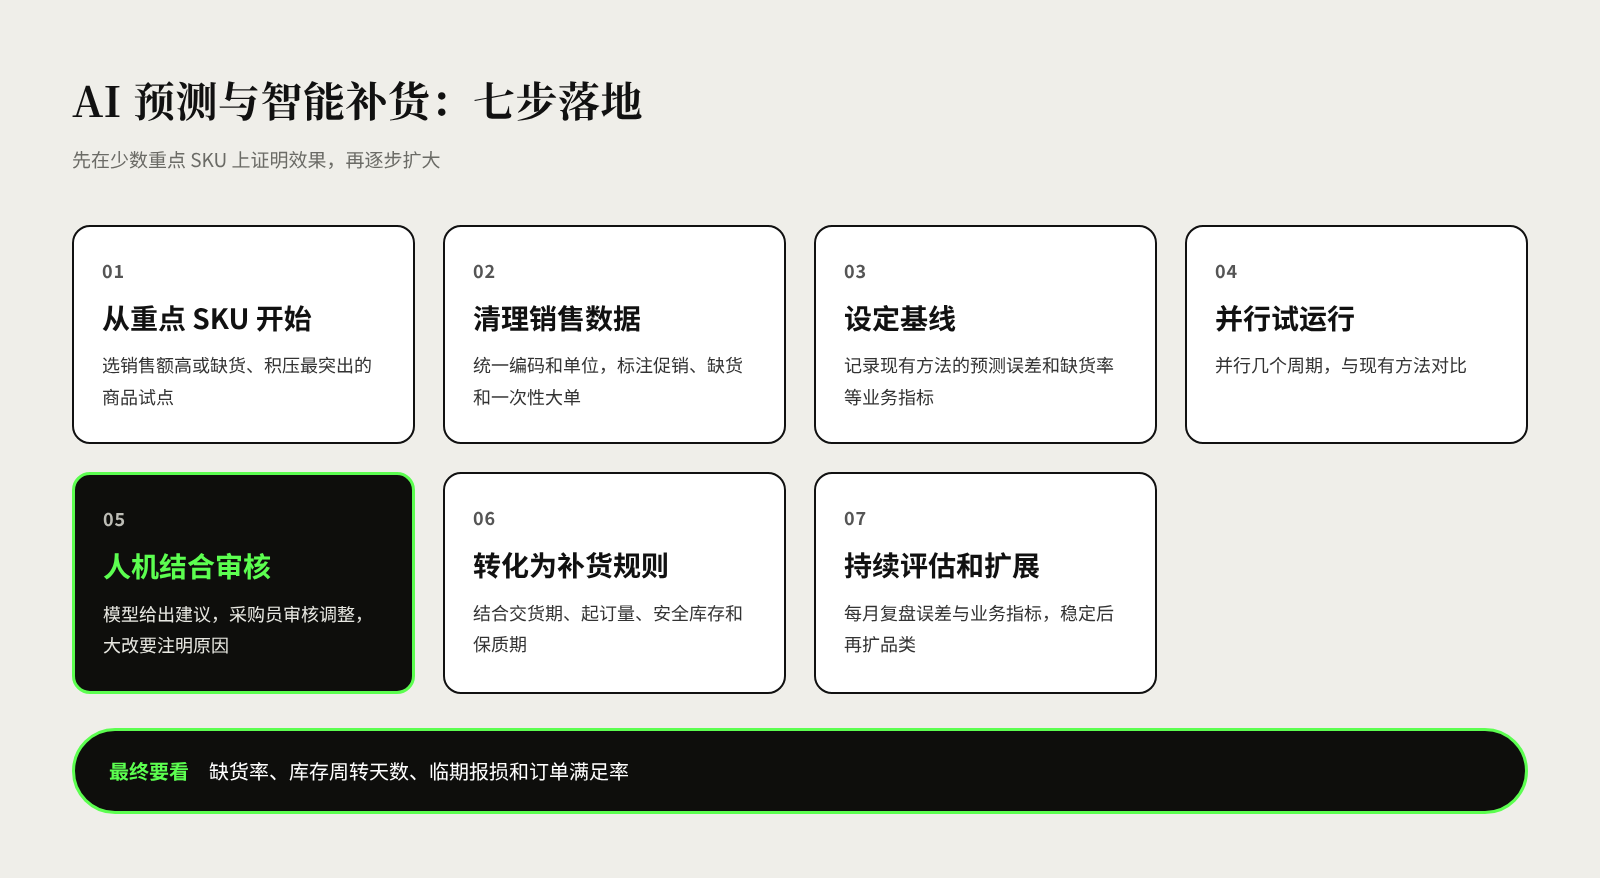
Schritt 1: Mit wenigen wichtigen SKUs beginnen. Wählen Sie einige Dutzend bis ein bis zwei Hundert SKUs aus, die einen hohen Umsatzanteil haben oder bei denen Fehlbestände und Überbestände besonders ausgeprägt sind, als erste Pilotgruppe. Wählen Sie zum Beispiel die umsatzstärksten Artikel und dazu die Warengruppen mit den meisten Abschreibungen der vergangenen sechs Monate.
Schritt 2: Verkaufsdaten bereinigen und aufbereiten. Exportieren Sie mindestens ein bis zwei Jahre Bestellhistorie, vereinheitlichen Sie Artikelnummern und Mengeneinheiten, kennzeichnen Sie Aktionszeiträume, Fehlbestandsphasen und einmalige Großaufträge und entfernen Sie Retouren sowie interne Umlagerungen. Die Datenbereinigung ist in der Regel der aufwendigste und zugleich entscheidendste Schritt.
Schritt 3: Basislinie festlegen. Halten Sie vor dem Einsatz von KI den Prognosefehler der bisherigen Methode (Erfahrung der Einkäufer oder gleitender Durchschnitt) sowie Geschäftskennzahlen wie Fehlbestandsquote, Lagerreichweite in Tagen und Abschreibungen wegen ablaufender Haltbarkeit fest. Ohne Basislinie lässt sich nicht beurteilen, ob die KI tatsächlich eine Verbesserung gebracht hat.
Schritt 4: Kleiner Pilotbetrieb mit Vergleich zur bisherigen Methode. Lassen Sie das Modell und die bisherige Methode über mehrere Bestellzyklen parallel laufen und vergleichen Sie beide mit denselben Kennzahlen. In dieser Phase muss noch nicht nach dem Modellergebnis bestellt werden; entscheidend ist zu beobachten, bei welchen Artikeln es gut und bei welchen schlecht abschneidet.
Schritt 5: Mensch-Maschine-Prüfung einrichten. Das Modell schlägt Bestellmengen vor, die Einkäufer prüfen und passen an – besonders bei Neuprodukten, Aktionsartikeln und Artikeln mit bekannten Besonderheiten. Bitten Sie die Einkäufer, bei größeren Änderungen kurz den Grund zu vermerken, zum Beispiel „Großkunde eröffnet im nächsten Monat zwei neue Filialen“. Diese Vermerke verbessern die Entscheidungsqualität in der laufenden Periode und sind zugleich wertvolle Informationen zur Verbesserung des Modells.
Schritt 6: Prognose in Nachschubregeln überführen. Die Prognose beantwortet nur die Frage, „wie viel verkauft wird“; die Nachschubplanung muss auch klären, „wie viel bestellt wird und wann“. Dafür sind klare Nachschubregeln nötig, die Lieferzeiten der Lieferanten, Mindestbestellmengen, Sicherheitsbestände, Lagerkapazität und Haltbarkeit berücksichtigen. Für Artikel mit kurzer Haltbarkeit legen Sie beispielsweise niedrigere Sicherheitsbestände und häufigere Bestellungen in kleineren Mengen fest.
Schritt 7: Laufend bewerten und ausweiten. Besprechen Sie monatlich Prognosefehler, Bias und Geschäftskennzahlen und analysieren Sie die Ursachen bei Artikeln mit großen Fehlern. Sobald die Wirkung bei den Pilot-SKUs stabil ist, weiten Sie sie schrittweise auf weitere Warengruppen und Lager aus und aktualisieren das Modell regelmäßig mit neuen Daten.
Häufige Fragen zu KI-Bedarfsprognose und intelligenter Nachschubplanung
Reicht die Datenmenge bei kleineren Händlern für eine KI-Prognose aus? In den meisten Fällen ja. Liegen Bestelldaten für ein bis zwei Jahre pro SKU vor, kann man mit den wichtigsten Artikeln beginnen. McKinsey ist in dem oben genannten Artikel ebenfalls der Ansicht, dass die Daten der meisten Unternehmen selbst bei begrenzter Menge ausreichen, um von KI-Prognosen zu profitieren; es müssten lediglich Methoden gewählt werden, die für kleine Datenmengen geeignet sind.
Ersetzt die KI-Prognose die Einkäufer? Nein, aber der Schwerpunkt ihrer Arbeit verändert sich. Die tägliche Berechnung und die Nachschubvorschläge übernimmt das System; die Einkäufer konzentrieren sich auf Lieferantenverhandlungen, die Einführung neuer Artikel, den Umgang mit Ausnahmen und die Einschätzung des Bedarfs großer Kunden.
Wie hoch muss die Prognosegenauigkeit sein, damit sie gut ist? Einen einheitlichen Maßstab gibt es nicht; der Schwierigkeitsgrad der Prognose unterscheidet sich je nach Warengruppe und Ebene erheblich. Praktikabler ist der Vergleich mit der eigenen Basislinie: Sinkt der Fehler kontinuierlich, und gehen Fehlbestände und Überbestände gleichermaßen zurück?
Muss zuerst ein neues ERP oder ein Spezialsystem eingeführt werden? Nicht unbedingt. Solange sich vollständige Bestell-, Bestands- und Artikeldaten aus den bestehenden Systemen exportieren lassen, kann der Pilot beginnen. Sind Bestell- und Bestandsdaten jedoch auf mehrere Tabellen verteilt und uneinheitlich definiert, ist es oft dringlicher, zunächst die Datengrundlage zu ordnen, als ein Prognosewerkzeug einzuführen.
Quellen
- AI-driven operations forecasting in data-light environments, McKinsey, Februar 2022
- Succeeding in the AI supply-chain revolution, McKinsey, April 2021
- M5 accuracy competition: Results, findings, and conclusions (Preprint, Volltext), Makridakis, Spiliotis, Assimakopoulos, International Journal of Forecasting, Oktober 2022 (Angaben zur Zeitschrift)
- Forecasting: Principles and Practice (3. Auflage): Evaluating forecast accuracy, Rob J Hyndman, George Athanasopoulos, Monash University, abgerufen im November 2026


