Per un distributore all'ingrosso, il magazzino è la più grande voce di capitale circolante e anche la più difficile da governare. Da un lato gli scaffali si riempiono di merce che non gira e si avvicina alla scadenza; dall'altro i prodotti più richiesti, quelli che i clienti vogliono subito, vanno in rottura di stock. In molte aziende gli ordini dipendono ancora dall'esperienza dei buyer e da un foglio Excel: quando cambia la persona, il ritmo si perde. Il valore della previsione della domanda con IA non sta nel fornire un numero "infallibile", ma nel trasformare l'ordine da una scelta a intuito in una decisione fondata sui dati, verificabile e in continuo miglioramento.
Dove l'IA supera davvero i metodi tradizionali, cosa può fare e cosa no, e come può iniziare un'azienda? In questo articolo vedremo le cause dei problemi di magazzino nella distribuzione all'ingrosso, la differenza tra metodi tradizionali e previsione con machine learning, quali dati può usare la previsione con IA e dove si fermano i suoi limiti, come misurarne l'accuratezza e un metodo di adozione graduale che parte da pochi SKU prioritari.
Perché nella distribuzione all'ingrosso mancano e avanzano le scorte allo stesso tempo?
Che le scorte manchino e avanzino insieme sembra una contraddizione, ma sono due facce dello stesso problema. La causa di fondo è uno scarto sistematico tra le quantità ordinate e la domanda reale: la maggior parte delle aziende non lo vede e non ha un modo per correggerlo in modo continuativo.
I problemi di magazzino nella distribuzione all'ingrosso nascono di solito da questi fattori:
- Troppi articoli e troppi clienti per essere gestiti a mano. I distributori trattano spesso un gran numero di SKU (unità di gestione a magazzino) per molti punti vendita, ristoranti o rivenditori a valle. Il buyer riesce a seguire con attenzione solo alcune decine di articoli principali; per tutti gli altri il riordino segue l'abitudine.
- La domanda è amplificata dalla variabilità degli ordini. I clienti a valle ordinano spesso a lotti e fanno scorta tutta insieme: prima delle festività e durante le promozioni i volumi salgono di colpo. Se questo picco di breve periodo viene scambiato per la normalità, al giro successivo si ordina troppo; se invece si ignora la stagionalità, in alta stagione la merce finisce.
- Forte pressione di scadenze e cali. Alimentari, bevande e prodotti per la casa hanno una data di scadenza: ordinare troppo non immobilizza soltanto capitale, ma può portare a svendite a ridosso della scadenza o allo smaltimento diretto.
- Registrazione incompleta delle rotture di stock. Quando un cliente chiede un prodotto che non c'è, l'ordine viene spesso annullato o sostituito con un altro articolo; nel sistema resta traccia di "quanto è stato venduto", non di "quanto si voleva comprare". Ordinare su questi dati porta a sottostimare in modo costante la domanda dei prodotti più richiesti.
- Dipendenza dall'esperienza individuale. L'esperienza è preziosa in contesti stabili, ma è difficile da replicare e rende complicato rispondere a "quanto ordiniamo questa volta, e perché".
Un esempio: un distributore di surgelati che rifornisce ristoranti, prima del Capodanno cinese ha preparato le scorte sui volumi dell'anno precedente. Quest'anno però alcuni grandi clienti hanno anticipato gli acquisti e la merce è finita due settimane prima della festa; dopo la festa, avendo riordinato sulla base del picco precedente, alcuni articoli sono rimasti a magazzino fino a ridosso della scadenza. Il problema non è l'impegno del buyer: tenere a mente contemporaneamente stagionalità, clienti, promozioni e tempi di consegna è semplicemente oltre le possibilità di una persona.
In cosa la previsione con IA si differenzia dai metodi tradizionali?
I metodi di ordine tradizionali si basano per lo più sul giudizio esperienziale oppure sulla media mobile (la media delle vendite delle ultime settimane o degli ultimi mesi) per stimare la domanda del periodo successivo. La previsione con machine learning è diversa perché considera contemporaneamente numerosi fattori d'influenza, produce una previsione separata per ogni SKU e per ogni gruppo di clienti, e si aggiorna con l'arrivo di nuovi dati.
La tabella seguente mette a confronto le principali differenze tra i due approcci:
| Aspetto | Giudizio esperienziale / media mobile | Previsione con machine learning |
|---|---|---|
| Base di calcolo | Vendite medie di un periodo passato e giudizio personale | Storico delle vendite più numerosi fattori d'influenza |
| Fattori considerati | Di solito solo le vendite stesse | Promozioni, prezzi, stagionalità, festività, meteo, ordini dei clienti e altro |
| Copertura | Gli articoli principali sono seguiti a mano, gli altri per abitudine | Può prevedere singolarmente tutti gli SKU |
| Promozioni e festività | Richiedono correzioni manuali | L'effetto viene appreso dai dati storici |
| Frequenza di aggiornamento | Revisione mensile o trimestrale | Può aggiornarsi ogni settimana o perfino ogni giorno con i nuovi dati |
| Interpretabilità | Facile da capire | Richiede di mostrare in modo esplicito i fattori principali |
| Requisiti sui dati | Bassi | Serve uno storico abbastanza completo e pulito |
| Contesti adatti | Domanda stabile, pochi articoli | Molti articoli, forte influenza di promozioni e stagionalità |
Va chiarito che il machine learning non è sempre migliore dei metodi semplici. Con una domanda stabile e pochi articoli la media mobile può bastare; il vantaggio del machine learning emerge soprattutto con molti articoli e fattori d'influenza complessi.
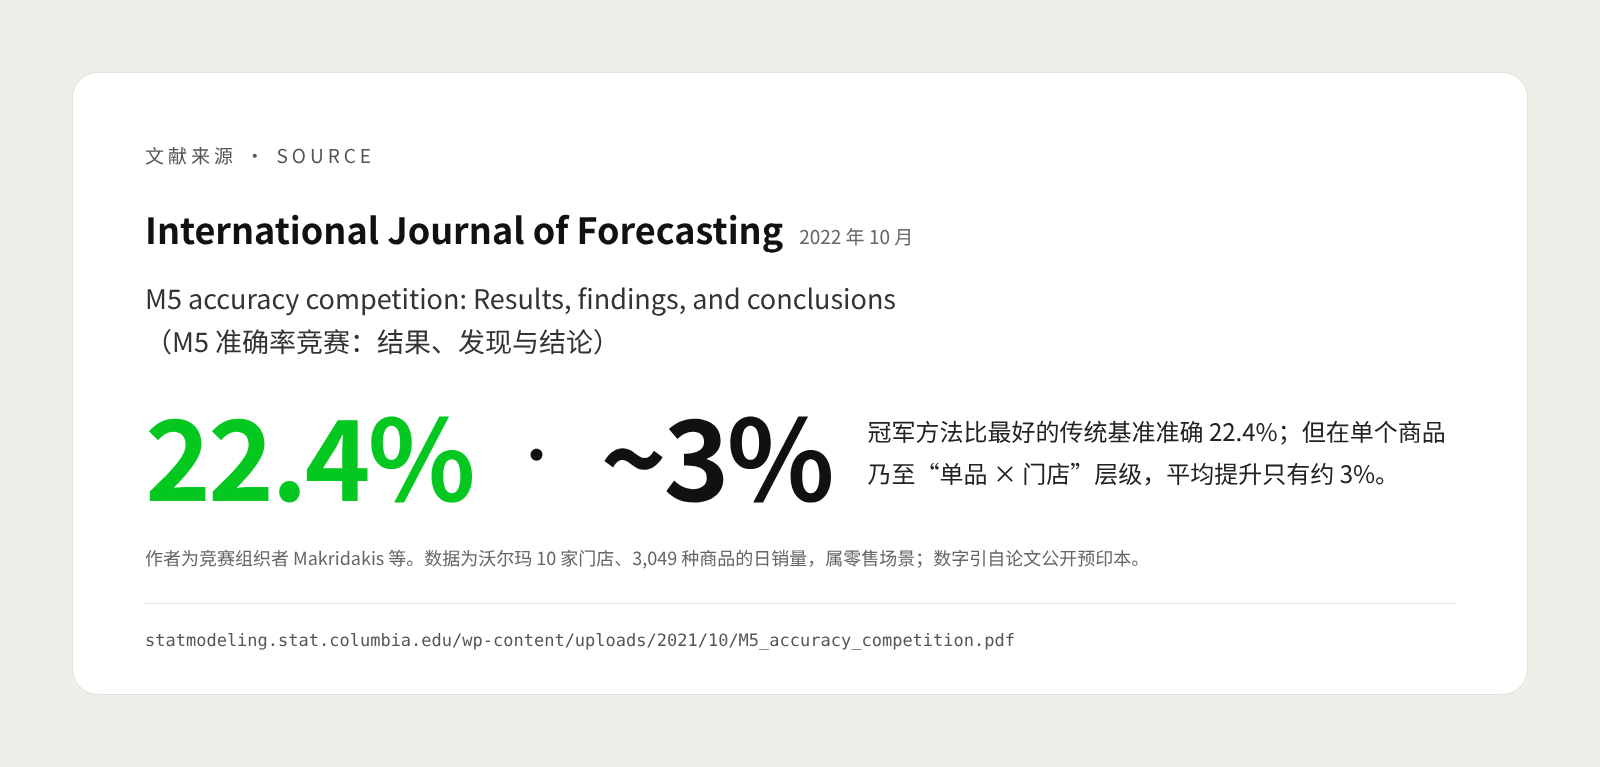
La ricerca accademica offre conferme solide. La celebre competizione di previsione M5 chiedeva ai partecipanti di prevedere le vendite giornaliere di 3.049 prodotti in 10 punti vendita del colosso statunitense Walmart. Secondo l'articolo degli organizzatori, pubblicato sull'International Journal of Forecasting, il metodo vincitore è stato più accurato del 22,4% rispetto al miglior benchmark tradizionale; la maggior parte dei metodi nelle prime posizioni si basava su un algoritmo di machine learning chiamato LightGBM, e tutte le soluzioni premiate usavano informazioni esterne come prezzi, promozioni e date speciali come le festività (fonte). Lo studio osserva però che più il livello si fa dettagliato, minore è il miglioramento: a livello di singolo prodotto, fino alla combinazione "prodotto × punto vendita", il miglioramento medio dei vari metodi rispetto al benchmark è di appena il 3% circa. Questi numeri provengono dal retail e dal preprint pubblico dello studio, e non si possono trasferire direttamente alla distribuzione all'ingrosso, ma indicano due cose: le informazioni esterne sono davvero utili, e più la previsione è granulare, più è difficile.
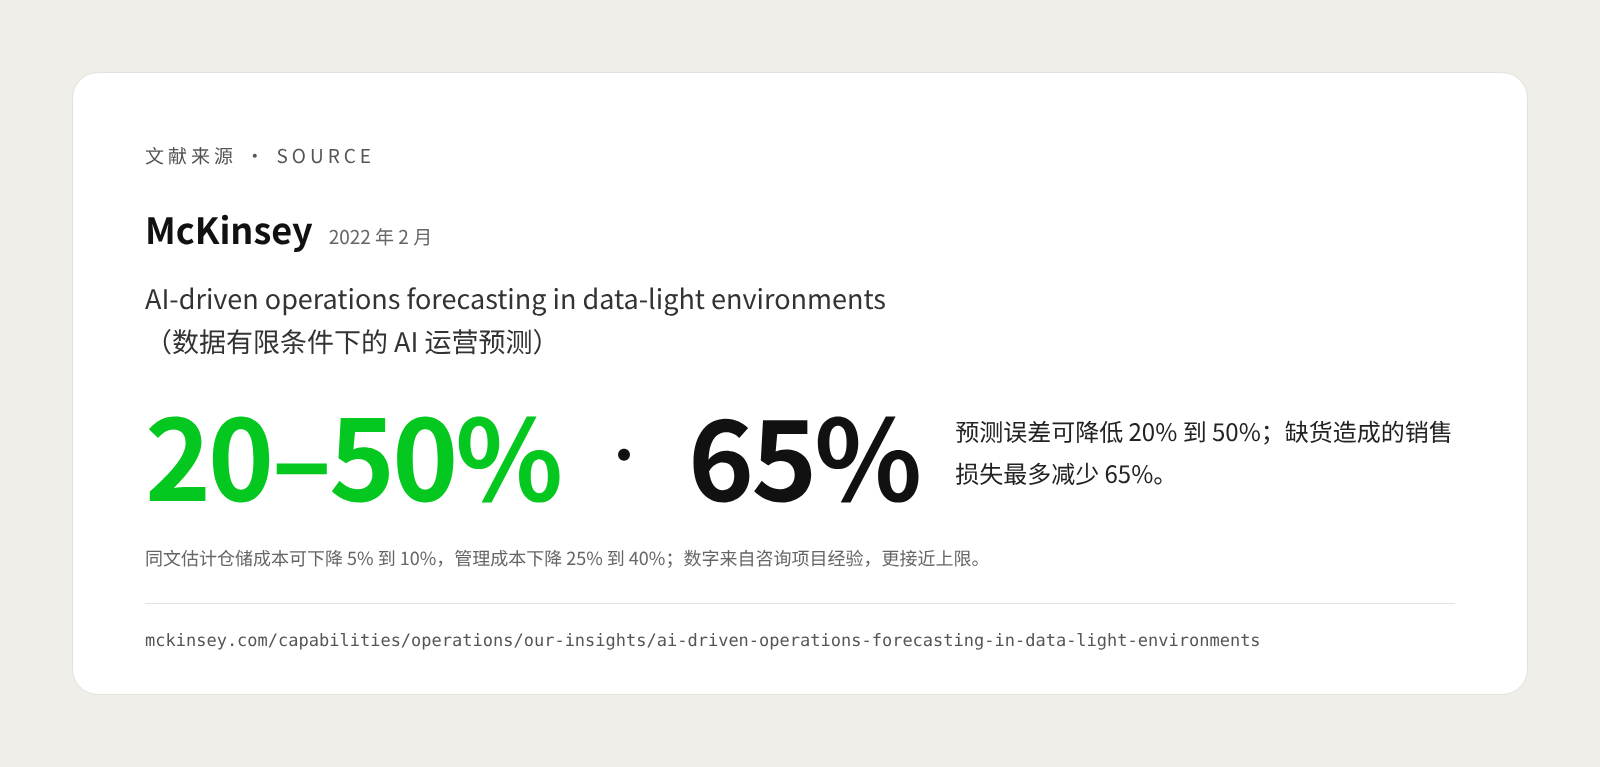
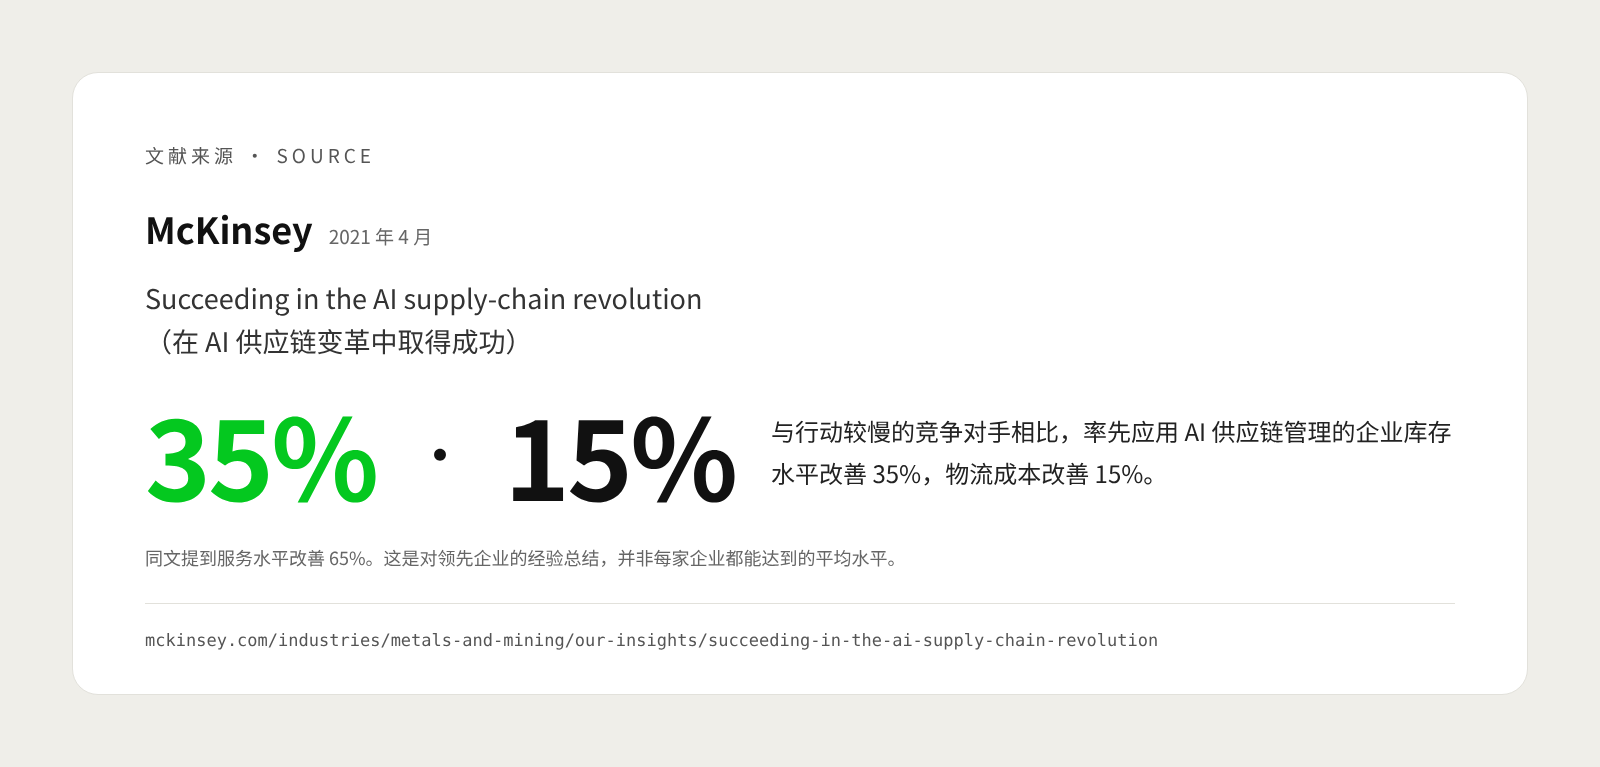
L'esperienza dei progetti di consulenza offre cifre più ottimistiche. Nell'articolo del 2022 «AI-driven operations forecasting in data-light environments», McKinsey stima che applicare la previsione con IA alla gestione della supply chain possa ridurre l'errore di previsione dal 20% al 50%, abbattere fino al 65% le vendite perse per rotture di stock, ridurre del 5-10% i costi di magazzino e del 25-40% i costi amministrativi (fonte). Un altro articolo McKinsey del 2021, «Succeeding in the AI supply-chain revolution», riporta che le aziende che hanno adottato per prime e con successo l'IA nella gestione della supply chain, rispetto ai concorrenti più lenti, hanno migliorato i costi logistici del 15%, i livelli di scorta del 35% e i livelli di servizio del 65% (fonte). Questi dati nascono dalla sintesi di esperienze di progetto: sono più vicini al "massimo ottenibile quando tutto va bene" che alla media raggiungibile da ogni azienda.
Quali dati può usare la previsione con IA, e in quali casi non funziona?
L'efficacia della previsione con IA dipende in larga misura dai dati con cui viene alimentata. Quanto più i dati sono vicini alla domanda reale, tanto più la previsione è utile; per le situazioni senza precedenti storici, anche il modello migliore può offrire solo un'indicazione.
Per un distributore all'ingrosso, i dati più usati sono:
- Storico delle vendite. È il dato fondamentale, idealmente registrato per SKU, cliente e magazzino, su base giornaliera o settimanale. Conviene usare le quantità ordinate dai clienti e non solo quelle effettivamente spedite, perché le spedizioni risentono delle rotture di stock.
- Promozioni e prezzi. Periodi promozionali, entità degli sconti, variazioni di prezzo. Senza questi dati, il modello scambia i picchi generati dalle promozioni per domanda normale.
- Stagionalità e festività. Capodanno cinese, Festa di metà autunno, rientro a scuola, alta stagione turistica e così via. In molte categorie la domanda segue cicli molto marcati.
- Meteo. Ha un'influenza evidente su categorie come bevande, gelati e ingredienti stagionali. Nei suoi articoli McKinsey elenca il meteo tra i dati esterni più usati nelle previsioni.
- Ordini e piani dei clienti. Prenotazioni dei grandi clienti, piani di apertura di nuovi punti vendita e quantità previste dai contratti spiegano spesso la domanda delle settimane successive meglio dello storico.
- Registri di rotture di stock e sostituzioni. Sapere quali ordini sono stati annullati o sostituiti per mancanza di merce aiuta a ricostruire la domanda reale che era stata compressa.
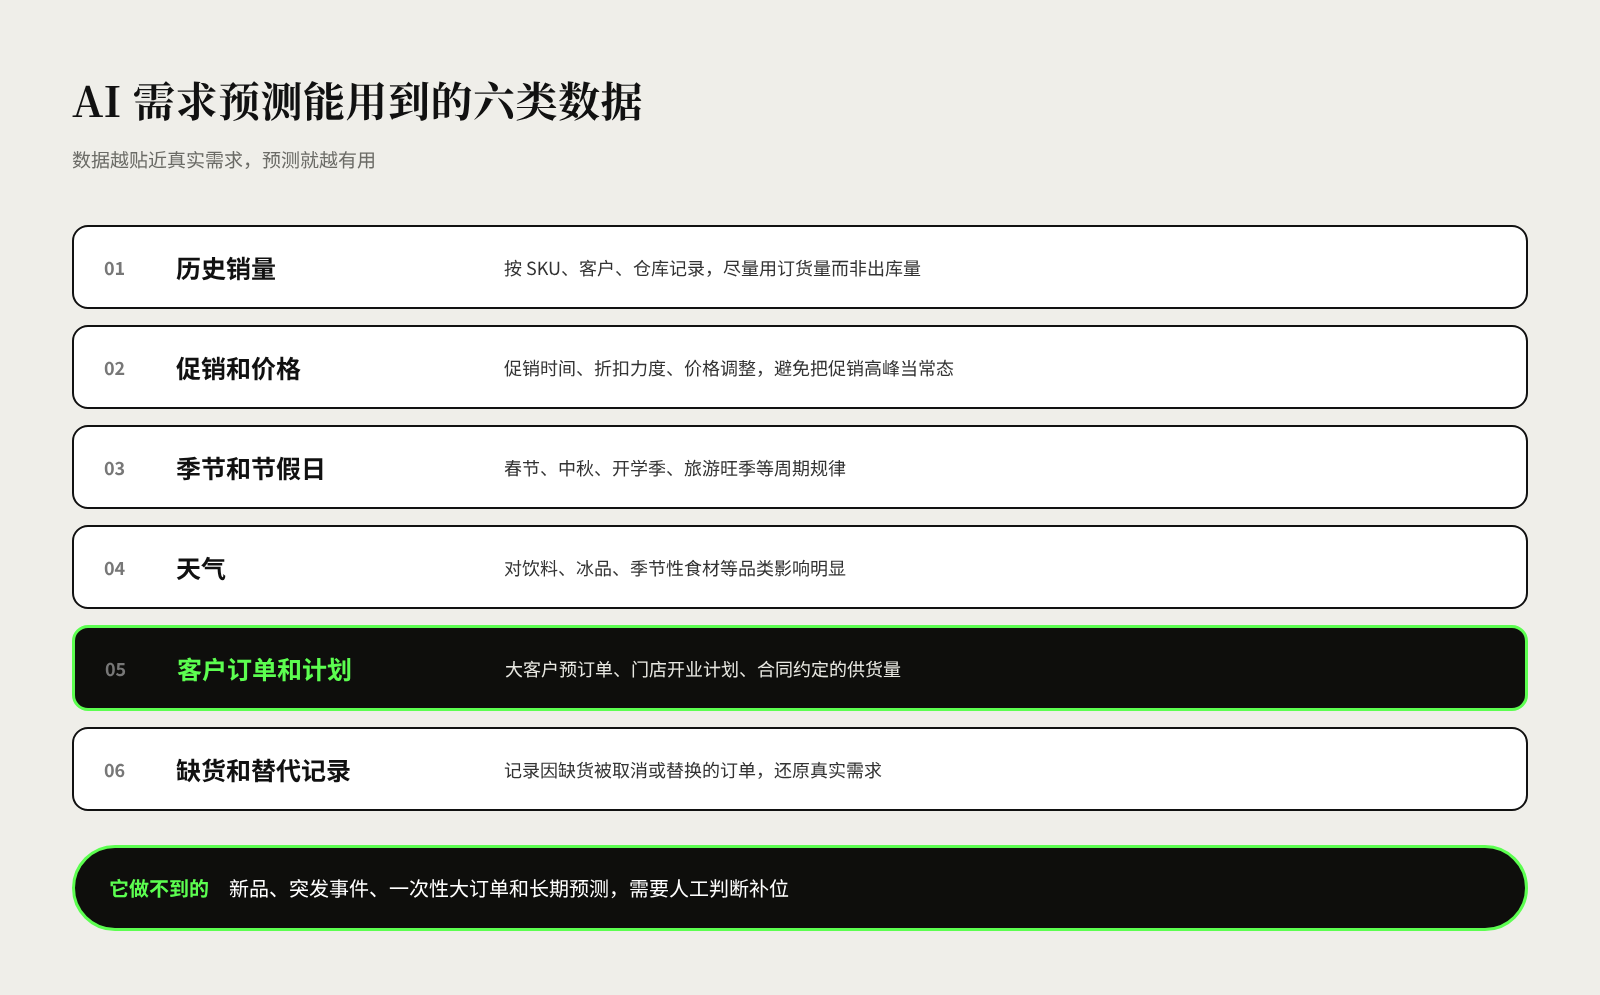
Altrettanto importante è conoscere i limiti della previsione con IA:
- Nuovi prodotti. Per un articolo senza storico di vendita il modello fatica a prevedere direttamente. Di solito si fa riferimento allo storico di prodotti simili oppure, nella fase iniziale del lancio, ci si affida al giudizio umano.
- Eventi imprevisti. Pandemie, condizioni meteo estreme, interruzioni della fornitura, un concorrente che taglia di colpo i prezzi: eventi di questo tipo non si possono imparare dallo storico. McKinsey ricorda inoltre che periodi anomali come quello della pandemia disturbano i modelli e richiedono di attenuare i dati o di trattarli a parte; quando la domanda oscilla in modo violento, i modelli troppo dipendenti dallo storico smettono di funzionare.
- Grandi ordini una tantum. L'acquisto occasionale di un grosso quantitativo da parte di un cliente, se non viene segnalato, porta il modello a sovrastimare la domanda successiva.
- Previsioni di lungo periodo. Più l'orizzonte è lungo, maggiore è l'incertezza. L'IA dà il meglio nelle previsioni su finestra mobile, da alcune settimane ad alcuni mesi.
Per esempio, quando un distributore di prodotti per la casa introduce un nuovo detersivo in capsule, il modello non è in grado di fornire una previsione affidabile; il team acquisti può far riferimento alla curva di lancio di altre novità della stessa marca per definire il primo ordine, e passare il testimone al modello solo dopo aver accumulato alcune settimane di vendite reali.
Come si misura l'accuratezza di una previsione?
Misurare l'accuratezza serve a capire se la previsione sta migliorando e se ci si può fidare, non a inseguire un numero di bell'aspetto. La cosa più importante non è la scelta dell'indicatore, ma confrontare in modo continuativo, con lo stesso indicatore e la stessa metodologia, i risultati con una linea di base.
L'indicatore più comune è il MAPE (errore percentuale assoluto medio). Il concetto è intuitivo: di quanti punti percentuali la previsione si è discostata dal dato reale in ciascun periodo, e poi se ne fa la media. Se per esempio un prodotto ha venduto 100 casse e la previsione era di 80, l'errore del periodo è del 20%. Più il MAPE è basso, più la previsione è accurata.
Il MAPE ha però un limite che per i distributori conta molto. Il manuale di previsione «Forecasting: Principles and Practice», scritto da studiosi della Monash University, osserva che quando le vendite reali sono pari a zero l'errore percentuale non è calcolabile, quando sono vicine a zero l'errore diventa enorme, e inoltre penalizza in modo asimmetrico la sovrastima e la sottostima (fonte). I distributori all'ingrosso hanno moltissimi SKU di coda lunga, e per molti prodotti in certi giorni o settimane le vendite sono semplicemente nulle: calcolare direttamente il MAPE produce facilmente risultati distorti.
Nella pratica si possono quindi combinare diversi approcci:
- Errore assoluto medio (MAE). Calcola direttamente di quanti pezzi o casse la previsione si è discostata in media dal dato reale; l'unità coincide con quella del business ed è facile da capire.
- Errore ponderato sulle vendite. Si sommano gli errori di tutti i prodotti e si divide per le vendite totali: i prodotti più venduti pesano di più, in modo più aderente all'impatto reale sull'attività.
- Confronto con metodi semplici. Il MASE (errore assoluto scalato medio) presentato nel manuale citato confronta l'errore del modello con quello del metodo più semplice, cioè usare come previsione le vendite del periodo precedente; un risultato inferiore a 1 indica che il modello è migliore del metodo semplice.
- Distorsione (bias). Mostra se la previsione è sistematicamente troppo alta o troppo bassa. Una sovrastima costante porta a scorte in eccesso, una sottostima costante a rotture di stock: è un dato più importante della sola entità dell'errore.
Infine, l'accuratezza della previsione è solo un indicatore intermedio. Ciò che conta davvero è se migliorano i risultati di business: tasso di rotture di stock, giorni di rotazione del magazzino, valore dei cali per prodotti in scadenza e tasso di evasione degli ordini.
Come adottare passo dopo passo previsione con IA e riordino intelligente: la guida
Per adottare la previsione con IA non serve coprire subito tutti i prodotti. Dimostrare i risultati su pochi SKU prioritari e poi ampliare gradualmente il perimetro è il percorso a minor rischio e quello che ottiene più facilmente il consenso del team.
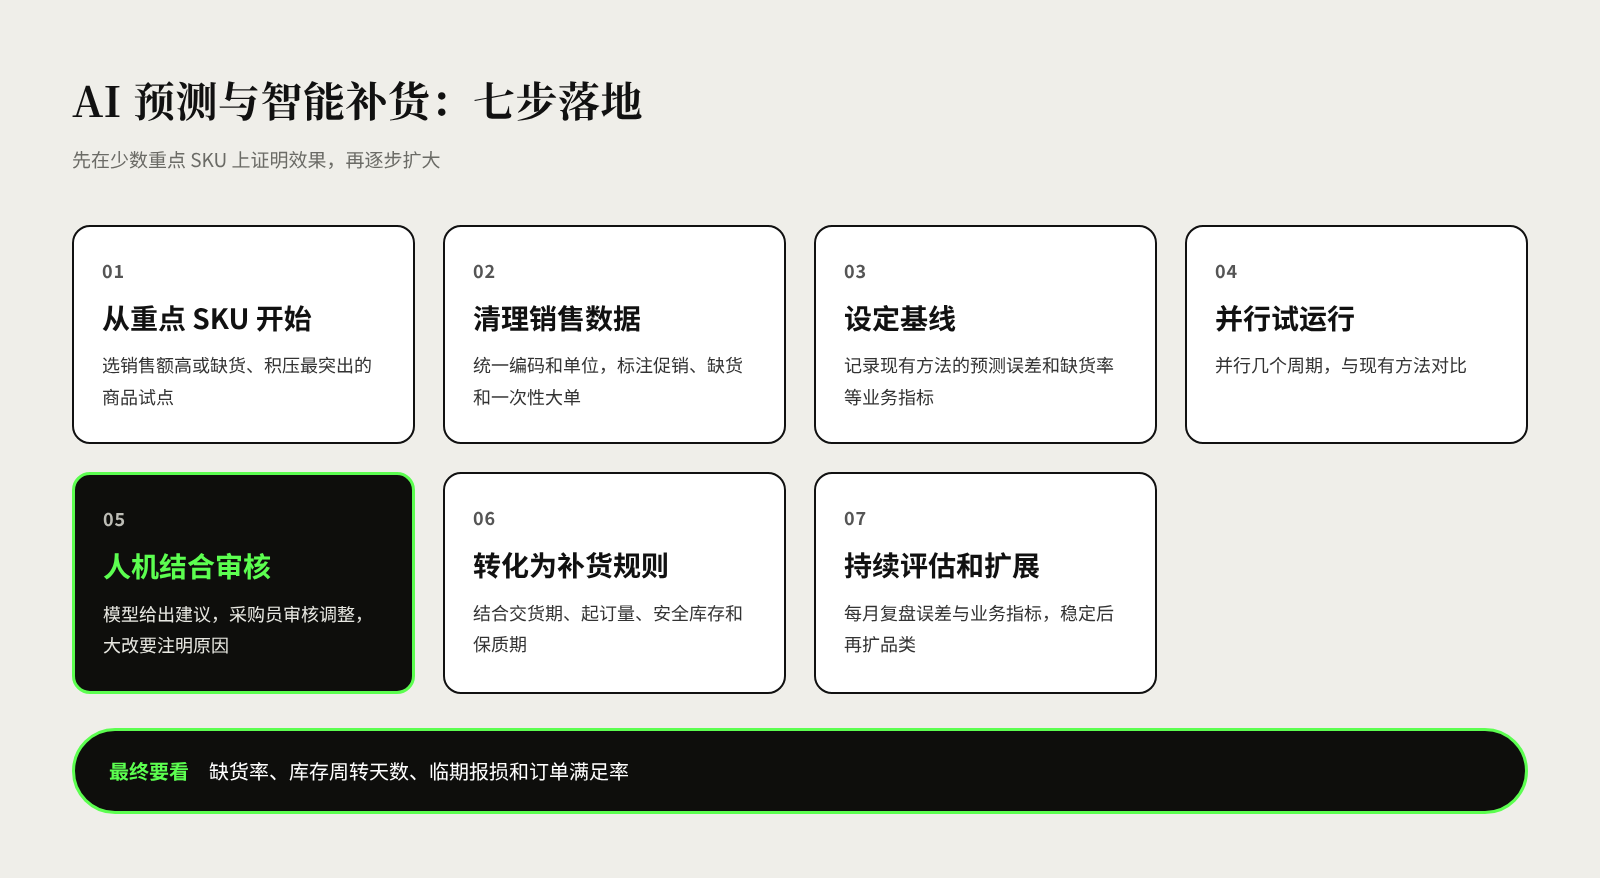
Passo 1: partire da pochi SKU prioritari. Scegli da alcune decine a uno o due centinaia di SKU con un'alta quota di fatturato oppure con i problemi più evidenti di rotture di stock e scorte in eccesso, come primo gruppo pilota. Per esempio, i prodotti ai primi posti per fatturato, più le categorie con più cali negli ultimi sei mesi.
Passo 2: ripulire e organizzare i dati di vendita. Esporta almeno uno o due anni di storico ordini, uniforma i codici prodotto e le unità di misura, segnala i periodi promozionali, i periodi di rottura di stock e i grandi ordini una tantum, ed escludi resi e trasferimenti interni. La pulizia dei dati è di solito il passo che richiede più tempo e che decide più di ogni altro il successo.
Passo 3: definire la linea di base. Prima di introdurre l'IA, registra l'errore di previsione del metodo attuale (esperienza del buyer o media mobile), insieme a indicatori di business come tasso di rotture di stock, giorni di rotazione del magazzino e cali per prodotti in scadenza. Senza una linea di base non si può sapere se l'IA abbia portato un miglioramento.
Passo 4: avviare una prova su scala ridotta, confrontandola con il metodo attuale. Fai funzionare il modello in parallelo al metodo esistente per alcuni cicli di ordine e confronta i risultati con gli stessi indicatori. In questa fase non è necessario ordinare subito secondo il modello: l'obiettivo è osservare su quali prodotti funziona bene e su quali male.
Passo 5: stabilire una revisione che combini uomo e macchina. Il modello propone le quantità da ordinare; il buyer le verifica e le corregge, soprattutto per novità, prodotti in promozione e articoli con situazioni particolari note. Chiedi al buyer di annotare brevemente il motivo delle modifiche rilevanti, per esempio "il grande cliente apre due nuovi punti vendita il mese prossimo". Queste note migliorano la qualità della decisione del momento e sono un'informazione preziosa per perfezionare il modello.
Passo 6: trasformare le previsioni in regole di riordino. La previsione risponde solo a "quanto si venderà"; il riordino deve rispondere anche a "quanto ordinare e quando". Occorre definire regole chiare che tengano conto dei tempi di consegna dei fornitori, dei lotti minimi d'ordine, delle scorte di sicurezza, della capacità di stoccaggio e della durata di conservazione. Per esempio, per i prodotti a breve conservazione si impostano scorte di sicurezza più basse e ordini più frequenti di piccoli lotti.
Passo 7: valutare ed estendere in modo continuo. Ogni mese rivedi errore di previsione, distorsione e indicatori di business, e analizza le cause dei prodotti con errori maggiori. Quando i risultati sugli SKU pilota si stabilizzano, estendi gradualmente a più categorie e magazzini, aggiornando periodicamente il modello con i nuovi dati.
Domande frequenti su previsione della domanda con IA e riordino intelligente
I dati di un distributore di piccole e medie dimensioni bastano per la previsione con IA? Nella maggior parte dei casi sì. Basta avere uno o due anni di ordini registrati per SKU per iniziare dai prodotti principali. Nei suoi articoli McKinsey ritiene inoltre che, anche con dati limitati, i dati della maggior parte delle aziende siano sufficienti per trarre vantaggio dalla previsione con IA, purché si scelgano metodi adatti a piccole quantità di dati.
La previsione con IA sostituirà i buyer? No, ma il focus del loro lavoro cambierà. I calcoli quotidiani e i suggerimenti di riordino passano al sistema, mentre il buyer concentra le energie su trattative con i fornitori, introduzione di nuovi prodotti, gestione delle eccezioni e valutazione della domanda dei grandi clienti.
Quale livello di accuratezza si può considerare buono? Non esiste uno standard unico: la difficoltà di previsione varia molto tra categorie e livelli di dettaglio. L'approccio più pratico è confrontarsi con la propria linea di base e verificare se l'errore scende in modo costante e se rotture di stock e scorte in eccesso diminuiscono insieme.
Serve prima un nuovo ERP o un sistema dedicato? Non necessariamente. Basta poter esportare dai sistemi esistenti dati completi su ordini, scorte e prodotti per avviare un progetto pilota. Se però ordini e scorte sono sparsi in più fogli con criteri incoerenti, mettere in ordine le basi dati è spesso più urgente che introdurre uno strumento di previsione.
Riferimenti
- AI-driven operations forecasting in data-light environments, McKinsey, febbraio 2022
- Succeeding in the AI supply-chain revolution, McKinsey, aprile 2021
- M5 accuracy competition: Results, findings, and conclusions (preprint completo), Makridakis, Spiliotis, Assimakopoulos, International Journal of Forecasting, ottobre 2022 (scheda della rivista)
- Forecasting: Principles and Practice (3ª edizione): valutazione dell'accuratezza delle previsioni, Rob J Hyndman, George Athanasopoulos, Monash University, consultato a novembre 2026


