Pour un distributeur en gros, le stock est la première immobilisation de trésorerie, et le poste le plus difficile à piloter. Dans l'entrepôt, des produits qui ne se vendent pas s'approchent de leur date limite, tandis que les best-sellers réclamés d'urgence par les clients sont en rupture. Chez beaucoup d'entreprises, les commandes fournisseurs reposent encore sur l'expérience de l'acheteur et sur un tableau Excel ; dès que la personne change, le rythme se dérègle. L'intérêt de la prévision de la demande par IA n'est pas de fournir un chiffre « infaillible », mais de transformer la commande, d'une affaire d'intuition, en une décision fondée sur des éléments, vérifiable et en amélioration continue.
En quoi l'IA fait-elle réellement mieux que les méthodes traditionnelles, que peut-elle faire, que ne peut-elle pas faire, et par où une entreprise doit-elle commencer ? Dans cet article, nous présentons l'origine des problèmes de stock chez les distributeurs en gros, la différence entre les méthodes traditionnelles et la prévision par machine learning, les données que l'IA peut exploiter et ses limites, la manière de mesurer la justesse d'une prévision, et une méthode de déploiement pas à pas, à partir de quelques SKU stratégiques.
Pourquoi les distributeurs en gros ont-ils toujours « trop peu et trop à la fois » ?
La coexistence de ruptures et de surstocks semble contradictoire ; en réalité, ce sont les deux faces d'un même problème. La cause profonde est un écart systématique entre les quantités commandées et la demande réelle, que la plupart des entreprises ne voient pas et ne savent pas corriger durablement.
Les difficultés de stock des distributeurs en gros viennent généralement des facteurs suivants :
- Trop de références et trop de clients pour une gestion humaine. Les distributeurs gèrent souvent un grand nombre de SKU (unités de gestion de stock) pour de nombreux points de vente, restaurants ou revendeurs aval. L'acheteur ne peut suivre de près que quelques dizaines de produits phares ; le reste est réapprovisionné par habitude.
- Une demande amplifiée par la volatilité des commandes. Les clients aval commandent par lots et constituent leurs stocks en une fois ; les volumes bondissent avant les fêtes et pendant les promotions. Si l'on prend ce pic ponctuel pour la norme, on surcommande au cycle suivant ; à l'inverse, si l'on ignore la saisonnalité, on tombe en rupture en haute saison.
- Une forte pression des dates limites et de la démarque. Les produits alimentaires, les boissons ou les produits d'entretien ont une durée de conservation limitée : surcommander n'immobilise pas seulement de la trésorerie, cela peut aussi entraîner des soldes en fin de vie, voire la mise au rebut.
- Des ruptures mal enregistrées. Lorsqu'un client demande un produit qui n'est pas en stock, la commande est souvent annulée ou remplacée par un autre article ; le système ne conserve que « ce qui a été vendu », pas « ce que le client voulait acheter ». Commander sur de telles données conduit à sous-estimer durablement la demande des produits phares.
- Une dépendance à l'expérience individuelle. L'expérience est précieuse dans un environnement stable, mais elle est difficile à transmettre et ne permet guère de répondre à la question « combien commander cette fois, et pourquoi ? ».
Prenons l'exemple d'un distributeur de produits surgelés qui approvisionne des restaurants : avant le Nouvel An chinois, il a constitué son stock sur la base des volumes de l'an dernier ; or, cette année, plusieurs grands clients ont anticipé leurs achats et il s'est trouvé en rupture deux semaines avant la fête. Après la fête, il a réapprovisionné en se fondant sur le pic d'avant-fête, et certaines références se sont retrouvées en surstock, proches de leur date limite. Le problème ne tient pas au manque d'efforts de l'acheteur : tenir compte à la fois de la saisonnalité, des clients, des promotions et des délais de livraison dépasse tout simplement les capacités d'un cerveau humain.
En quoi la prévision par IA diffère-t-elle des méthodes traditionnelles ?
Les méthodes de commande traditionnelles reposent pour la plupart sur le jugement de l'acheteur, ou sur une moyenne mobile (la moyenne des ventes des dernières semaines ou des derniers mois) pour estimer la demande de la période suivante. Ce qui distingue la prévision par machine learning, c'est qu'elle peut prendre en compte simultanément un grand nombre de facteurs, produire une prévision pour chaque SKU et chaque groupe de clients, et se mettre à jour au fil des nouvelles données.
Le tableau ci-dessous compare les principales différences entre les deux approches :
| Critère | Jugement d'expert / moyenne mobile | Prévision par machine learning |
|---|---|---|
| Fondement | Ventes moyennes de la période passée et jugement personnel | Historique des ventes et multiples facteurs d'influence |
| Facteurs pris en compte | Généralement les seules ventes | Promotions, prix, saisonnalité, jours fériés, météo, commandes clients, etc. |
| Couverture | Suivi humain des produits phares, habitude pour le reste | Prévision possible pour chaque SKU, un par un |
| Promotions et jours fériés | Ajustement manuel | Impact appris à partir des données historiques |
| Fréquence de mise à jour | Ajustement mensuel ou trimestriel | Mise à jour possible chaque semaine, voire chaque jour, avec les nouvelles données |
| Explicabilité | Facile à comprendre | Nécessite d'afficher spécifiquement les principaux facteurs d'influence |
| Exigences en matière de données | Faibles | Historique relativement complet et propre |
| Cas d'usage adaptés | Demande stable, peu de références | Nombreuses références, forte influence des promotions et de la saisonnalité |
Il faut souligner que le machine learning n'est pas toujours supérieur aux méthodes simples. Lorsque la demande est stable et les références peu nombreuses, la moyenne mobile peut suffire ; l'avantage du machine learning se manifeste surtout dans les contextes à nombreuses références et à facteurs d'influence complexes.
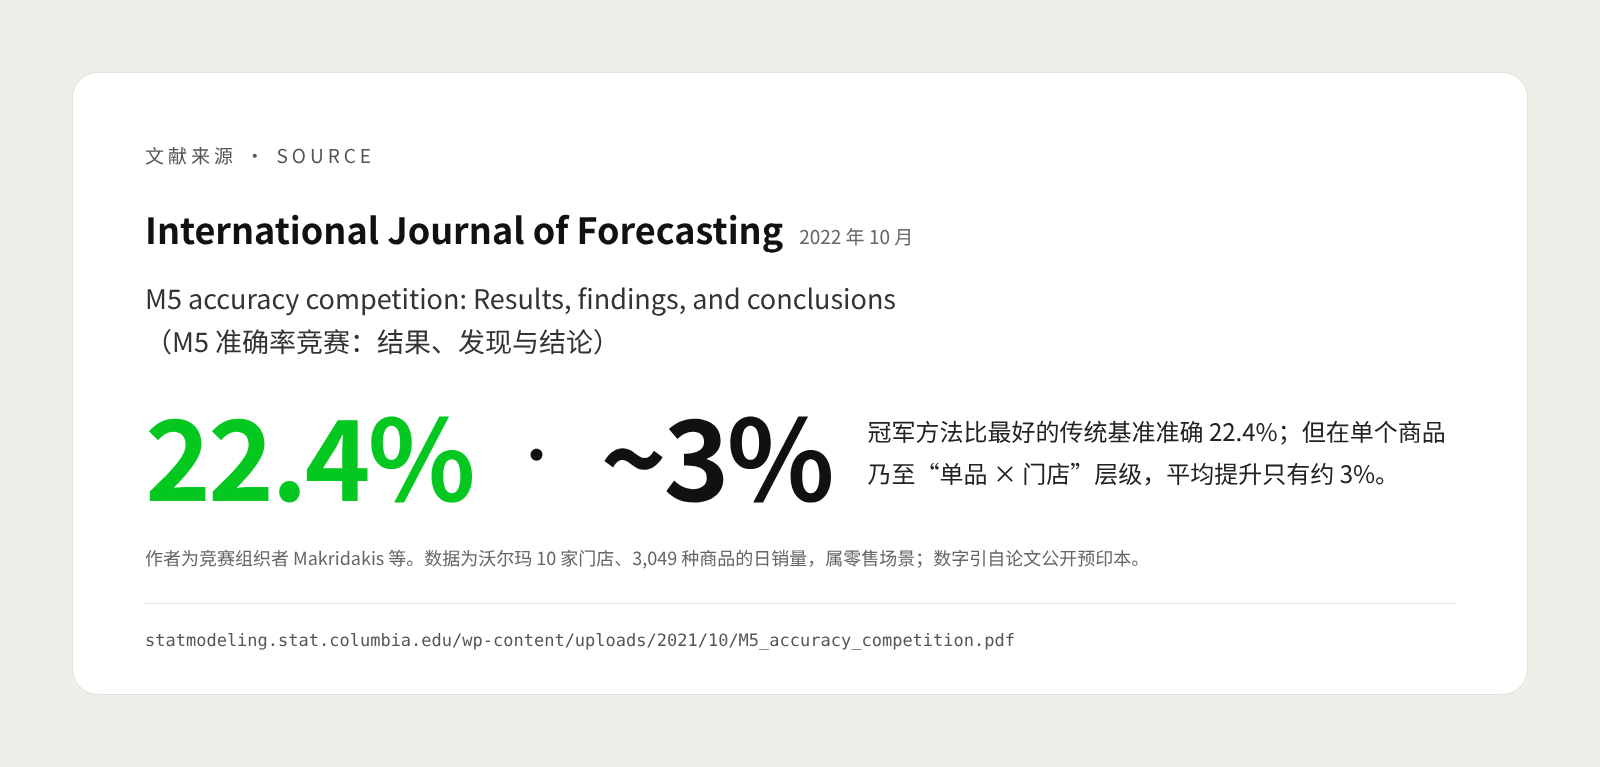
Le monde académique en a apporté une validation solide. La célèbre compétition de prévision M5 demandait aux participants de prévoir les ventes quotidiennes de 3 049 produits dans 10 magasins du détaillant américain Walmart. Selon l'article des organisateurs publié dans l'International Journal of Forecasting, la méthode gagnante a été 22,4 % plus précise que la meilleure méthode de référence traditionnelle ; la plupart des méthodes les mieux classées reposaient sur un algorithme de machine learning appelé LightGBM, et toutes les solutions primées utilisaient des informations externes comme les prix, les promotions et les dates spéciales telles que les jours fériés (source). Mais l'article précise aussi que plus on descend dans le détail, plus le gain s'amenuise : au niveau d'un produit isolé, voire d'un « produit × magasin », l'amélioration moyenne des méthodes par rapport à la référence n'est que d'environ 3 %. Ces chiffres proviennent du commerce de détail et du prépublication de l'article ; ils ne sont pas directement transposables aux distributeurs en gros, mais ils montrent deux choses : les informations externes sont réellement utiles, et plus une prévision est fine, plus elle est difficile.
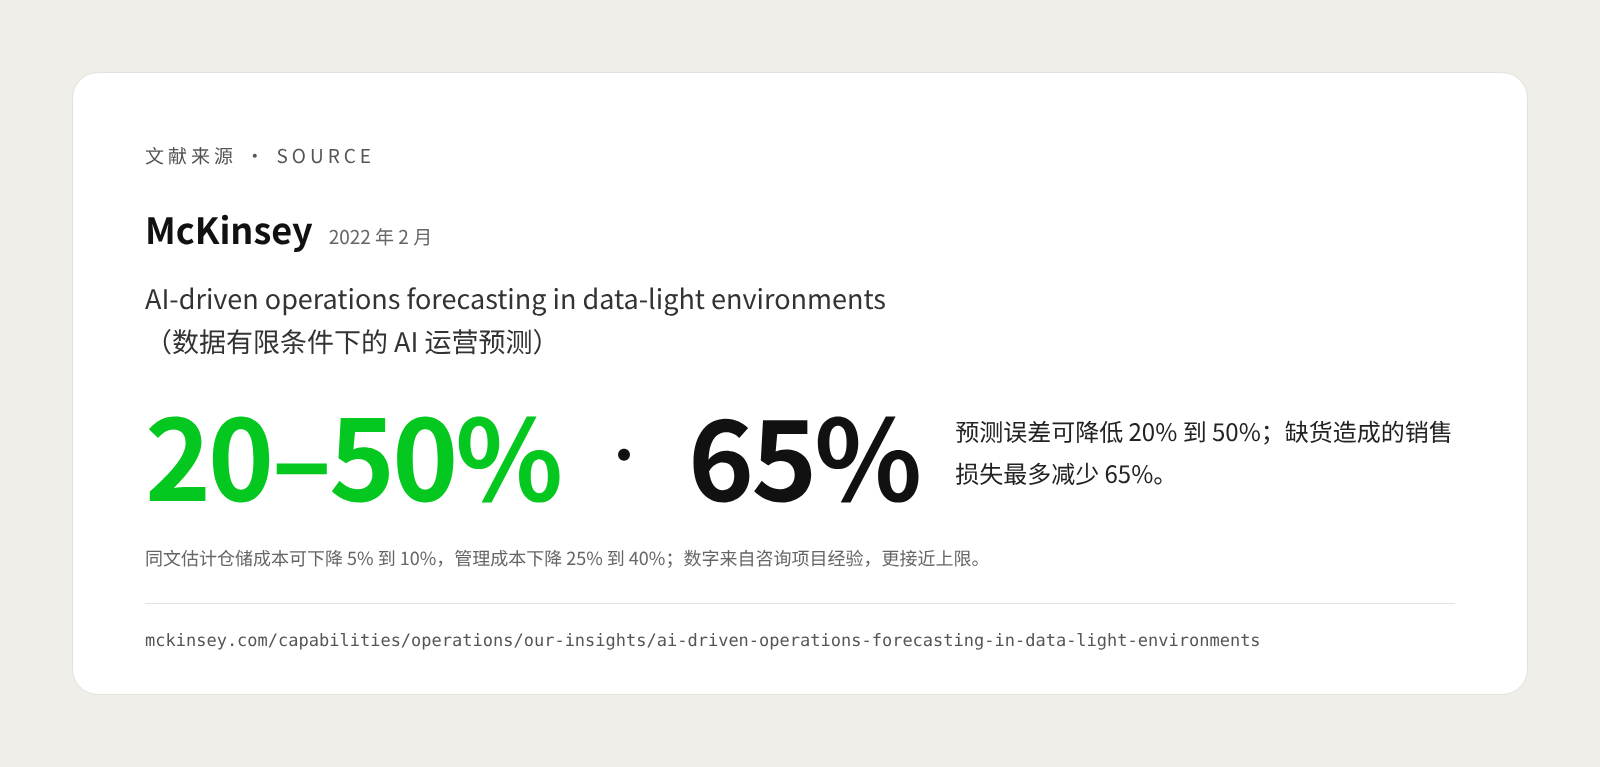
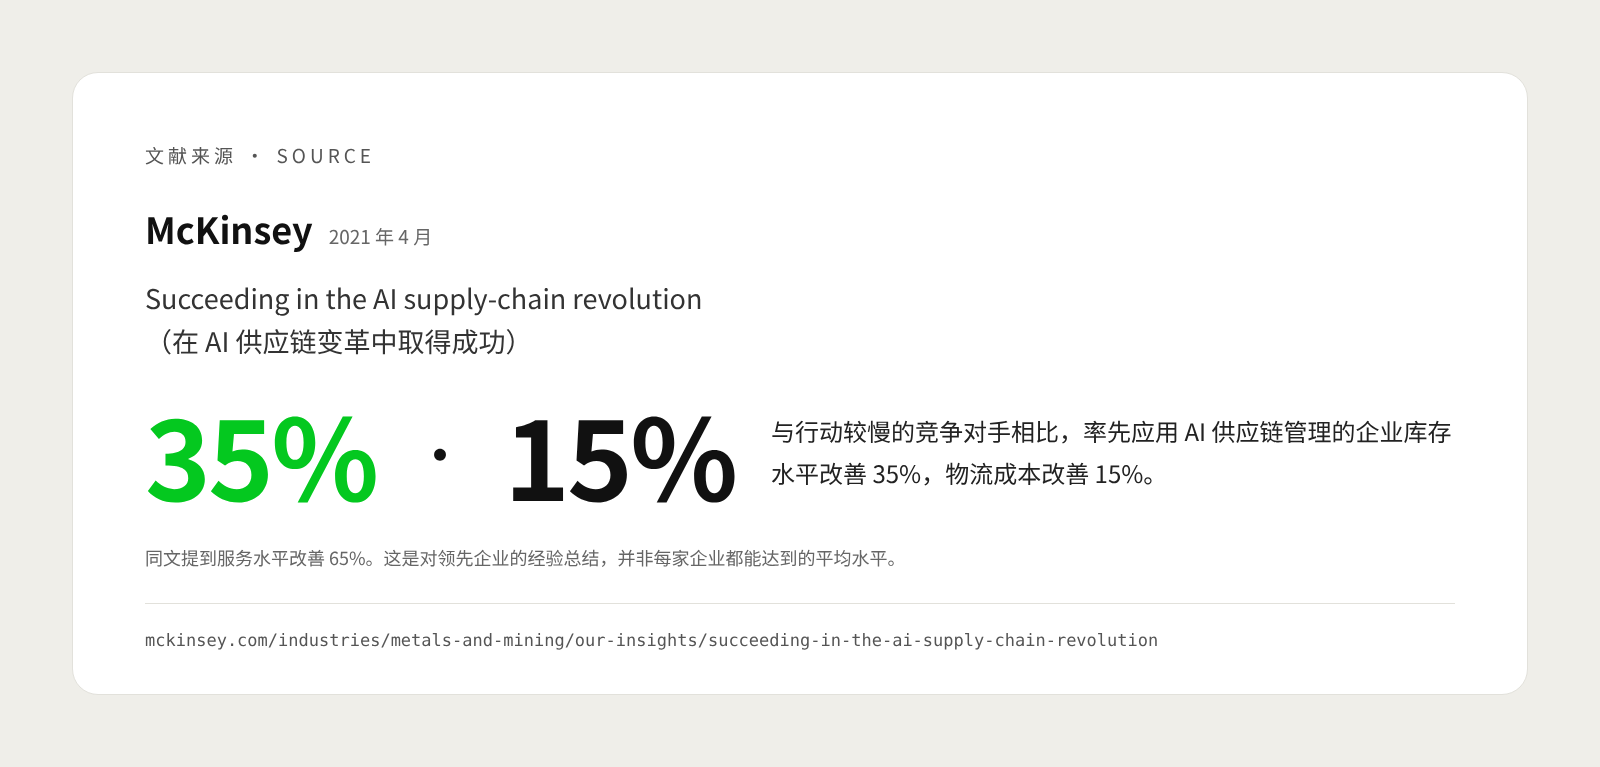
L'expérience des projets de conseil donne des chiffres plus optimistes. Dans son article de 2022 « AI-driven operations forecasting in data-light environments », McKinsey estime que l'application de la prévision par IA à la gestion de la chaîne d'approvisionnement peut réduire les erreurs de prévision de 20 à 50 %, diminuer jusqu'à 65 % les pertes de ventes dues aux ruptures, réduire de 5 à 10 % les coûts d'entreposage et de 25 à 40 % les coûts d'administration (source). Un autre article de McKinsey, « Succeeding in the AI supply-chain revolution » (2021), indique que, par rapport aux concurrents plus lents, les entreprises qui ont été les premières à appliquer avec succès l'IA à leur chaîne d'approvisionnement ont amélioré de 15 % leurs coûts logistiques, de 35 % leurs niveaux de stock et de 65 % leurs niveaux de service (source). Ces chiffres sont issus de retours d'expérience de missions de conseil ; ils se rapprochent davantage d'un plafond atteignable dans de bonnes conditions que de la moyenne que toute entreprise peut espérer.
Quelles données la prévision par IA peut-elle exploiter, et dans quels cas échoue-t-elle ?
L'efficacité de la prévision par IA dépend en grande partie des données qu'on lui fournit. Plus les données reflètent la demande réelle, plus la prévision est utile ; et quand il n'existe aucun historique, même le meilleur modèle ne peut fournir qu'une indication.
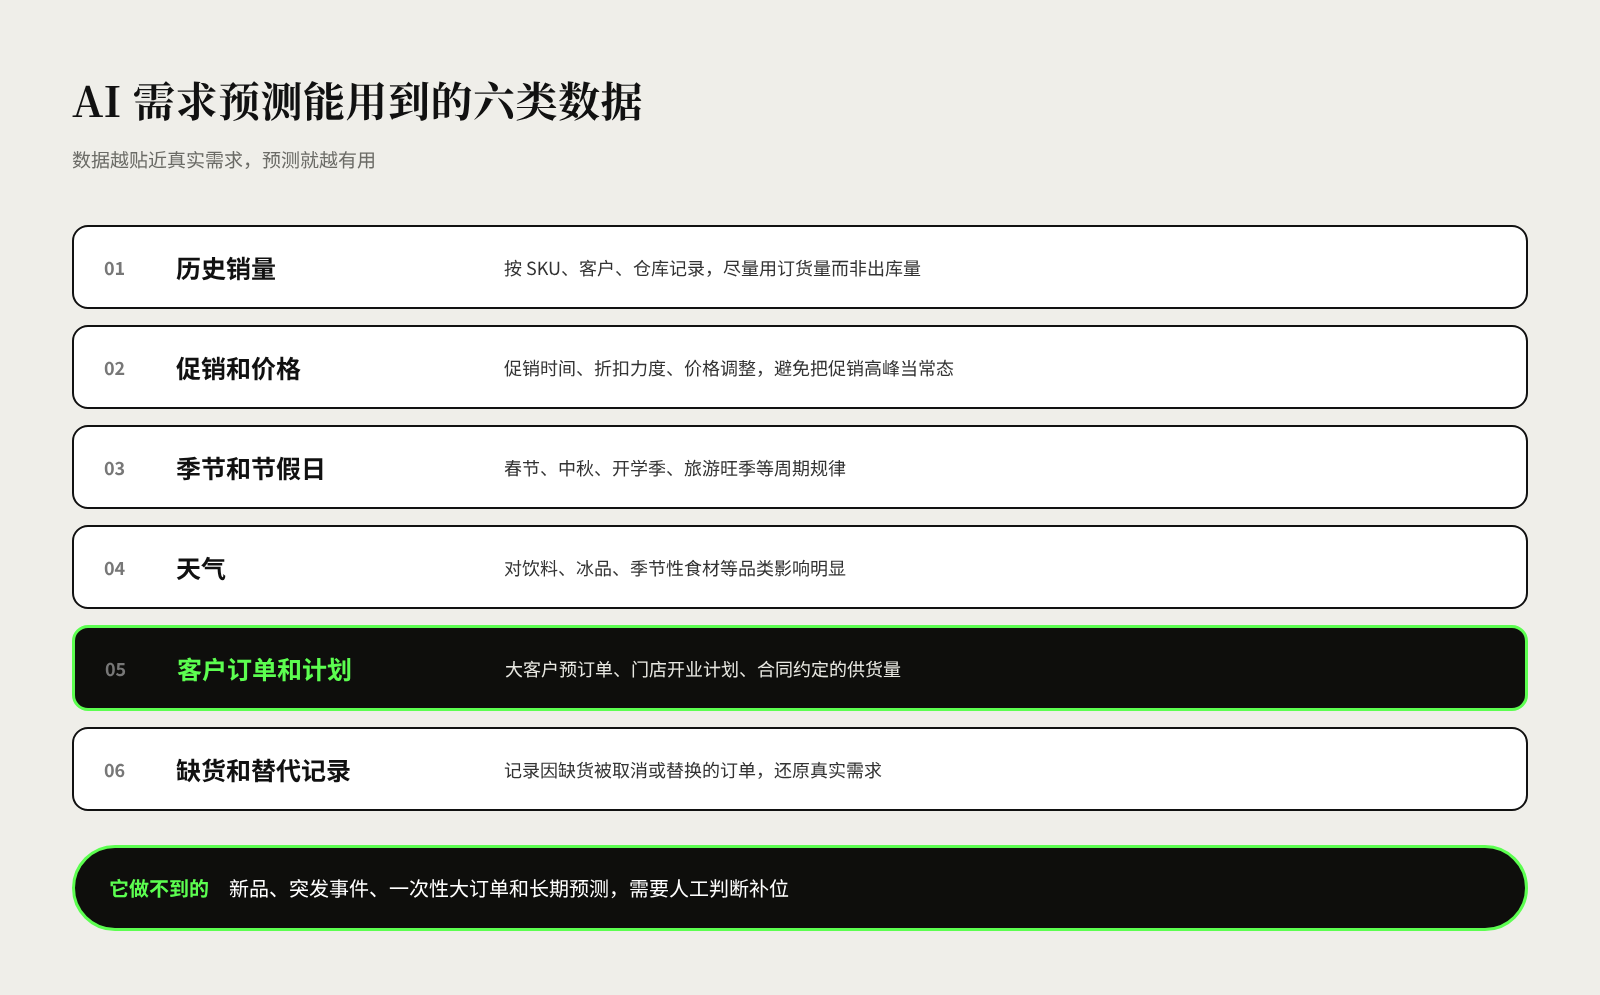
Pour un distributeur en gros, les données couramment utilisées sont les suivantes :
- Historique des ventes. La donnée centrale, idéalement enregistrée par SKU, client et entrepôt, au jour ou à la semaine. Il faut utiliser autant que possible les quantités commandées par les clients, et pas seulement les quantités réellement expédiées, car les expéditions sont affectées par les ruptures.
- Promotions et prix. Dates des promotions, niveau de remise, changements de prix. Sans ces informations, le modèle prend le pic lié à une promotion pour de la demande normale.
- Saisonnalité et jours fériés. Nouvel An chinois, fête de la Mi-Automne, rentrée scolaire, haute saison touristique, etc. La demande de nombreuses catégories suit un cycle marqué.
- Météo. Son influence est notable sur les boissons, les glaces ou les produits frais saisonniers. Dans l'article cité plus haut, McKinsey range aussi la météo parmi les données externes couramment utilisées en prévision.
- Commandes et plans des clients. Les précommandes des grands clients, les ouvertures de magasins prévues, les volumes de livraison fixés par contrat renseignent souvent mieux sur la demande des prochaines semaines que les données historiques.
- Ruptures et substitutions. Enregistrer les commandes annulées ou remplacées faute de stock aide à reconstituer la demande réelle, qui a été comprimée.
Il est tout aussi important de connaître les limites de la prévision par IA :
- Les nouveaux produits. Pour un produit sans historique de ventes, le modèle peine à prévoir directement. On s'appuie généralement sur l'historique de produits similaires, ou sur le jugement humain au lancement.
- Les événements imprévus. Pandémie, conditions météorologiques extrêmes, rupture d'approvisionnement, baisse de prix soudaine d'un concurrent : ces événements ne s'apprennent pas à partir de données historiques. McKinsey rappelle aussi que les périodes anormales, comme celle de la pandémie, perturbent les modèles et exigent un lissage ou un traitement distinct des données ; quand la demande fluctue fortement, un modèle qui s'appuie trop sur l'historique devient inefficace.
- Les grosses commandes ponctuelles. Un achat massif occasionnel d'un client, s'il n'est pas signalé, conduira le modèle à surestimer la demande ultérieure.
- Les prévisions à long terme. Plus l'horizon est lointain, plus l'incertitude est élevée. L'IA est plus performante pour des prévisions glissantes de quelques semaines à quelques mois.
Par exemple, lorsqu'un distributeur de produits d'entretien lance de nouvelles capsules de lessive, le modèle ne peut pas fournir de prévision fiable ; l'équipe achats peut alors s'appuyer sur la courbe de lancement d'autres nouveautés de la même marque pour fixer la première commande, puis confier progressivement la main au modèle une fois quelques semaines de ventes réelles accumulées.
Comment mesurer la justesse d'une prévision ?
Mesurer la précision d'une prévision sert à juger si elle s'améliore et si l'on peut s'y fier, non à obtenir un beau chiffre. L'essentiel n'est pas de choisir tel ou tel indicateur, mais d'utiliser le même indicateur, selon la même méthode de calcul, et de le comparer de façon continue à une référence.
L'indicateur le plus courant est le MAPE (erreur absolue moyenne en pourcentage). Son principe est intuitif : de quel pourcentage, à chaque période, la prévision s'écarte de la réalité, puis on fait la moyenne. Par exemple, si un produit s'est vendu à 100 caisses et que la prévision était de 80, l'erreur de la période est de 20 %. Plus le MAPE est faible, plus la prévision est précise.
Mais le MAPE présente un défaut important pour les distributeurs. Le manuel de prévision « Forecasting: Principles and Practice », rédigé par des universitaires de Monash University, souligne que l'erreur en pourcentage ne peut pas être calculée lorsque les ventes réelles sont nulles, qu'elle devient extrêmement grande lorsqu'elles sont proches de zéro, et qu'elle pénalise de façon asymétrique la surestimation et la sous-estimation (source). Les distributeurs en gros ont de nombreux SKU de longue traîne, dont beaucoup n'enregistrent aucune vente certains jours ou certaines semaines ; calculer directement le MAPE aboutit facilement à des résultats déformés.
En pratique, on peut donc combiner plusieurs approches :
- L'erreur absolue moyenne (MAE). Elle mesure directement l'écart moyen entre prévision et réalité, en unités ou en caisses ; l'unité correspond à celle de l'activité, et elle est facile à comprendre.
- L'erreur pondérée par les volumes. On additionne les erreurs de tous les produits et on divise par le total des ventes ; les produits phares pèsent davantage, ce qui reflète mieux l'impact réel sur l'activité.
- La comparaison avec une méthode simple. Le MASE (erreur absolue moyenne échelonnée), présenté dans le manuel précité, compare l'erreur du modèle à celle de la méthode la plus simple, qui consiste à prendre les ventes de la période précédente comme prévision ; un résultat inférieur à 1 indique que le modèle fait mieux que la méthode simple.
- Le biais. Il indique si la prévision est durablement trop haute ou trop basse. Une surestimation persistante provoque des surstocks, une sous-estimation persistante des ruptures : cela mérite plus d'attention que la seule ampleur de l'erreur.
Enfin, la précision de prévision n'est qu'un indicateur intermédiaire. Ce qu'il faut vraiment regarder, c'est si les résultats opérationnels progressent : taux de rupture, nombre de jours de rotation des stocks, montant de la démarque pour produits proches de la date limite et taux de satisfaction des commandes.
Comment déployer pas à pas la prévision par IA et le réapprovisionnement intelligent ? Guide étape par étape
Déployer la prévision par IA ne suppose pas de couvrir tous les produits dès le départ. Démontrer l'efficacité sur quelques SKU stratégiques, puis élargir progressivement, est la voie la moins risquée et celle qui emporte le plus facilement l'adhésion des équipes.
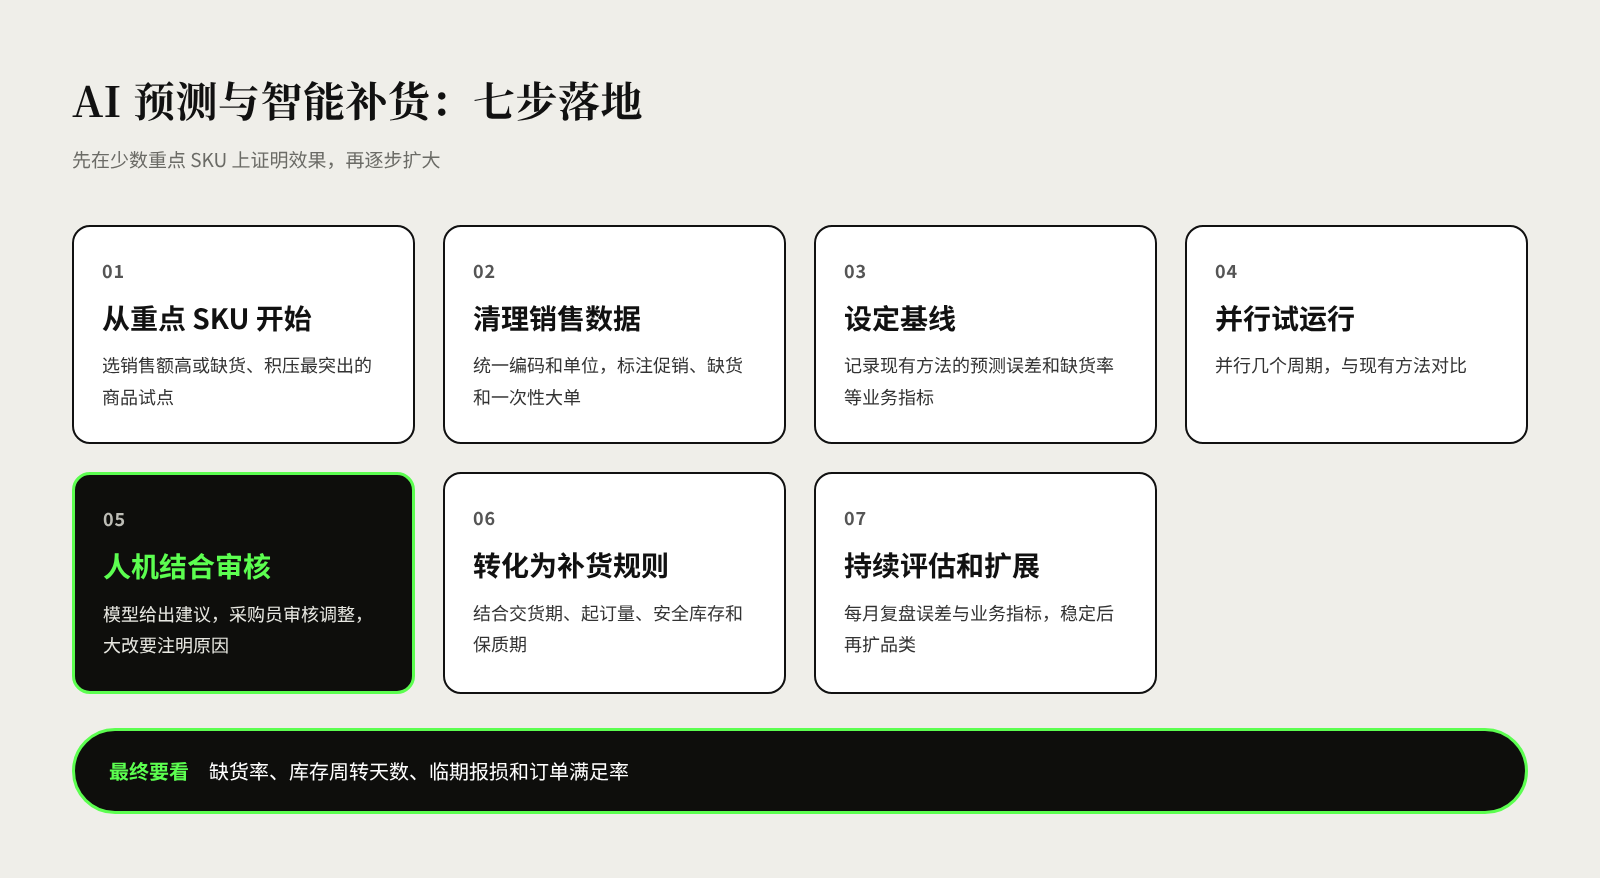
Étape 1 : commencer par quelques SKU stratégiques. Sélectionnez quelques dizaines à une ou deux centaines de SKU qui pèsent lourd dans le chiffre d'affaires, ou pour lesquels les ruptures et surstocks sont les plus marqués, comme premier lot pilote. Par exemple, choisissez les produits en tête du classement des ventes, auxquels s'ajoutent les catégories ayant enregistré le plus de démarque au cours des six derniers mois.
Étape 2 : nettoyer et organiser les données de ventes. Exportez au moins un à deux ans d'historique de commandes, harmonisez les codes produits et les unités de mesure, signalez les périodes de promotion, les périodes de rupture et les grosses commandes ponctuelles, et retirez les retours et les transferts internes. Le nettoyage des données est généralement l'étape la plus longue, et celle dont dépend le plus la réussite.
Étape 3 : définir une référence. Avant d'introduire l'IA, enregistrez l'erreur de prévision de la méthode actuelle (expérience de l'acheteur ou moyenne mobile), ainsi que des indicateurs opérationnels tels que le taux de rupture, le nombre de jours de rotation des stocks et la démarque pour produits proches de la date limite. Sans référence, impossible de juger si l'IA apporte une amélioration.
Étape 4 : essai à petite échelle, en comparaison avec la méthode actuelle. Faites fonctionner le modèle en parallèle de la méthode actuelle pendant plusieurs cycles de commande, et comparez les deux avec les mêmes indicateurs. À ce stade, il n'est pas nécessaire de passer commande immédiatement selon les résultats du modèle ; l'essentiel est d'observer sur quels produits il se comporte bien, et sur lesquels il se comporte mal.
Étape 5 : mettre en place un dispositif de revue associant humain et machine. Le modèle propose des quantités à commander ; l'acheteur les vérifie et les ajuste, en particulier pour les nouveautés, les produits en promotion et ceux dont on connaît une situation particulière. Demandez à l'acheteur d'indiquer brièvement la raison de toute modification importante, par exemple « un grand client ouvre deux nouveaux magasins le mois prochain ». Ces notes améliorent la qualité des décisions du moment et constituent aussi une information précieuse pour affiner le modèle.
Étape 6 : traduire les prévisions en règles de réapprovisionnement. La prévision répond seulement à la question « combien va-t-on vendre ? » ; le réapprovisionnement doit aussi répondre à « combien commander, et quand ? ». Il faut établir des règles de réapprovisionnement claires, en tenant compte des délais de livraison des fournisseurs, des quantités minimales de commande, du stock de sécurité, de la capacité d'entreposage et de la durée de conservation. Par exemple, pour les produits à courte durée de conservation, on fixe un stock de sécurité plus bas et des commandes plus fréquentes en petits lots.
Étape 7 : évaluer et étendre en continu. Chaque mois, passez en revue l'erreur de prévision, le biais et les indicateurs opérationnels, et analysez les causes pour les produits dont l'erreur est élevée. Une fois les résultats des SKU pilotes stabilisés, étendez progressivement à davantage de catégories et d'entrepôts, et mettez régulièrement le modèle à jour avec les nouvelles données.
Questions fréquentes sur la prévision de la demande par IA et le réapprovisionnement intelligent
Les volumes de données d'un distributeur de taille petite ou moyenne suffisent-ils pour la prévision par IA ? Dans la plupart des cas, oui. Dès lors que l'on dispose d'un à deux ans de commandes enregistrées par SKU, on peut commencer par les produits phares. Dans l'article cité plus haut, McKinsey considère aussi que, même avec des données limitées, celles de la plupart des entreprises suffisent pour bénéficier de la prévision par IA ; il faut simplement choisir des méthodes adaptées aux petits volumes de données.
La prévision par IA va-t-elle remplacer les acheteurs ? Non, mais l'accent de leur travail va changer. Les calculs courants et les propositions de réapprovisionnement sont confiés au système ; l'acheteur concentre son énergie sur la négociation avec les fournisseurs, l'introduction de nouveaux produits, le traitement des exceptions et l'appréciation des besoins des grands clients.
Quelle précision de prévision peut-on considérer comme bonne ? Il n'existe pas de norme unique : la difficulté de prévision varie fortement selon les catégories et les niveaux de détail. Il est plus pertinent de se comparer à sa propre référence, pour voir si l'erreur diminue durablement et si les ruptures et les surstocks reculent de concert.
Faut-il d'abord déployer un nouvel ERP ou un système spécialisé ? Pas nécessairement. Dès lors que l'on peut exporter des systèmes existants des données complètes de commandes, de stocks et de produits, on peut lancer un pilote. Mais si les données de commandes et de stocks sont dispersées dans plusieurs tableurs, avec des règles de calcul incohérentes, consolider d'abord les fondations de données est souvent plus urgent que d'introduire un outil de prévision.
Références
- AI-driven operations forecasting in data-light environments, McKinsey, février 2022
- Succeeding in the AI supply-chain revolution, McKinsey, avril 2021
- M5 accuracy competition: Results, findings, and conclusions (texte intégral du prépublication), Makridakis, Spiliotis, Assimakopoulos, International Journal of Forecasting, octobre 2022 (informations sur la revue)
- Forecasting: Principles and Practice (3e édition) : évaluation de la précision des prévisions, Rob J Hyndman, George Athanasopoulos, Monash University, consulté en novembre 2026


