Muchas empresas que prueban un gran modelo de lenguaje generalista se topan con el mismo problema: es capaz de redactar correos y hacer resúmenes, pero en cuanto se le pregunta por la política de gastos de la propia empresa, las condiciones de garantía de un modelo concreto o las condiciones de pago de un contrato con un cliente, o no sabe responder o se inventa una respuesta que parece verdadera. La causa no es complicada: esos documentos nunca formaron parte de los datos con los que se entrenó el modelo. Para que la IA entienda de verdad los documentos internos de tu empresa, lo importante no es cambiar a un modelo más potente, sino lograr que, antes de responder, encuentre los documentos correctos y diga con claridad de dónde sale la respuesta.
Esto es justo lo que busca resolver la generación aumentada por recuperación (RAG). En este artículo veremos por qué un modelo generalista no conoce tu empresa, cómo funciona RAG, en qué se diferencia del ajuste fino y del contexto largo, y cuáles son las causas habituales de que una base de conocimiento empresarial funcione mal, y ofreceremos una guía paso a paso para construirla y una sección de preguntas frecuentes.
¿Por qué un modelo generalista no conoce tu empresa y encima "se inventa las cosas con aplomo"?
El conocimiento de un modelo generalista procede de los datos públicos usados en su entrenamiento, y se queda congelado en el momento en que este termina. No ha visto tus normas internas, tus manuales de producto ni tus contratos con clientes, pero, cuando se le pregunta, a menudo da igualmente una respuesta.
Este "equivocarse con seguridad" se llama alucinación (hallucination). En el artículo de investigación "Why language models hallucinate", publicado en septiembre de 2025, OpenAI define la alucinación como las "afirmaciones plausibles pero erróneas" que genera un modelo, y señala una causa importante: los métodos habituales de entrenamiento y evaluación solo miran la tasa de aciertos, de modo que acertar por suerte puntúa y responder "no lo sé" puntúa cero; así, el modelo aprende a preferir adivinar antes que reconocer su incertidumbre (fuente). El artículo añade que, en conocimientos con regularidades, como la ortografía o la gramática, el modelo se vuelve cada vez más fiable a medida que crece, pero hechos poco frecuentes y sin patrón, como el cumpleaños de una persona concreta, no pueden inferirse a partir de patrones. Las cláusulas de las normas internas, las políticas de precios y los acuerdos con clientes pertenecen precisamente a esta categoría.
Por ejemplo, si un empleado pregunta "¿cuál es el límite de reembolso por noche de hotel en un viaje de trabajo?", un modelo generalista puede dar una cifra aparentemente razonable según la práctica habitual. Si esa cifra no coincide con la política de la empresa y el empleado pide el reembolso en consecuencia, el resultado es peor que un simple "no sé".
En resumen, un modelo generalista presenta tres carencias de origen en el entorno empresarial:
- No ve los documentos internos. Las normas, la documentación de producto, los registros de incidencias y los contratos de la empresa no están en ningún dato público de entrenamiento.
- Su conocimiento tiene fecha de caducidad. Tras un cambio en la lista de precios o una actualización de políticas, el modelo no se entera y puede seguir respondiendo según la situación anterior.
- No puede justificar su respuesta. Las respuestas no tienen fuente: los empleados no pueden contrastarlas y los responsables no pueden decidir si fiarse de ellas.
¿Qué es la generación aumentada por recuperación (RAG) y cómo funciona?
La idea de RAG (Retrieval-Augmented Generation, generación aumentada por recuperación) puede resumirse en "primero consultar, después responder". El modelo no necesita "memorizar" los documentos de la empresa: le basta con encontrar los pasajes relevantes antes de contestar y responder con base en ellos.
El concepto procede de un artículo de 2020. Patrick Lewis y otros investigadores de Facebook AI Research, University College London y la Universidad de Nueva York propusieron RAG en el artículo "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", publicado en NeurIPS 2020. Llamaron "memoria paramétrica" al conocimiento almacenado en los parámetros del modelo y "memoria no paramétrica" a la biblioteca externa de documentos que se puede consultar en cualquier momento (en los experimentos se usó Wikipedia), y señalaron que, con la primera sola, al modelo le resulta difícil indicar de dónde sale una respuesta y también actualizar su conocimiento (fuente). Estos dos puntos son, precisamente, los que más preocupan a las empresas.
En lenguaje no técnico, un sistema de preguntas y respuestas sobre una base de conocimiento empresarial suele constar de cuatro fases:
- Fragmentación de los documentos. Las normas, los manuales de producto, los contratos y demás se dividen en fragmentos breves (chunks), y cada fragmento se indexa para poder buscarlo después por su contenido.
- Recuperación. Cuando un empleado hace una pregunta, el sistema busca primero en el índice los fragmentos más relevantes. Una práctica habitual es combinar la búsqueda "por significado" (búsqueda vectorial) con la búsqueda "por palabras clave". Anthropic señala que la búsqueda por palabras clave resulta especialmente útil para cadenas que deben coincidir con exactitud, como los modelos de producto o los códigos de error (fuente).
- Respuesta con los documentos a la vista. El sistema entrega al modelo los fragmentos recuperados junto con la pregunta y le exige que responda solo a partir de ellos; si algo no figura en los documentos, debe contestar claramente "no se ha encontrado ninguna norma relacionada".
- Cita de la fuente. La respuesta incluye el documento, el apartado o la página de origen, y el empleado puede abrir el original con un clic para comprobarlo.
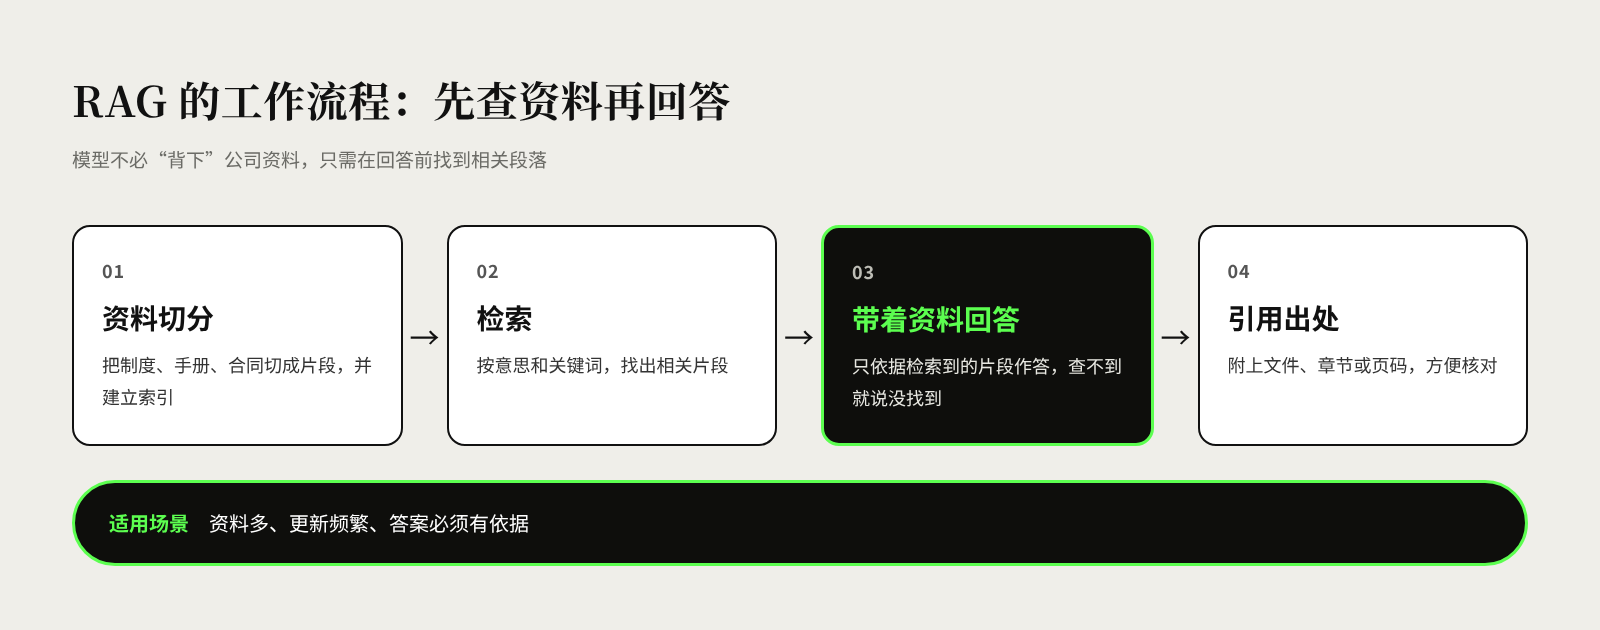
Por ejemplo, un agente de atención al cliente pregunta "¿cuántos años de garantía tiene el motor de este modelo?"; el sistema localiza primero las cláusulas pertinentes en el manual de producto y en la política de garantía, genera después la respuesta e indica de qué artículo de la "Política de garantía" procede. El agente no tiene que rebuscar por toda la unidad compartida y puede explicar a su cliente en qué se basa.
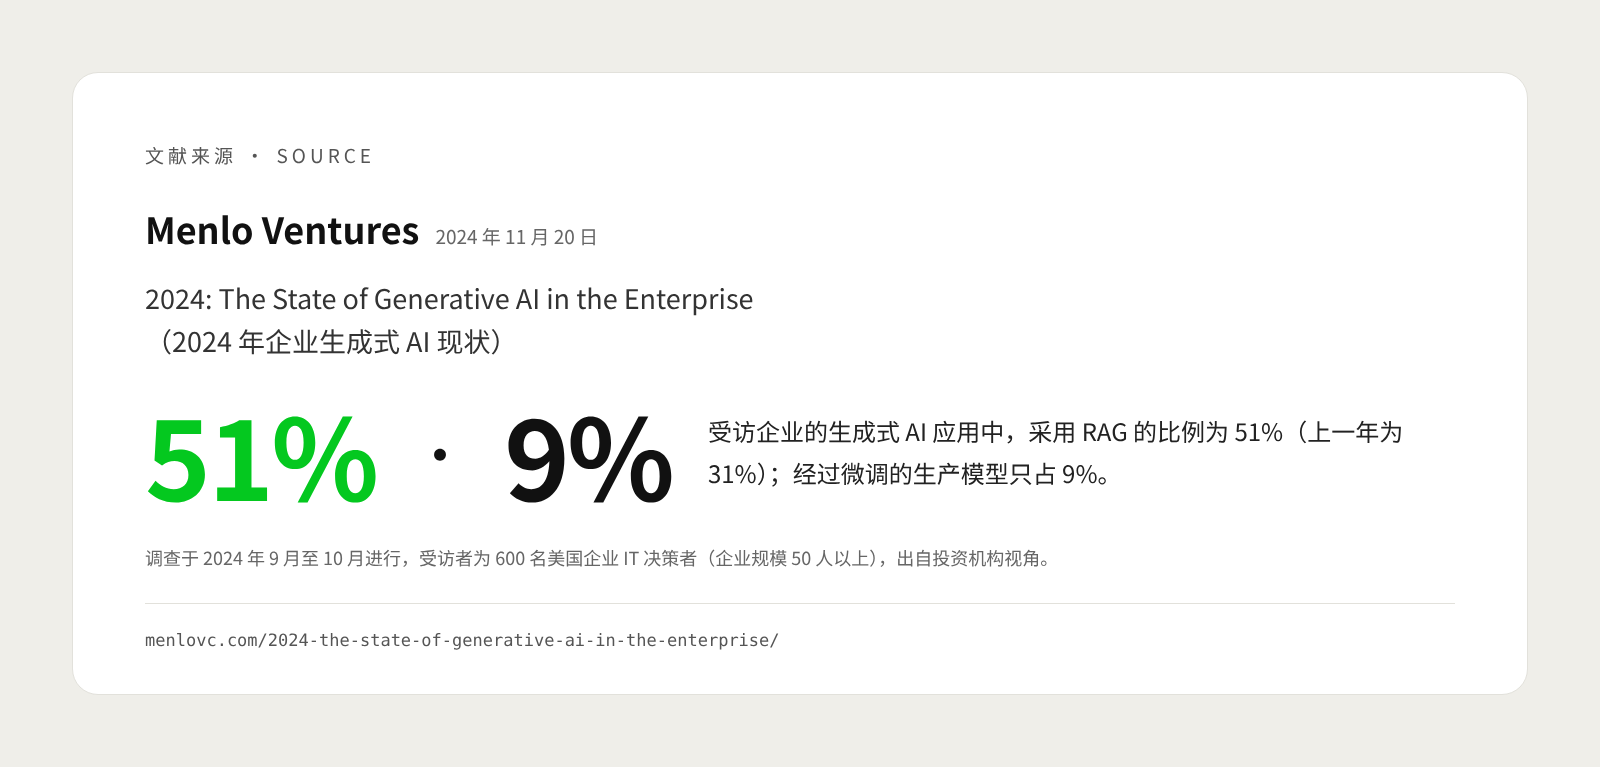
Esta práctica ya está bastante extendida en las empresas. La firma de inversión Menlo Ventures encuestó, entre septiembre y octubre de 2024, a 600 responsables de decisiones de TI de empresas estadounidenses (con 50 empleados o más) y observó que, entre las aplicaciones de IA generativa de las empresas encuestadas, la proporción que usaba RAG era del 51 %, frente al 31 % del año anterior, mientras que los modelos de producción con ajuste fino representaban solo el 9 % (fuente). Conviene tener en cuenta que esta encuesta solo abarca empresas de Estados Unidos y que procede de la perspectiva de una firma de inversión.
En la empresa, RAG se usa con más frecuencia en cuatro tipos de aplicaciones:
- Consultas sobre normas internas. Límites de reembolso, trámites de permisos, niveles de aprobación de compras, etc. Los nuevos empleados no tienen que preguntar una y otra vez a Recursos Humanos y a Finanzas, y las respuestas son más homogéneas.
- Consulta de documentación de producto. Ventas y atención al cliente encuentran rápidamente especificaciones, modelos compatibles y políticas de precios. Por ejemplo, el comercial de un mayorista consulta en casa del cliente el modelo sustitutivo de un SKU.
- Base de conocimiento posventa. Al integrar manuales de resolución de averías, incidencias históricas y registros de reparación, los agentes de atención al cliente o los técnicos pueden buscar casos similares y su solución a partir del síntoma de la avería.
- Búsqueda en contratos. Los profesionales de los departamentos jurídico y de compras localizan condiciones de pago, responsabilidades por incumplimiento o cláusulas de renovación, o comparan las diferencias entre los contratos de distintos proveedores. Estos casos conllevan un riesgo mayor, por lo que las respuestas deben ser revisadas por una persona.
Todos ellos tienen en común que hay muchos documentos, se actualizan con frecuencia y las respuestas deben tener respaldo. Es también un criterio sencillo para juzgar si un caso de uso es adecuado para RAG.
¿En qué se diferencian RAG, el ajuste fino y el contexto largo?
Hay tres formas habituales de que un modelo use los documentos de la empresa: RAG, el ajuste fino y el contexto largo. Para la mayoría de las necesidades de "consultar documentos y responder preguntas", RAG es el punto de partida más seguro; el ajuste fino es más adecuado para que el modelo aprenda formatos y formas de expresión fijos, no para inculcarle hechos.
El ajuste fino (fine-tuning) consiste en seguir entrenando el modelo con datos de ejemplo de la propia empresa; el contexto largo (long context) consiste en poner todo el documento directamente en el prompt que se entrega al modelo para que lo lea de una vez. Las diferencias entre los tres enfoques son las siguientes:
| Aspecto | RAG (generación aumentada por recuperación) | Ajuste fino | Contexto largo |
|---|---|---|---|
| Enfoque básico | Recupera fragmentos relevantes antes de responder | Vuelve a entrenar el modelo con datos de ejemplo | Introduce todo el documento de una vez en el prompt |
| Necesidades a las que se adapta | Muchos documentos, actualizaciones frecuentes, necesidad de citar la fuente | Formato fijo, tono, terminología sectorial, tareas de clasificación | Poco volumen de documentos, o análisis puntual de un documento largo |
| Actualización de los documentos | Basta con actualizar los documentos y el índice | Suele requerir un nuevo entrenamiento | Hay que volver a introducirlos en cada llamada |
| Cita de la fuente | Fácil de lograr | Muy difícil de lograr | Posible, pero hay que exigirlo mediante el prompt |
| Control de permisos | Se puede filtrar por quien pregunta durante la recuperación | Muy difícil: el conocimiento ya se ha mezclado con los parámetros del modelo | Requiere una selección manual antes de introducir los documentos |
| Coste principal | Organización de los documentos, y construcción y mantenimiento del indexado y la recuperación | Preparación de datos, entrenamiento y evaluación repetida | El coste y el tiempo de espera de procesar grandes cantidades de texto en cada ocasión |
| Principal limitación | Si no recupera, no responde bien | Sigue alucinando y es difícil eliminar un conocimiento concreto | Si hay demasiados documentos, no caben; la información situada en medio de un texto largo tiende a pasarse por alto |
Las comparaciones de la tabla son válidas en general; la elección concreta depende también del volumen de documentos y de la frecuencia de uso.
Cuando el volumen de documentos es pequeño, el contexto largo es una solución sencilla que merece consideración. En un artículo técnico de septiembre de 2024, Anthropic recomienda que, si la base de conocimiento es inferior a unos 200.000 tokens (el token es la unidad básica con la que el modelo procesa el texto; esa cantidad equivale aproximadamente a 500 páginas de documentos), se puede poner todo el contenido directamente en el prompt sin necesidad de montar un sistema RAG; solo cuando la base de conocimiento es mayor hace falta una solución más escalable (fuente).
Pero "que quepa" no equivale a "que se lea con atención". Investigadores de la Universidad de Stanford y otras instituciones descubrieron, en el artículo "Lost in the Middle", que el modelo rinde mejor cuando la información clave está al principio o al final de una entrada larga, y que su rendimiento baja de forma notable cuando está en medio, incluso en modelos diseñados específicamente para contextos largos (fuente). Por eso, en la práctica, los tres métodos suelen combinarse. Por ejemplo, primero se usa RAG para localizar el contrato relacionado con la pregunta y después se introduce el contrato completo en el contexto para leerlo cláusula por cláusula.
¿Por qué muchas bases de conocimiento empresariales funcionan mal?
Cuando una base de conocimiento responde mal, el problema suele estar no en el modelo, sino en los documentos y en la gestión. RAG solo amplifica la calidad de los propios documentos: si los documentos están desordenados, las respuestas tampoco serán precisas.
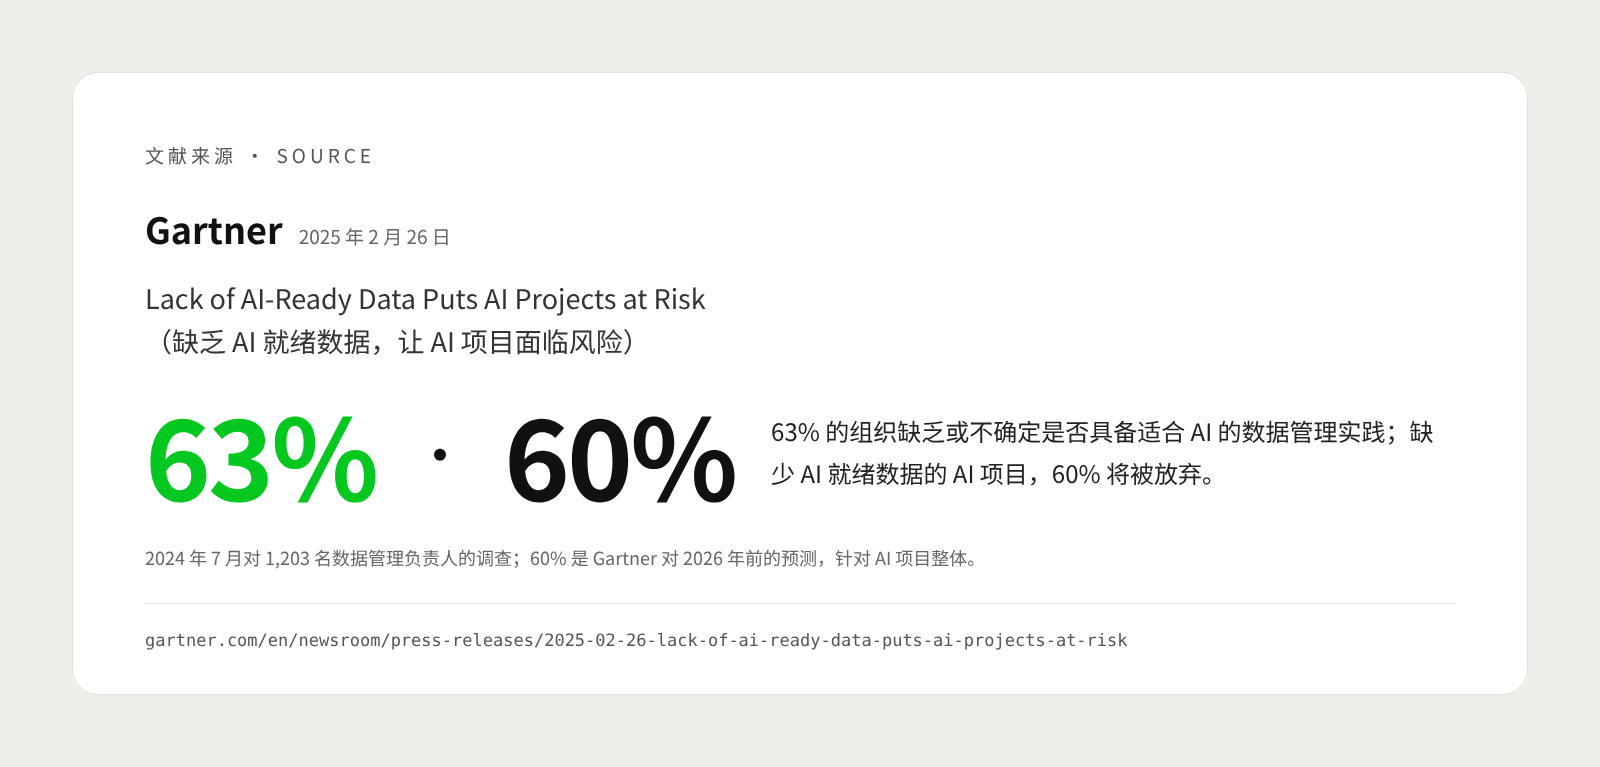
En julio de 2024, Gartner encuestó a 1.203 responsables de gestión de datos: el 63 % de las organizaciones dijo que no disponía de prácticas de gestión de datos adecuadas para la IA, o que no estaba seguro de tenerlas; con base en ello, Gartner prevé que, de aquí a 2026, el 60 % de los proyectos de IA que carezcan del respaldo de "datos preparados para la IA" serán abandonados (fuente). Esta encuesta se refiere a los proyectos de IA en su conjunto, pero es igualmente aplicable a las bases de conocimiento.
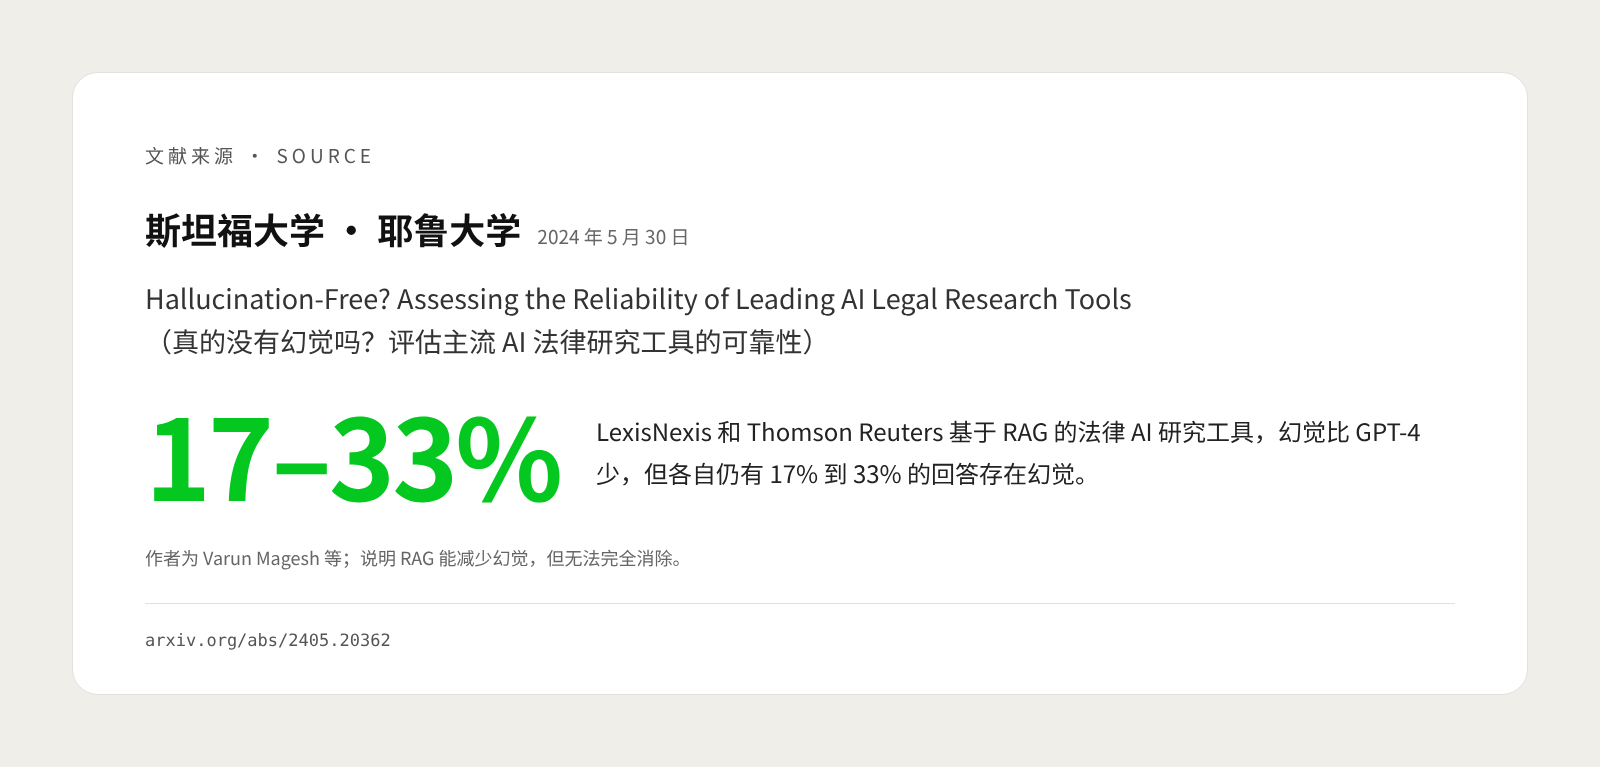
Ni siquiera los productos de proveedores especializados permiten tratar RAG como una panacea. En 2024, investigadores de las universidades de Stanford y Yale evaluaron las herramientas de investigación jurídica con IA basadas en RAG de LexisNexis y Thomson Reuters, y hallaron que alucinan menos que un chatbot generalista (GPT-4), pero que, aun así, entre el 17 % y el 33 % de sus respuestas contienen alucinaciones (fuente).
En la práctica empresarial, los malos resultados suelen deberse a estas cinco causas:
- Documentos obsoletos, duplicados o contradictorios. En la unidad compartida, una misma norma puede existir a la vez como "versión 2023", "versión 2024" y "definitivo (2)". Si la recuperación encuentra una versión antigua, la respuesta será errónea, y además lo será de forma muy convincente.
- Los permisos no se han resuelto bien. Conectar una base de conocimiento no significa que todo el mundo pueda preguntar por la tabla salarial o por los presupuestos de los clientes. En su edición de 2025 de los diez principales riesgos de las aplicaciones de modelos de lenguaje, OWASP incluye específicamente las debilidades relacionadas con vectores y embeddings: con un control de acceso débil, el modelo puede recuperar y filtrar datos personales o secretos comerciales, y cuando varios grupos de usuarios comparten una misma base de datos vectorial también puede producirse una fuga de información entre grupos. Recomienda usar un almacenamiento que admita permisos granulares y particionar los datos según el nivel de acceso (fuente).
- Formatos de documento caóticos. Los PDF escaneados, las tablas incrustadas en imágenes, los Excel con celdas combinadas y los diagramas de flujo dibujados en PowerPoint pierden información con facilidad al fragmentarse.
- La fragmentación pierde el contexto. Anthropic pone un ejemplo: un fragmento que solo dice "los ingresos de la empresa crecieron un 3 % respecto al trimestre anterior", sin indicar de qué empresa ni de qué trimestre se trata, es muy difícil de encontrar en la recuperación. En sus propias pruebas comprobó que añadir contexto a cada fragmento y combinarlo con la búsqueda por palabras clave puede reducir un 49 % los fallos de recuperación, y un 67 % si además se reordenan los resultados (fuente). Son resultados de las pruebas del propio proveedor, pero muestran que el diseño del método de recuperación influye de forma notable en el resultado.
- No hay evaluación. Sin un conjunto estándar de preguntas y respuestas, tras cambiar la forma de fragmentar, sustituir el modelo o añadir documentos, nadie sabe decir si el resultado ha mejorado o empeorado y solo se puede juzgar por impresiones sueltas de uso.
¿Cómo construir una base de conocimiento empresarial fiable? Guía paso a paso
Al construir una base de conocimiento empresarial, la elección de la tecnología suele ser la parte más fácil. Empieza por un caso de uso frecuente y con documentos claramente delimitados; primero ordena los documentos y define con claridad los permisos, y después ya hablaremos de tecnología.
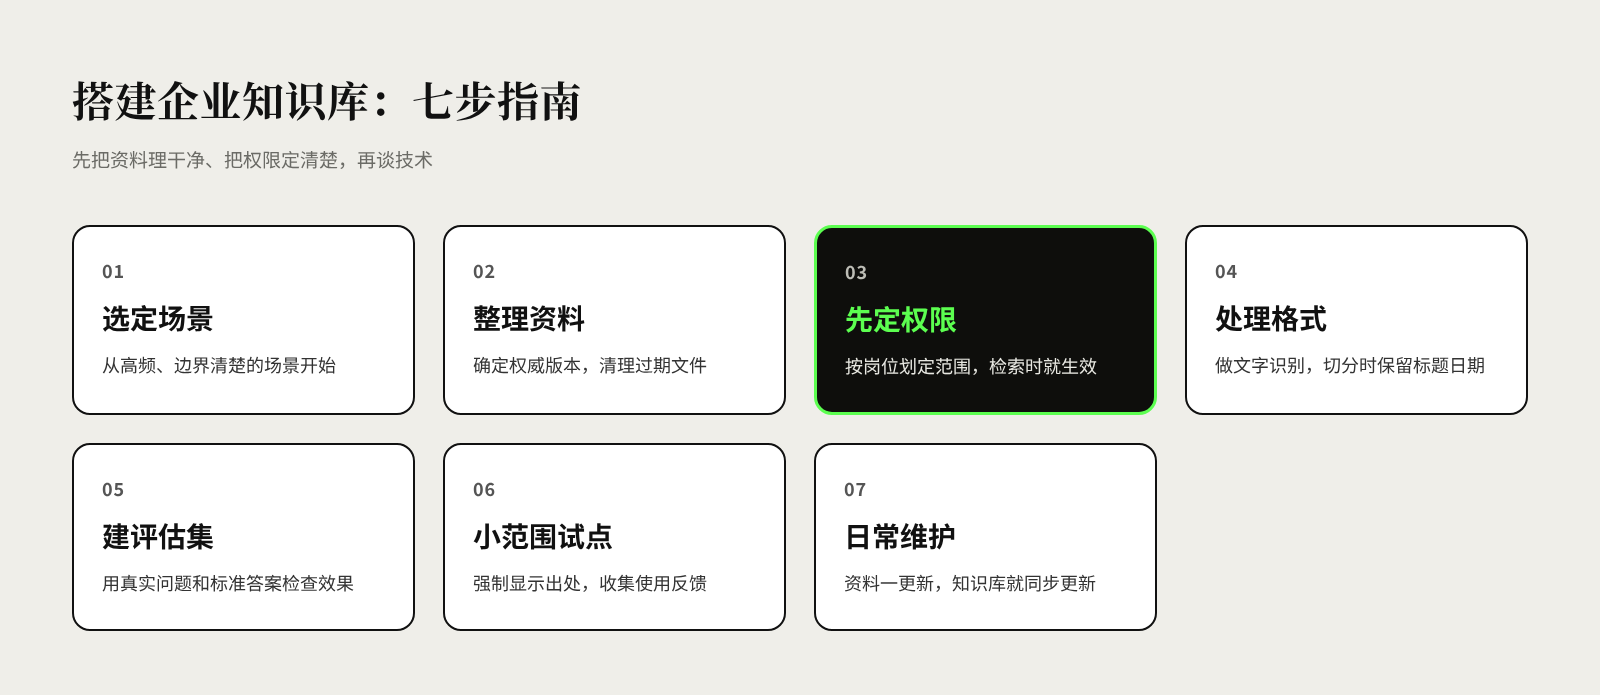
Paso 1: elige un caso de uso concreto y define quién lo usará. Por ejemplo, "los empleados de las tiendas consultan la política de cambios y devoluciones" o "atención al cliente consulta las cláusulas de garantía de los productos", en lugar de empezar directamente por una "base de conocimiento de toda la empresa". Cuanto más concreto sea el caso, más claros serán el alcance de los documentos y los criterios de éxito.
Paso 2: haz inventario y ordena los documentos. Localiza la versión de referencia de cada tipo de documento, elimina los archivos duplicados y obsoletos, y asigna a cada documento un responsable y un ciclo de actualización. Es el paso que más trabajo exige, pero es el que fija el techo de la base de conocimiento.
Paso 3: define primero las reglas de permisos. Divide la visibilidad de los documentos por departamento, puesto, tienda o cliente, y aprovecha en lo posible la configuración de permisos de los sistemas existentes. Los permisos deben aplicarse en la fase de recuperación: el sistema solo recupera los documentos que quien pregunta tiene derecho a ver, y no los recupera todos para luego pedirle al modelo que "no lo diga".
Paso 4: trata los formatos y fragmenta con criterio. Aplica reconocimiento de texto a los documentos escaneados y convierte las tablas importantes a un formato estructurado; al fragmentar, conserva en cada fragmento datos como el nombre del archivo, el título del apartado y la fecha de entrada en vigor, para que ningún fragmento quede desligado de su contexto.
Paso 5: crea un conjunto de preguntas de evaluación. Reúne desde primera línea un conjunto de preguntas reales y redacta la respuesta estándar y la fuente correspondiente. Tras cada ajuste, comprueba con el mismo conjunto de preguntas si se han encontrado los documentos correctos, si la respuesta es correcta, si la fuente es exacta y si, cuando algo no figura en los documentos, responde con sinceridad "no se ha encontrado".
Paso 6: haz un piloto a pequeña escala y obliga a mostrar la fuente. Empieza con un equipo o unas pocas tiendas, muestra la fuente en cada respuesta y ofrece un botón de comentarios "útil / no útil". Revisa periódicamente las preguntas sin respuesta o con respuesta errónea y, a partir de ellas, completa o corrige los documentos.
Paso 7: convierte el mantenimiento en un proceso diario. En cuanto se actualicen las normas o la documentación de producto, la base de conocimiento debe actualizarse con ellas. Gartner subraya también que los datos preparados para la IA no son un trabajo que se haga "de una vez por todas" (fuente). Puedes incluir "sincronizar la base de conocimiento" en la lista de comprobación del proceso de publicación de normas y de lanzamiento de productos.
Preguntas frecuentes sobre la base de conocimiento empresarial y RAG
¿Es seguro entregar los documentos de la empresa a una IA? Depende de la forma de despliegue y de las condiciones del proveedor. Al elegir, hay que confirmar al menos cuatro cosas: dónde se almacenan los datos, si se usarán para entrenar modelos, durante cuánto tiempo se conservan y quién puede acceder a ellos. Para documentos muy sensibles, se puede considerar un despliegue privado o fijar en el contrato el alcance del uso de los datos.
¿Pueden los empleados ver, a través de la base de conocimiento, documentos que no deberían ver? Si no se ha implantado un control de permisos, es posible. Lo correcto es filtrar durante la recuperación según los permisos de quien pregunta y entregar al modelo solo los fragmentos que esa persona tiene derecho a ver. No se puede esperar que el modelo juzgue por sí mismo quién debe ver qué.
¿Hay que construirla por cuenta propia? No necesariamente. Muchas herramientas ofimáticas y sistemas de atención al cliente ya incorporan funciones de preguntas y respuestas sobre bases de conocimiento; si el volumen de documentos es pequeño y el caso es estándar, puedes validar primero el resultado con un producto ya hecho; cuando haga falta conectar varios sistemas internos, los permisos sean complejos o se exija un despliegue privado, entonces conviene plantearse una solución a medida o propia. En cualquier caso, ordenar los documentos y evaluar los resultados es imprescindible.
¿Con RAG la IA ya no se inventa nada? No. RAG reduce claramente las alucinaciones, pero no las elimina por completo, y la evaluación de las herramientas jurídicas mencionada antes lo demuestra. Hay que exigir que cada respuesta incluya su fuente y mantener la revisión humana en las preguntas de alto riesgo, como las de contratos o finanzas.
Referencias
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis y otros (Facebook AI Research, University College London, Universidad de Nueva York), NeurIPS 2020, mayo de 2020
- Why language models hallucinate, OpenAI, septiembre de 2025
- 2024: The State of Generative AI in the Enterprise, Menlo Ventures, noviembre de 2024
- Introducing Contextual Retrieval, Anthropic, septiembre de 2024
- Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu y otros, Transactions of the Association for Computational Linguistics, julio de 2023
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, febrero de 2025
- Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Varun Magesh y otros (Universidad de Stanford, Universidad de Yale), mayo de 2024
- LLM08:2025 Vector and Embedding Weaknesses, OWASP, 2025


