Molte aziende che provano un modello linguistico generalista si imbattono nello stesso problema: sa scrivere e-mail e fare riassunti, ma quando gli si chiede la policy sui rimborsi spese dell'azienda, le condizioni di garanzia di un determinato modello o i termini di pagamento di un contratto con un cliente, o non sa rispondere oppure inventa una risposta che sembra vera. Il motivo non è complicato: quei documenti non sono mai stati nei dati di addestramento del modello. Per far capire davvero all'IA i documenti interni, la chiave non è cambiare modello con uno più potente, ma fare in modo che, prima di rispondere, trovi i documenti giusti e indichi con chiarezza da dove proviene la risposta.
È esattamente il problema che la retrieval-augmented generation (RAG) vuole risolvere. Questo articolo spiega perché un modello generalista non conosce la tua azienda, come funziona la RAG, in cosa si differenzia dal fine-tuning e dal contesto lungo e quali sono le cause più comuni dello scarso rendimento di una knowledge base aziendale, e offre una guida passo dopo passo alla realizzazione e una sezione di domande frequenti.
Perché un modello generalista non conosce la tua azienda e “inventa con aria seria”?
Le conoscenze di un modello generalista derivano dai dati pubblici usati nell'addestramento e si fermano al momento in cui questo è terminato. Non ha mai visto le tue procedure interne, i manuali di prodotto e i contratti con i clienti, ma quando gli si pone una domanda, di solito fornisce comunque una risposta.
Questo “sbagliare con sicurezza” si chiama allucinazione (hallucination). Nell'articolo di ricerca “Why language models hallucinate”, pubblicato a settembre 2025, OpenAI definisce le allucinazioni come “affermazioni plausibili ma errate” generate dal modello e indica una causa importante: i metodi abituali di addestramento e valutazione guardano solo al tasso di risposte corrette, per cui indovinare dà punti mentre rispondere “non lo so” vale zero, e il modello viene quindi addestrato a preferire la congettura all'ammissione di incertezza (fonte). L'articolo osserva anche che le conoscenze regolari, come ortografia e grammatica, diventano sempre più affidabili al crescere del modello, mentre fatti rari e privi di regolarità, come la data di nascita di una persona, non si possono dedurre dai pattern. I regolamenti interni di un'azienda, le politiche di prezzo e gli accordi con i clienti appartengono proprio a questa seconda categoria.
Per esempio, se un dipendente chiede “qual è il massimale di rimborso per una notte d'albergo in trasferta”, un modello generalista potrebbe indicare un importo plausibile in base alle prassi più comuni. Se quella cifra non corrisponde alla policy aziendale e il dipendente chiede il rimborso su quella base, le conseguenze sono peggiori di un semplice “non so rispondere”.
In sintesi, in ambito aziendale un modello generalista ha tre lacune congenite:
- Non vede i documenti interni. Procedure, documentazione di prodotto, registri dei ticket e contratti non fanno parte di alcun dato di addestramento pubblico.
- Le sue conoscenze hanno una data di scadenza. Dopo una revisione del listino o un aggiornamento delle policy il modello non lo sa e può continuare a rispondere in base alla situazione precedente.
- Non sa indicare la base della risposta. Una risposta senza fonte non può essere verificata dai dipendenti, e i responsabili non possono decidere se fidarsene.
Che cos'è la retrieval-augmented generation (RAG) e come funziona?
L'idea della RAG (Retrieval-Augmented Generation) si può riassumere in “prima consulta i documenti, poi rispondi”. Il modello non deve “imparare a memoria” i documenti dell'azienda: gli basta trovare i passaggi rilevanti prima di rispondere e rispondere sulla base di quelli.
Il concetto nasce da un articolo del 2020. Patrick Lewis e altri ricercatori di Facebook AI Research, University College London e New York University hanno proposto la RAG nel paper “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, presentato a NeurIPS 2020. Hanno chiamato “memoria parametrica” la conoscenza contenuta nei parametri del modello e “memoria non parametrica” una raccolta esterna di documenti consultabile in qualsiasi momento (negli esperimenti, Wikipedia), osservando che con la sola prima è difficile per il modello indicare la provenienza delle risposte e altrettanto difficile aggiornare le conoscenze (fonte). Sono proprio i due aspetti a cui le aziende tengono di più.
In termini non tecnici, un sistema di domande e risposte su una knowledge base aziendale comprende di solito quattro fasi:
- Suddivisione dei documenti. Procedure, manuali di prodotto, contratti e simili vengono divisi in porzioni più brevi (chunk), ciascuna indicizzata in modo da poter essere trovata in seguito in base al contenuto.
- Recupero. Dopo la domanda del dipendente, il sistema individua nell'indice i frammenti più pertinenti. La pratica più diffusa consiste nel combinare la “ricerca per significato” (ricerca vettoriale) con la “ricerca per parole chiave”. Anthropic osserva che la ricerca per parole chiave è particolarmente utile per stringhe che devono corrispondere esattamente, come i codici modello o i codici di errore (fonte).
- Risposta con i documenti in mano. Il sistema passa al modello i frammenti recuperati insieme alla domanda, chiedendogli di rispondere solo in base a quel materiale; se nei documenti non c'è nulla, deve dichiarare chiaramente “nessuna disposizione pertinente trovata”.
- Citazione della fonte. La risposta riporta il file di origine, il capitolo o il numero di pagina, e il dipendente può aprire l'originale con un clic per verificare.
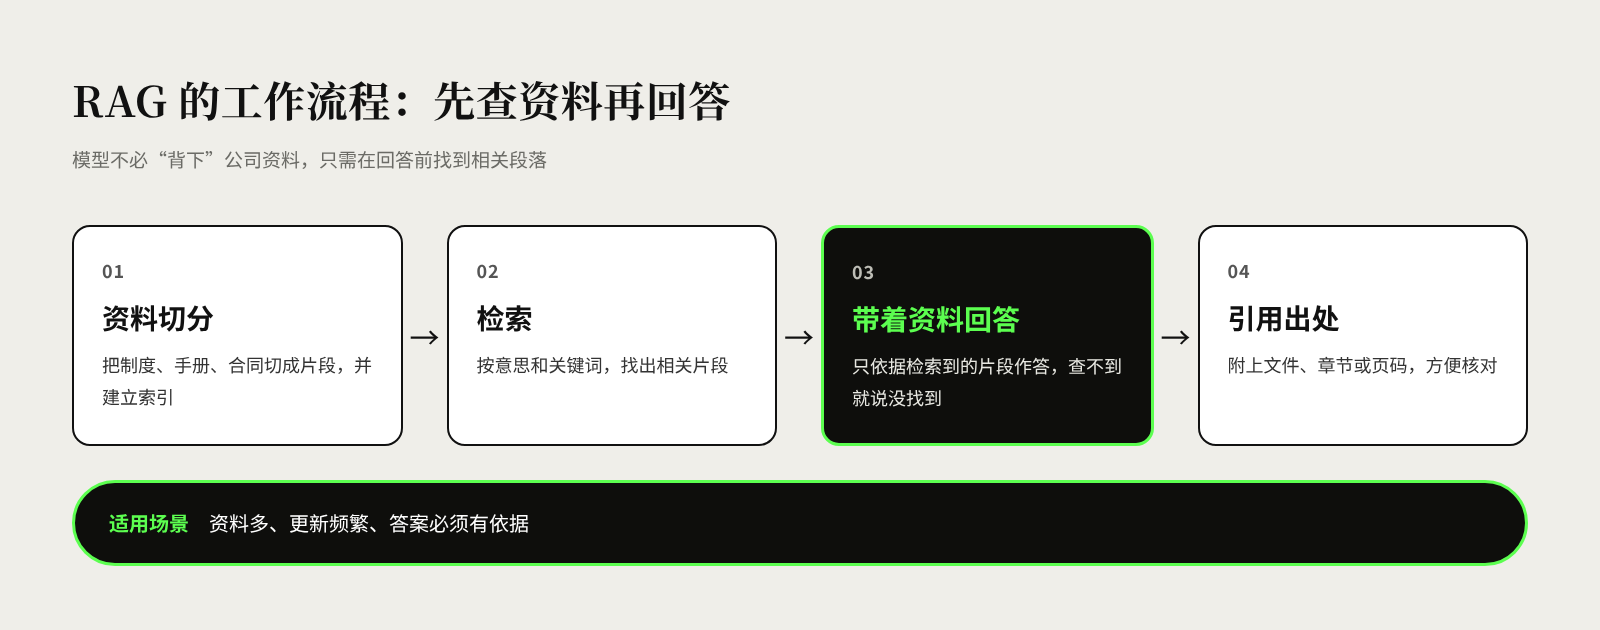
Per esempio, un operatore del servizio clienti chiede “quanti anni di garanzia ha il motore di un certo modello di prodotto”: il sistema trova prima le clausole pertinenti nel manuale di prodotto e nella policy di garanzia, poi genera la risposta indicando l'articolo esatto della “Policy di garanzia” da cui proviene. L'operatore non deve rovistare nelle cartelle condivise e può spiegare al cliente su che cosa si basa la risposta.
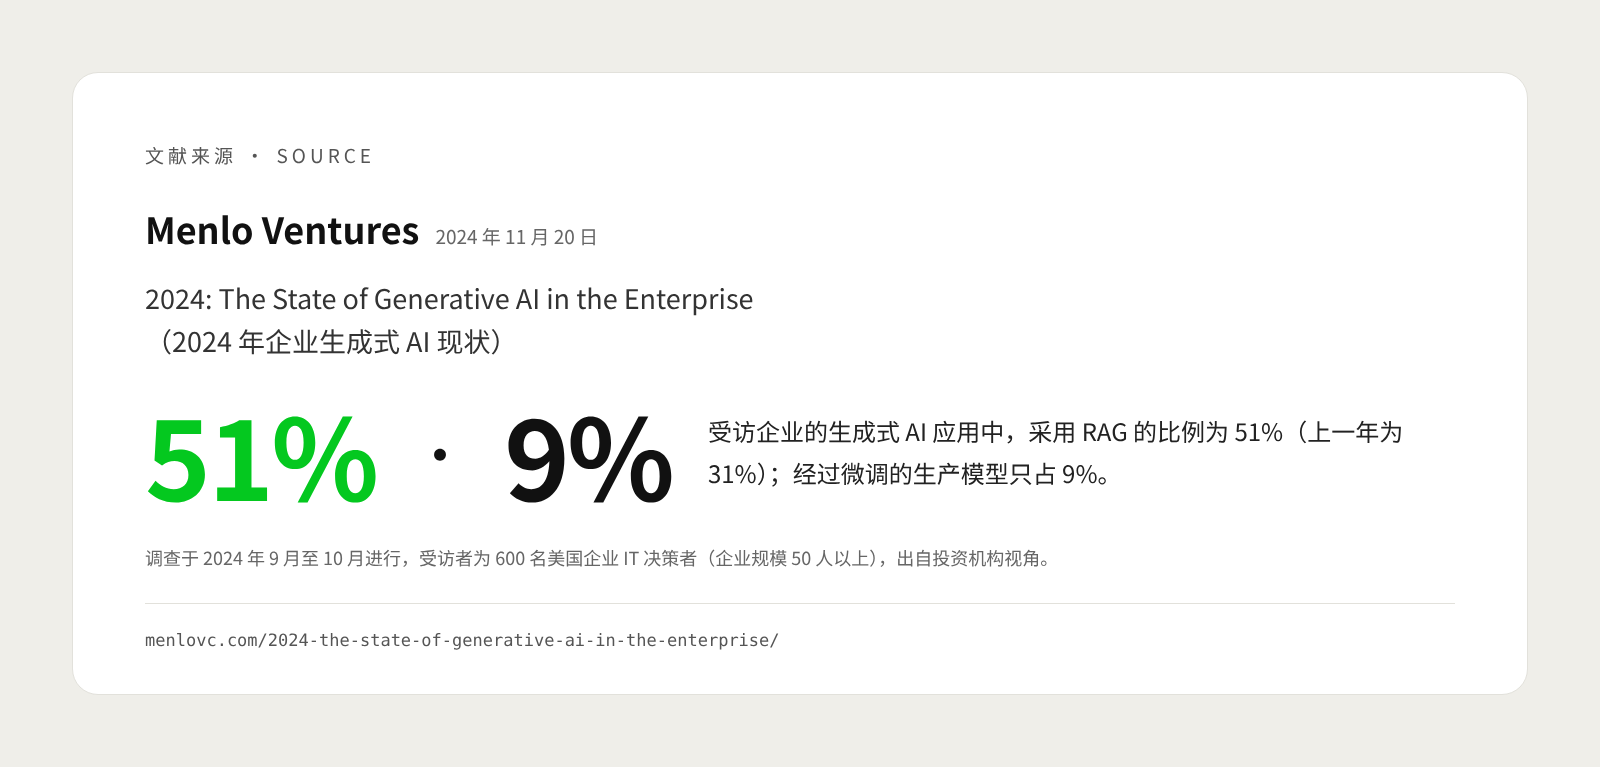
Questo approccio è ormai piuttosto diffuso nelle aziende. La società di investimento Menlo Ventures ha intervistato tra settembre e ottobre 2024 600 responsabili IT di imprese statunitensi (con almeno 50 dipendenti) e ha rilevato che, tra le applicazioni di IA generativa delle aziende intervistate, la quota che adotta la RAG è del 51%, contro il 31% dell'anno precedente, mentre i modelli di produzione sottoposti a fine-tuning sono solo il 9% (fonte). Va precisato che l'indagine riguarda solo aziende statunitensi e riflette il punto di vista di un investitore.
In azienda, la RAG ha quattro usi più comuni:
- Domande sulle procedure interne. Standard di rimborso, iter per le richieste di ferie, poteri di approvazione degli acquisti e simili. I nuovi assunti non devono chiedere continuamente a HR e amministrazione, e le risposte sono più uniformi.
- Consultazione della documentazione di prodotto. Commerciali e servizio clienti trovano rapidamente specifiche tecniche, modelli compatibili e politiche di prezzo. Per esempio, l'agente di un grossista cerca presso il cliente il modello sostitutivo di un determinato SKU.
- Knowledge base post-vendita. Integrando manuali di diagnostica guasti, storico dei ticket e registri di riparazione, gli operatori dell'assistenza o i tecnici possono cercare casi analoghi e relative soluzioni a partire dal sintomo del guasto.
- Ricerca nei contratti. Il personale legale e acquisti cerca condizioni di pagamento, responsabilità per inadempimento, clausole di rinnovo, oppure confronta le differenze tra i contratti di fornitori diversi. In questi casi il rischio è più alto e le risposte dovrebbero essere verificate da una persona.
Hanno in comune un aspetto: molti documenti, aggiornamenti frequenti, risposte che devono avere un fondamento. È anche il criterio semplice per valutare se uno scenario si presti alla RAG.
Che differenza c'è tra RAG, fine-tuning e contesto lungo?
Per far usare al modello i documenti aziendali ci sono tre approcci comuni: RAG, fine-tuning e contesto lungo. Per la maggior parte delle esigenze di “consultare documenti e rispondere a domande” la RAG è il punto di partenza più sicuro; il fine-tuning è più adatto a insegnare al modello formati ed espressioni fissi, non a trasmettergli dei fatti.
Il fine-tuning consiste nel proseguire l'addestramento del modello con dati di esempio dell'azienda; il contesto lungo (long context) consiste nell'inserire l'intero materiale direttamente nel prompt, perché il modello lo legga tutto in una volta. Le differenze sono le seguenti:
| Criterio | RAG (retrieval-augmented generation) | Fine-tuning | Contesto lungo |
|---|---|---|---|
| Approccio di base | Prima di rispondere recupera i frammenti pertinenti | Riaddestra il modello con dati di esempio | Inserisce l'intero materiale nel prompt in un'unica volta |
| Esigenze adatte | Molti documenti, aggiornamenti frequenti, necessità di citare le fonti | Formato fisso, tono, terminologia di settore, compiti di classificazione | Poco materiale, oppure analisi una tantum di un singolo documento lungo |
| Aggiornamento dei documenti | Basta aggiornare documenti e indice | Spesso richiede un nuovo addestramento | Va reinserito a ogni chiamata |
| Citazione delle fonti | Facile da ottenere | Molto difficile da ottenere | Possibile, ma va imposta tramite il prompt |
| Controllo dei permessi | Può filtrare in base a chi pone la domanda durante il recupero | Molto difficile, la conoscenza è ormai mescolata ai parametri del modello | Richiede una selezione manuale prima dell'inserimento |
| Costo principale | Ordinamento dei documenti, realizzazione e manutenzione di indicizzazione e recupero | Preparazione dei dati, addestramento e valutazioni ripetute | Costo e tempi di attesa per elaborare ogni volta grandi quantità di testo |
| Limiti principali | Se non trova, non risponde bene | Continua ad avere allucinazioni, ed è difficile eliminare una singola conoscenza | Troppo materiale non ci sta, e le informazioni a metà di un testo lungo tendono a essere trascurate |
I confronti in tabella valgono in via generale; la scelta concreta dipende anche dal volume dei documenti e dalla frequenza d'uso.
Quando i documenti sono pochi, il contesto lungo è una soluzione semplice da prendere in considerazione. In un articolo tecnico di settembre 2024, Anthropic suggerisce che, se la knowledge base è inferiore a circa 200.000 token (il token è l'unità di base con cui il modello elabora il testo; questa dimensione equivale più o meno a 500 pagine di materiale), si può inserire tutto il contenuto direttamente nel prompt senza costruire una RAG; solo con knowledge base più grandi servono soluzioni più scalabili (fonte).
Ma “starci” non significa “essere letto con attenzione”. Nel paper “Lost in the Middle”, ricercatori di Stanford University e altre istituzioni hanno rilevato che il modello rende al meglio quando l'informazione chiave si trova all'inizio o alla fine di un input lungo, mentre le prestazioni calano sensibilmente quando si trova nel mezzo, anche per i modelli progettati appositamente per i contesti lunghi (fonte). Per questo, nella pratica, i tre metodi si usano spesso insieme. Per esempio, si usa prima la RAG per individuare il contratto pertinente alla domanda, poi si inserisce l'intero contratto nel contesto per leggerlo clausola per clausola.
Perché molte knowledge base aziendali funzionano male?
Quando una knowledge base risponde male, il problema nella maggior parte dei casi non è il modello, ma i documenti e la gestione. La RAG amplifica soltanto la qualità dei documenti: se i documenti sono disordinati, anche le risposte non saranno precise.
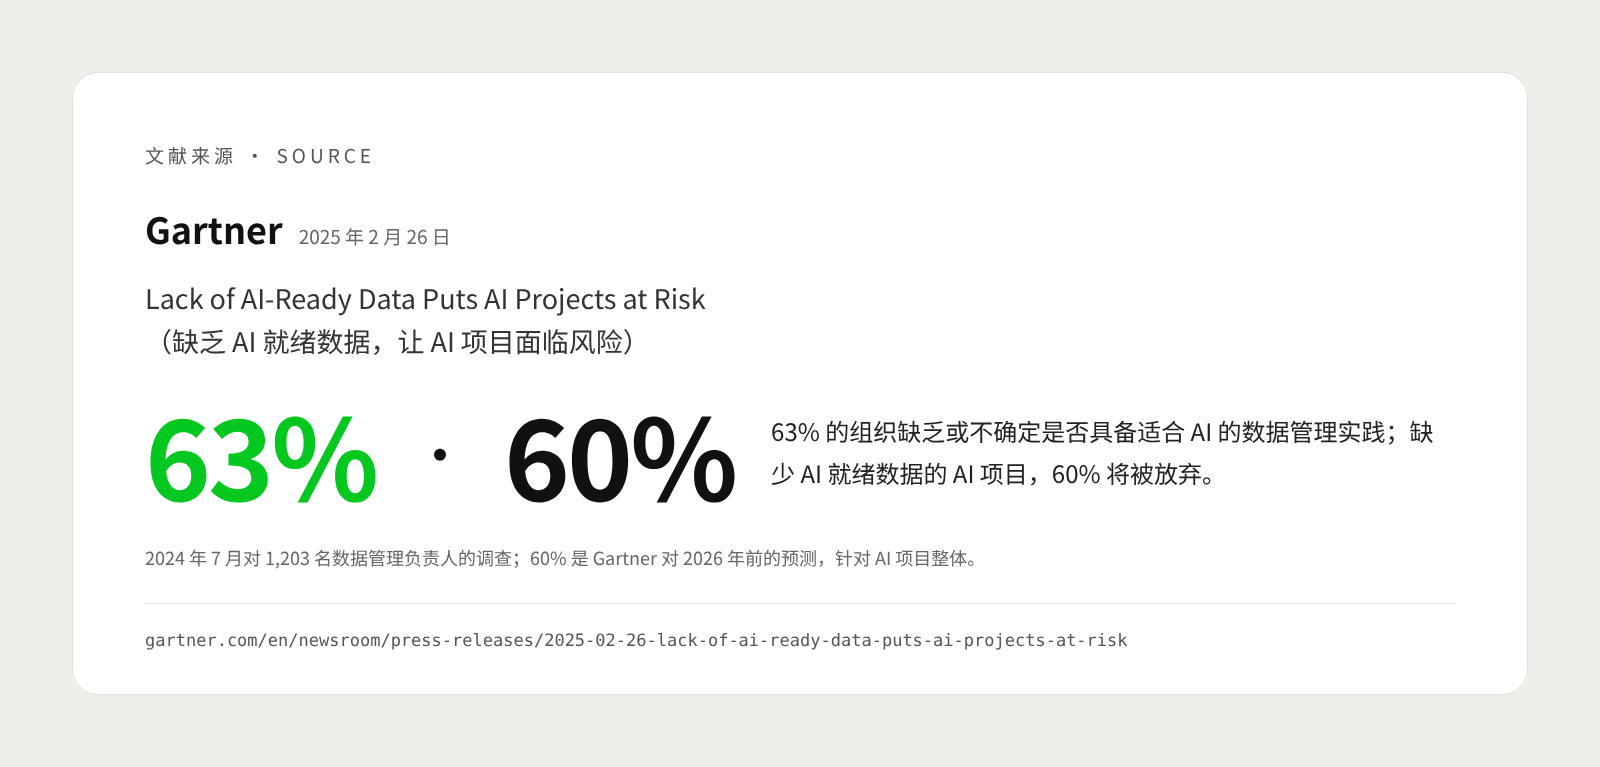
Nel luglio 2024 Gartner ha intervistato 1.203 responsabili della gestione dei dati: il 63% delle organizzazioni ha dichiarato di non avere, o di non essere sicuro di avere, pratiche di gestione dei dati adatte all'IA; su questa base Gartner prevede che, entro il 2026, il 60% dei progetti di IA privi del supporto di “dati pronti per l'IA” verrà abbandonato (fonte). L'indagine riguarda i progetti di IA nel loro insieme, ma vale anche per le knowledge base.
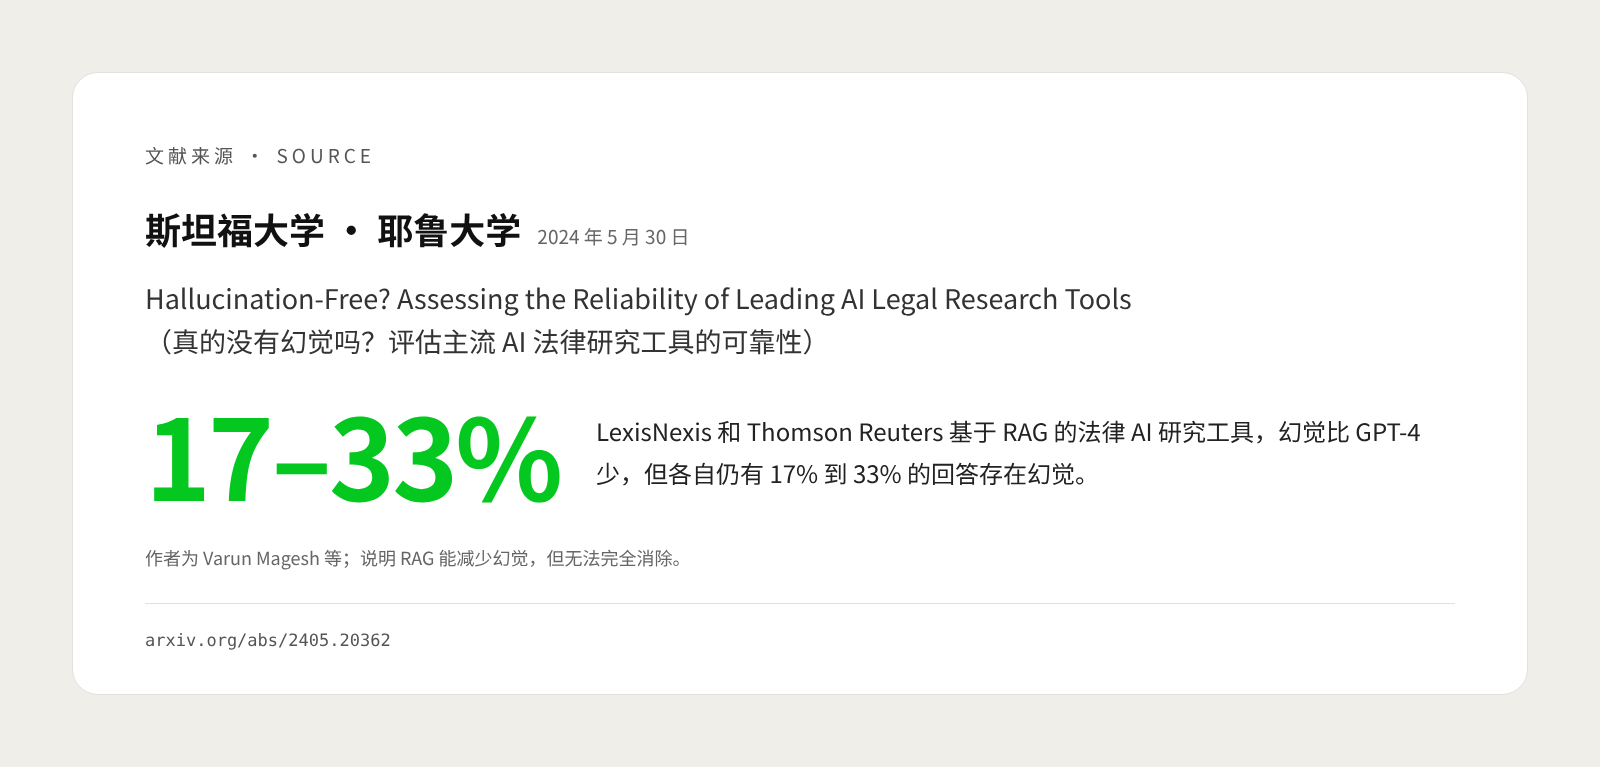
Anche i prodotti dei fornitori specializzati non fanno della RAG una panacea. Nel 2024 ricercatori di Stanford University e Yale University hanno valutato gli strumenti di ricerca legale basati su RAG di LexisNexis e Thomson Reuters, rilevando che producono meno allucinazioni di un chatbot generalista (GPT-4), ma che comunque tra il 17% e il 33% delle risposte contiene allucinazioni (fonte).
Nella pratica aziendale, lo scarso rendimento ha di solito cinque cause:
- Documenti obsoleti, duplicati o in contraddizione tra loro. Nelle cartelle condivise la stessa procedura può esistere contemporaneamente come “versione 2023”, “versione 2024” e “definitiva (2)”. Se il recupero trova una versione vecchia, la risposta è sbagliata, e sbagliata in modo molto convincente.
- Permessi gestiti male. Collegare la knowledge base non significa che tutti possano ottenere con una domanda la tabella delle retribuzioni o i preventivi dei clienti. Nell'edizione 2025 dei dieci principali rischi per le applicazioni basate su modelli linguistici, OWASP ha incluso espressamente le vulnerabilità legate a vettori ed embedding: con controlli di accesso deboli il modello può recuperare e divulgare dati personali o segreti commerciali, e se più gruppi di utenti condividono un unico database vettoriale possono verificarsi fughe di informazioni tra gruppi. OWASP raccomanda di usare sistemi di archiviazione che supportino permessi granulari e di partizionare i dati per livello di accesso (fonte).
- Formati dei documenti caotici. PDF scansionati, tabelle incorporate in immagini, fogli Excel con celle unite, diagrammi di flusso disegnati in PowerPoint: dopo la suddivisione è facile che le informazioni vadano perse.
- La suddivisione ha fatto perdere il contesto. Anthropic fa un esempio: un frammento che dice soltanto “i ricavi dell'azienda sono aumentati del 3% rispetto al trimestre precedente”, senza indicare di quale azienda e di quale trimestre si tratti, è molto difficile da trovare in fase di recupero. Nei propri test Anthropic ha rilevato che aggiungere il contesto a ciascun frammento e combinarlo con la ricerca per parole chiave riduce del 49% i casi di recupero fallito, e del 67% se si aggiunge anche il riordinamento dei risultati (fonte). Sono risultati di test condotti dal fornitore stesso, ma mostrano che la progettazione del metodo di recupero incide in modo sensibile sul risultato.
- Nessuna valutazione. Senza un insieme standard di domande e risposte, dopo aver modificato la suddivisione, cambiato modello o aggiunto documenti, nessuno sa dire se i risultati siano migliorati o peggiorati, e si può giudicare solo in base a impressioni d'uso sparse.
Come realizzare una knowledge base aziendale affidabile? Guida passo dopo passo
Nella realizzazione di una knowledge base aziendale, la scelta tecnologica è spesso la parte più facile. Si parte da uno scenario frequente e con confini documentali chiari, si mettono in ordine i documenti e si definiscono con precisione i permessi, e solo dopo si parla di tecnologia.
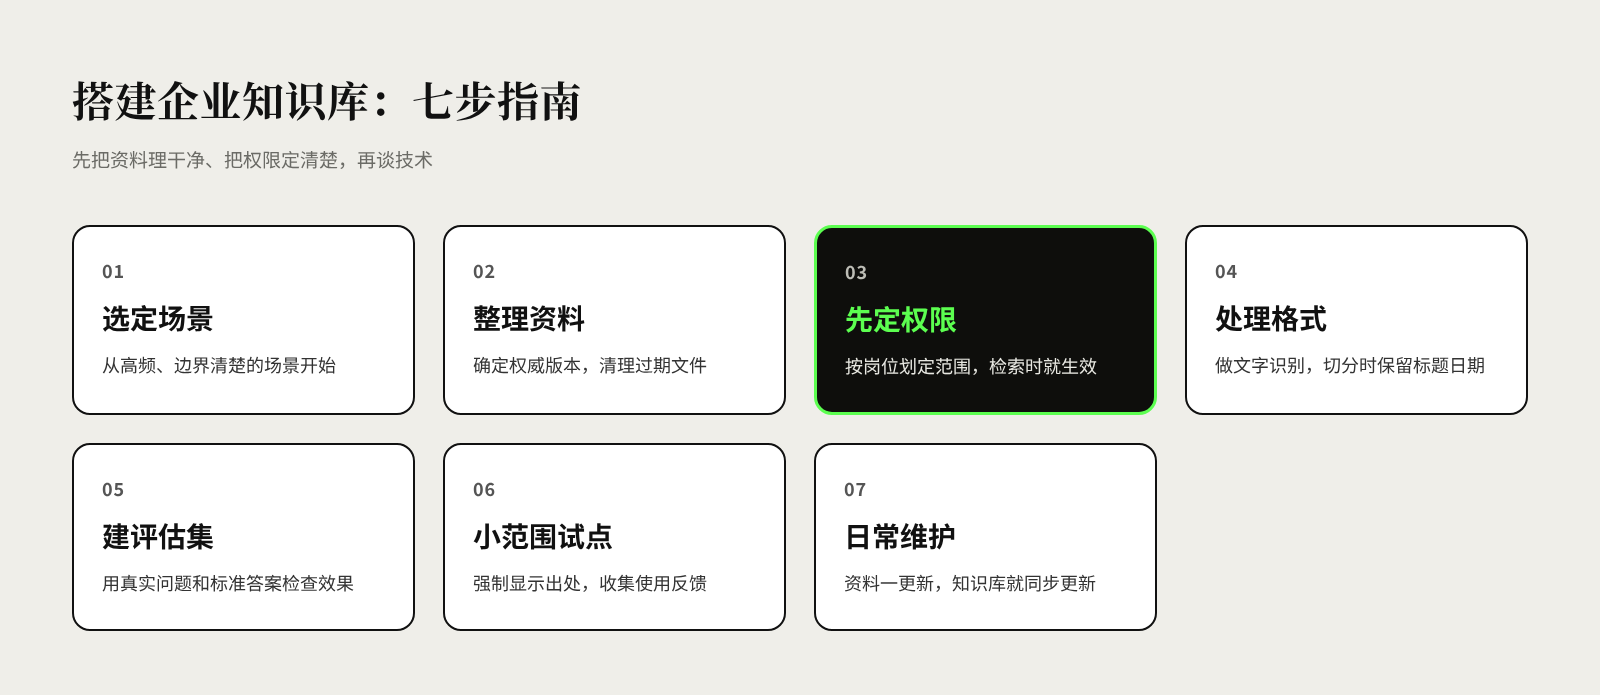
Passo 1: scegliere uno scenario concreto e stabilire chi lo userà. Per esempio “i dipendenti dei punti vendita consultano la policy su resi e cambi” o “il servizio clienti consulta le condizioni di garanzia dei prodotti”, e non fin dall'inizio una “knowledge base di tutta l'azienda”. Più lo scenario è concreto, più chiari sono il perimetro dei documenti e i criteri di successo.
Passo 2: censire e ordinare i documenti. Individuare la versione di riferimento di ogni tipo di documento, eliminare file duplicati e scaduti, assegnare a ciascun documento un responsabile e una cadenza di aggiornamento. È la fase che richiede più lavoro, ma stabilisce il limite massimo della knowledge base.
Passo 3: definire prima le regole sui permessi. Suddividere la visibilità dei documenti per reparto, ruolo, punto vendita o cliente, riutilizzando il più possibile le impostazioni di permessi dei sistemi esistenti. I permessi devono operare in fase di recupero: il sistema recupera solo i documenti che chi pone la domanda ha il diritto di vedere, invece di recuperarli e poi chiedere al modello di “non dirlo”.
Passo 4: trattare i formati e suddividere in modo sensato. Applicare il riconoscimento del testo (OCR) ai documenti scansionati, convertire le tabelle importanti in un formato strutturato; in fase di suddivisione, conservare per ogni frammento informazioni come nome del file, titolo del capitolo e data di entrata in vigore, in modo che i frammenti non perdano il contesto.
Passo 5: creare un set di domande di valutazione. Raccogliere dalla linea operativa un insieme di domande reali e scrivere risposte standard e relative fonti. Dopo ogni modifica, usare lo stesso set per verificare se sono stati trovati i documenti corretti, se la risposta è giusta, se la fonte è precisa e se, quando nei documenti non c'è nulla, il sistema risponde onestamente “non trovato”.
Passo 6: avviare un pilota ristretto, con visualizzazione obbligatoria delle fonti. Far usare il sistema prima a un team o a pochi punti vendita, mostrando la fonte di ogni risposta e prevedendo un pulsante di feedback “utile / non utile”. Esaminare periodicamente le domande senza risposta o con risposta errata e, in base a queste, integrare o correggere i documenti.
Passo 7: trasformare la manutenzione in un processo quotidiano. Non appena procedure e documentazione di prodotto vengono aggiornate, anche la knowledge base deve essere aggiornata. Anche Gartner sottolinea che i dati pronti per l'IA non sono un lavoro da “fare una volta per tutte” (fonte). Si può inserire la “sincronizzazione della knowledge base” nelle checklist di pubblicazione delle procedure e di lancio dei nuovi prodotti.
Domande frequenti su knowledge base aziendale e RAG
Affidare i documenti aziendali all'IA è sicuro per i dati? Dipende dalla modalità di distribuzione e dalle condizioni del fornitore. In fase di scelta occorre almeno verificare quattro aspetti: dove sono archiviati i dati, se verranno usati per addestrare i modelli, per quanto tempo vengono conservati, chi può accedervi. Per i documenti altamente sensibili si può valutare un'installazione on-premise, o definire nel contratto in modo esplicito l'ambito di utilizzo dei dati.
I dipendenti possono vedere attraverso la knowledge base documenti che non dovrebbero vedere? Se non è stato impostato il controllo dei permessi, è possibile. L'approccio corretto è filtrare in fase di recupero in base ai permessi di chi pone la domanda, passando al modello solo i frammenti che ha il diritto di vedere. Non ci si può aspettare che sia il modello a stabilire da solo chi deve vedere cosa.
Bisogna per forza costruirla in proprio? Non necessariamente. Molti software per ufficio e sistemi di assistenza clienti hanno già funzioni integrate di domande e risposte sulla knowledge base: con pochi documenti e scenari standard si può cominciare con un prodotto già pronto per verificarne i risultati; quando occorre collegare più sistemi interni, i permessi sono complessi o c'è un requisito di installazione on-premise, si valuta una soluzione su misura o sviluppata internamente. In ogni caso, l'ordinamento dei documenti e la valutazione dei risultati non si possono saltare.
Con la RAG l'IA non inventa più? No. La RAG riduce sensibilmente le allucinazioni, ma non le elimina del tutto, come dimostra la valutazione degli strumenti legali citata sopra. Occorre richiedere che ogni risposta riporti la fonte e mantenere la revisione umana per le domande ad alto rischio, come quelle su contratti e finanza.
Riferimenti
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis et al. (Facebook AI Research, University College London, New York University), NeurIPS 2020, maggio 2020
- Why language models hallucinate, OpenAI, settembre 2025
- 2024: The State of Generative AI in the Enterprise, Menlo Ventures, novembre 2024
- Introducing Contextual Retrieval, Anthropic, settembre 2024
- Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu et al., Transactions of the Association for Computational Linguistics, luglio 2023
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, febbraio 2025
- Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Varun Magesh et al. (Stanford University, Yale University), maggio 2024
- LLM08:2025 Vector and Embedding Weaknesses, OWASP, 2025


