Beaucoup d'entreprises qui testent un grand modèle généraliste rencontrent le même problème : il rédige des e-mails et des synthèses, mais dès qu'on l'interroge sur la politique de remboursement des frais de l'entreprise, sur les conditions de garantie d'un modèle précis ou sur les modalités de paiement d'un contrat client, il ne sait pas répondre, ou invente une réponse qui a l'air parfaitement vraie. La raison n'a rien de compliqué : ces documents n'ont jamais fait partie des données d'entraînement du modèle. Pour que l'IA comprenne réellement les documents internes de l'entreprise, l'essentiel n'est pas de changer pour un modèle plus puissant, mais de lui faire trouver les bons documents avant de répondre, et d'indiquer clairement d'où vient la réponse.
C'est précisément le problème que la génération augmentée par la récupération (RAG) cherche à résoudre. Cet article présente pourquoi un grand modèle généraliste ne connaît pas votre entreprise, comment fonctionne le RAG, en quoi il diffère du fine-tuning et du contexte long, et quelles sont les causes fréquentes d'une base de connaissances peu efficace, puis propose un guide de mise en place pas à pas et une foire aux questions.
Pourquoi un grand modèle généraliste ne connaît-il pas votre entreprise, et pourquoi répond-il avec aplomb des choses fausses ?
Les connaissances d'un grand modèle généraliste proviennent des données publiques utilisées à l'entraînement, et elles s'arrêtent au moment où l'entraînement s'achève. Il n'a jamais vu vos règlements internes, vos manuels produit ni vos contrats clients, mais, lorsqu'on l'interroge, il donne le plus souvent une réponse quand même.
Cette façon de « se tromper avec assurance » s'appelle l'hallucination. Dans son article de recherche « Why language models hallucinate », publié en septembre 2025, OpenAI définit l'hallucination comme des « affirmations plausibles mais fausses » générées par le modèle, et avance une cause importante : les méthodes courantes d'entraînement et d'évaluation ne regardent que le taux de bonnes réponses ; deviner juste rapporte des points, répondre « je ne sais pas » vaut zéro, de sorte que le modèle est entraîné à préférer la conjecture à l'aveu d'incertitude (source). L'article ajoute que, pour les connaissances qui obéissent à des régularités, comme l'orthographe ou la grammaire, les modèles gagnent en fiabilité avec la taille ; mais des faits rares et sans régularité, comme la date de naissance d'une personne, ne peuvent pas être déduits de motifs. Les clauses des règlements internes, les politiques tarifaires et les accords conclus avec les clients appartiennent précisément à cette catégorie.
Par exemple, si un employé demande « quel est le plafond de remboursement par nuit d'hôtel en déplacement ? », un modèle généraliste peut donner un montant plausible fondé sur les pratiques courantes. Si ce montant ne correspond pas au règlement de l'entreprise et que l'employé demande son remboursement sur cette base, les conséquences sont plus gênantes qu'une absence de réponse.
En résumé, les grands modèles généralistes présentent trois lacunes congénitales dans le contexte de l'entreprise :
- Ils ne voient pas les documents internes. Les règlements, la documentation produit, les historiques de tickets et les contrats de l'entreprise ne figurent dans aucune donnée d'entraînement publique.
- Leurs connaissances ont une date limite. Après un ajustement de la grille tarifaire ou une mise à jour d'une politique, le modèle ne le sait pas et peut continuer à répondre selon l'ancienne situation.
- Ils ne peuvent pas justifier leurs réponses. Une réponse sans source ne permet ni à l'employé de vérifier, ni au responsable de juger s'il faut s'y fier.
Qu'est-ce que la génération augmentée par la récupération (RAG), et comment fonctionne-t-elle ?
Le principe du RAG (Retrieval-Augmented Generation) se résume ainsi : « consulter les documents, puis répondre ». Le modèle n'a pas besoin d'« apprendre par cœur » les documents de l'entreprise ; il lui suffit de trouver les passages pertinents avant de répondre et de s'appuyer sur eux.
Ce concept vient d'un article de 2020. Patrick Lewis et ses collègues, de Facebook AI Research, de University College London et de New York University, ont proposé le RAG dans « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks », publié à NeurIPS 2020. Ils appellent « mémoire paramétrique » les connaissances stockées dans les paramètres du modèle, et « mémoire non paramétrique » la base de documents externe que l'on peut interroger à tout moment (Wikipédia dans leurs expériences), et soulignent qu'avec la première seule, il est difficile pour le modèle d'expliquer l'origine d'une réponse comme de mettre ses connaissances à jour (source). Ce sont précisément les deux points qui comptent le plus pour les entreprises.
En termes non techniques, un système de questions-réponses sur base de connaissances d'entreprise comprend généralement quatre étapes :
- Découpage des documents. Les règlements, manuels produit, contrats, etc. sont divisés en courts fragments (chunks), chacun étant indexé pour pouvoir être retrouvé ensuite selon son contenu.
- Recherche. Après la question de l'employé, le système trouve d'abord dans l'index les quelques fragments les plus proches de la question. La pratique courante combine la recherche « par le sens » (recherche vectorielle) et la recherche « par mots-clés ». Anthropic souligne que la recherche par mots-clés est particulièrement utile pour les chaînes qui doivent correspondre exactement, comme les références de produits ou les codes d'erreur (source).
- Réponse à partir des documents. Le système transmet au grand modèle les fragments trouvés avec la question, en lui demandant de ne répondre qu'à partir de ces documents ; ce qui n'y figure pas appelle une réponse explicite : « Aucune disposition correspondante n'a été trouvée ».
- Citation des sources. La réponse est accompagnée du fichier source, de la section ou de la page, que l'employé peut ouvrir d'un clic pour vérifier le texte d'origine.
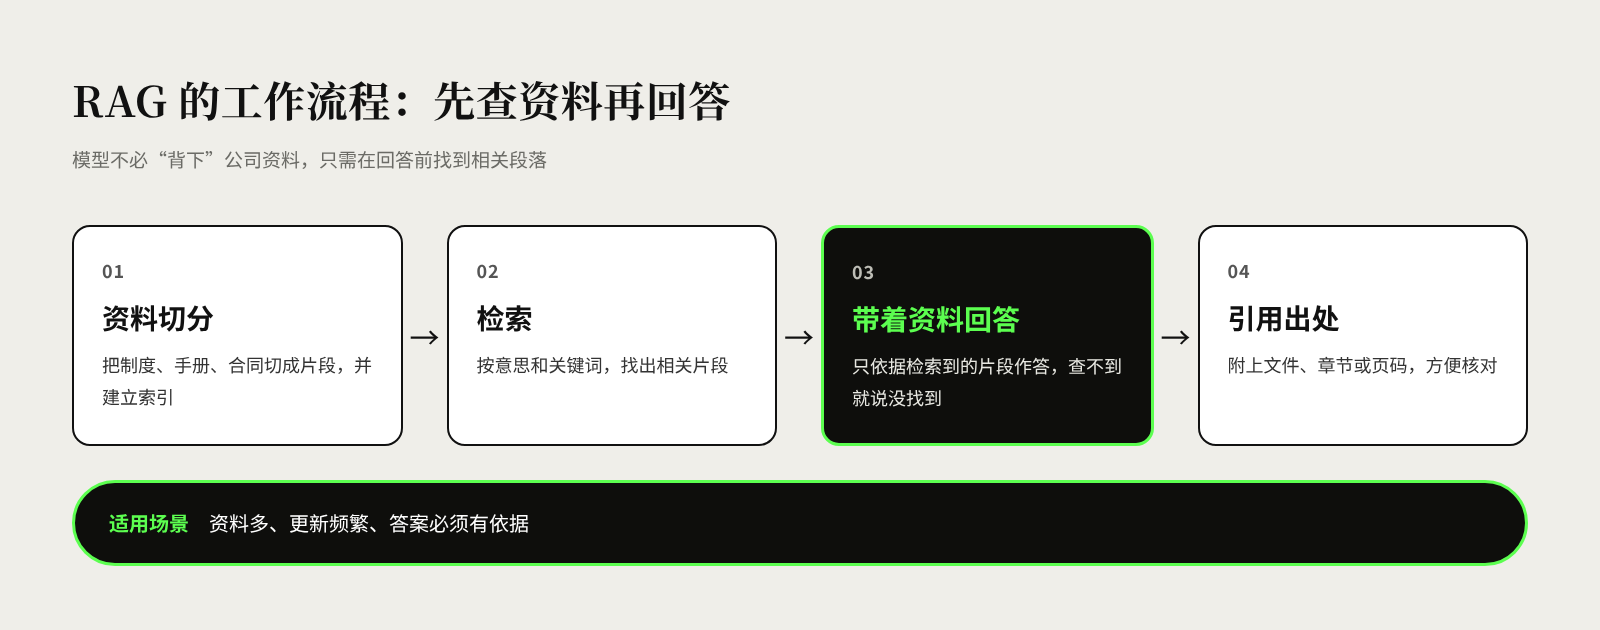
Par exemple, un agent du service client demande « quelle est la durée de garantie du moteur de tel modèle ? » : le système trouve d'abord les clauses pertinentes dans la documentation produit et la politique de garantie, puis génère la réponse en indiquant l'article précis de la « Politique de garantie » dont elle provient. L'agent n'a pas à fouiller tout le disque partagé pour expliquer au client sur quoi il s'appuie.
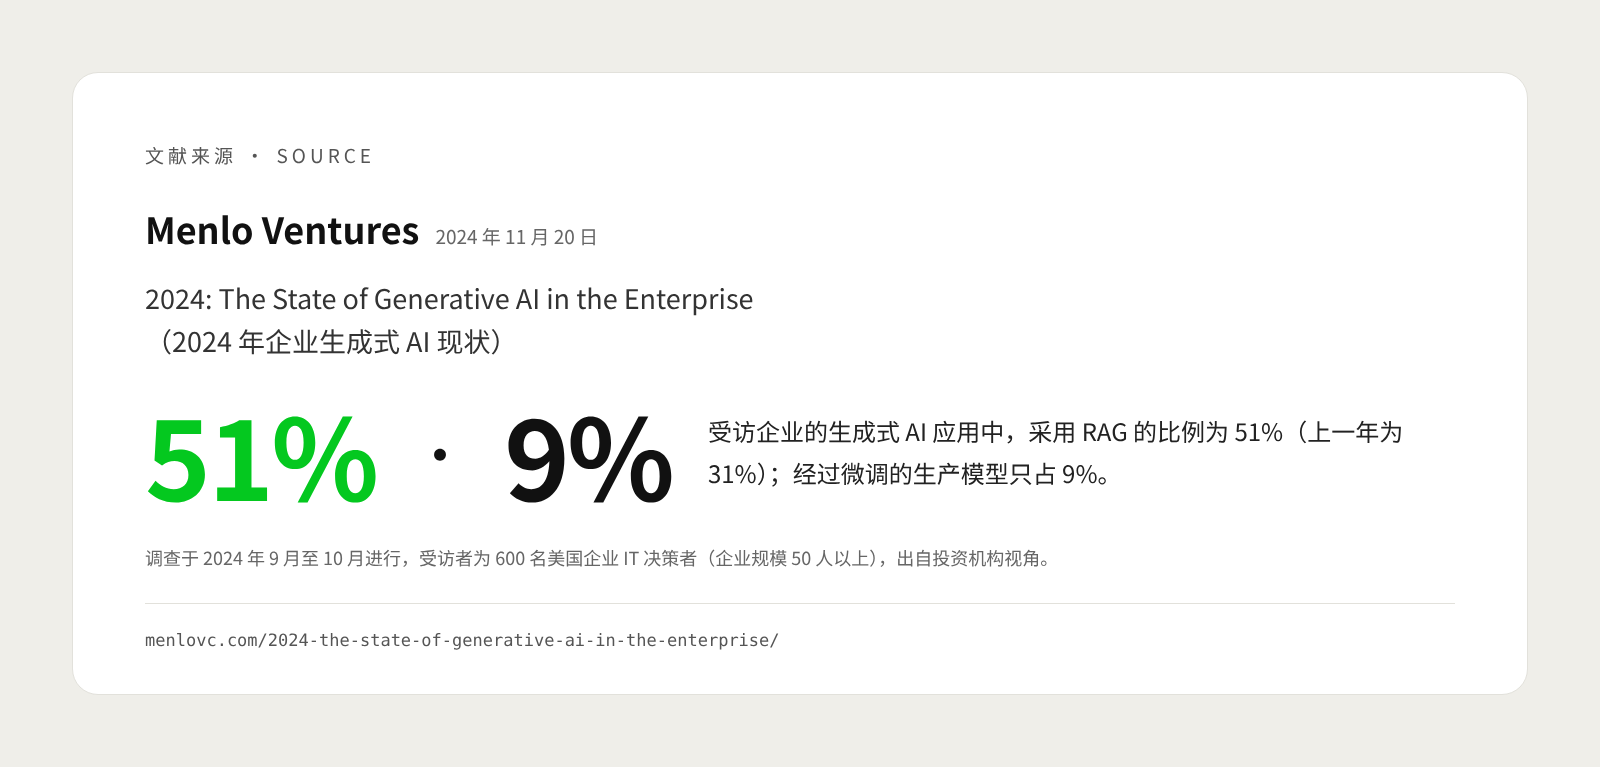
Cette approche est déjà largement répandue en entreprise. La société d'investissement Menlo Ventures a interrogé, de septembre à octobre 2024, 600 décideurs informatiques d'entreprises américaines (de 50 salariés ou plus) : parmi les applications d'IA générative des entreprises interrogées, la part de celles utilisant le RAG était de 51 %, contre 31 % l'année précédente, tandis que les modèles de production fine-tunés ne représentaient que 9 % (source). Il faut noter que cette enquête ne couvre que des entreprises américaines et qu'elle est menée du point de vue d'un investisseur.
En entreprise, le RAG a le plus souvent quatre usages :
- Questions-réponses sur les règlements internes. Barèmes de remboursement, procédures de congés, niveaux d'autorisation des achats, etc. Les nouveaux employés n'ont plus à solliciter sans cesse les RH et la finance, et les réponses sont plus homogènes.
- Consultation de la documentation produit. Les commerciaux et le service client retrouvent rapidement les caractéristiques techniques, les modèles compatibles et les politiques tarifaires. Par exemple, le commercial d'un grossiste cherche chez le client la référence de remplacement d'un SKU.
- Base de connaissances après-vente. On y intègre les guides de dépannage, l'historique des tickets et les relevés de réparation ; le service client ou les techniciens de maintenance peuvent rechercher, à partir d'un symptôme, des cas similaires et les solutions appliquées.
- Recherche dans les contrats. Les juristes et les acheteurs y cherchent les conditions de paiement, les responsabilités en cas de manquement, les clauses de renouvellement, ou comparent les contrats de différents fournisseurs. Ces scénarios sont à risque élevé, et les réponses doivent être revues par un humain.
Leur point commun : beaucoup de documents, des mises à jour fréquentes, des réponses qui doivent être justifiées. C'est aussi un critère simple pour juger si un cas d'usage se prête au RAG.
Quelles différences entre RAG, fine-tuning et contexte long ?
Il existe trois approches courantes pour faire utiliser les documents de l'entreprise par un modèle : le RAG, le fine-tuning et le contexte long. Pour la plupart des besoins du type « consulter des documents et répondre à des questions », le RAG est le point de départ le plus sûr ; le fine-tuning convient mieux pour apprendre au modèle des formats et des formulations fixes que pour lui inculquer des faits.
Le fine-tuning (affinage) consiste à poursuivre l'entraînement du modèle avec les propres exemples de l'entreprise ; le contexte long (long context) consiste à placer directement l'intégralité des documents dans le prompt du modèle pour qu'il les lise d'un bloc. Les différences entre les trois sont les suivantes :
| Critère | RAG (génération augmentée par la récupération) | Fine-tuning | Contexte long |
|---|---|---|---|
| Principe | Rechercher les fragments pertinents avant de répondre | Réentraîner le modèle avec des données d'exemples | Placer en une fois l'ensemble des documents dans le prompt |
| Besoins adaptés | Beaucoup de documents, mises à jour fréquentes, sources nécessaires | Format fixe, ton, terminologie métier, tâches de classification | Faible volume de documents, ou analyse ponctuelle d'un long document |
| Mise à jour des documents | Il suffit de mettre à jour les documents et l'index | Nécessite souvent un nouvel entraînement | À replacer à chaque appel |
| Citation des sources | Facile à mettre en œuvre | Très difficile | Possible, mais à encadrer par le prompt |
| Contrôle des droits d'accès | Filtrage possible à la recherche selon la personne qui interroge | Très difficile, les connaissances étant déjà mêlées aux paramètres du modèle | Tri manuel nécessaire avant le placement |
| Principaux coûts | Préparation des documents, construction et maintenance de l'indexation et de la recherche | Préparation des données, entraînement et évaluations répétées | Coût et temps d'attente liés au traitement de gros volumes de texte à chaque fois |
| Principales limites | Si la recherche échoue, la réponse sera mauvaise | Hallucinations toujours possibles, difficile de supprimer une connaissance précise | Volume trop important pour tenir, informations au milieu d'un long texte facilement ignorées |
Cette comparaison vaut pour le cas général ; le choix précis dépend aussi du volume de documents et de la fréquence d'utilisation.
Lorsque le volume de documents est modeste, le contexte long est une solution simple à envisager. Dans un article technique de septembre 2024, Anthropic recommande, si la base de connaissances fait moins d'environ 200 000 tokens (le token est l'unité de base de traitement du texte par le modèle ; cette taille équivaut à environ 500 pages), de placer tout le contenu directement dans le prompt, sans construire de RAG ; ce n'est que pour une base plus grande qu'une solution plus évolutive devient nécessaire (source).
Mais « tenir dans le contexte » ne veut pas dire « être lu avec attention ». Dans l'article « Lost in the Middle », des chercheurs de l'université Stanford et d'autres institutions ont constaté que le modèle donne ses meilleurs résultats lorsque l'information clé se trouve au début ou à la fin d'un texte long, et que ses performances baissent nettement lorsqu'elle se situe au milieu, y compris pour des modèles conçus spécialement pour les contextes longs (source). En pratique, les trois méthodes sont donc souvent combinées. Par exemple, on utilise d'abord le RAG pour trouver le contrat concerné par la question, puis on place ce contrat en entier dans le contexte pour le lire clause par clause.
Pourquoi tant de bases de connaissances d'entreprise donnent-elles de mauvais résultats ?
Quand une base de connaissances répond mal, le problème vient le plus souvent non du modèle, mais des documents et de leur gestion. Le RAG ne fait qu'amplifier la qualité des documents eux-mêmes : si les documents sont en désordre, les réponses ne seront pas fiables.
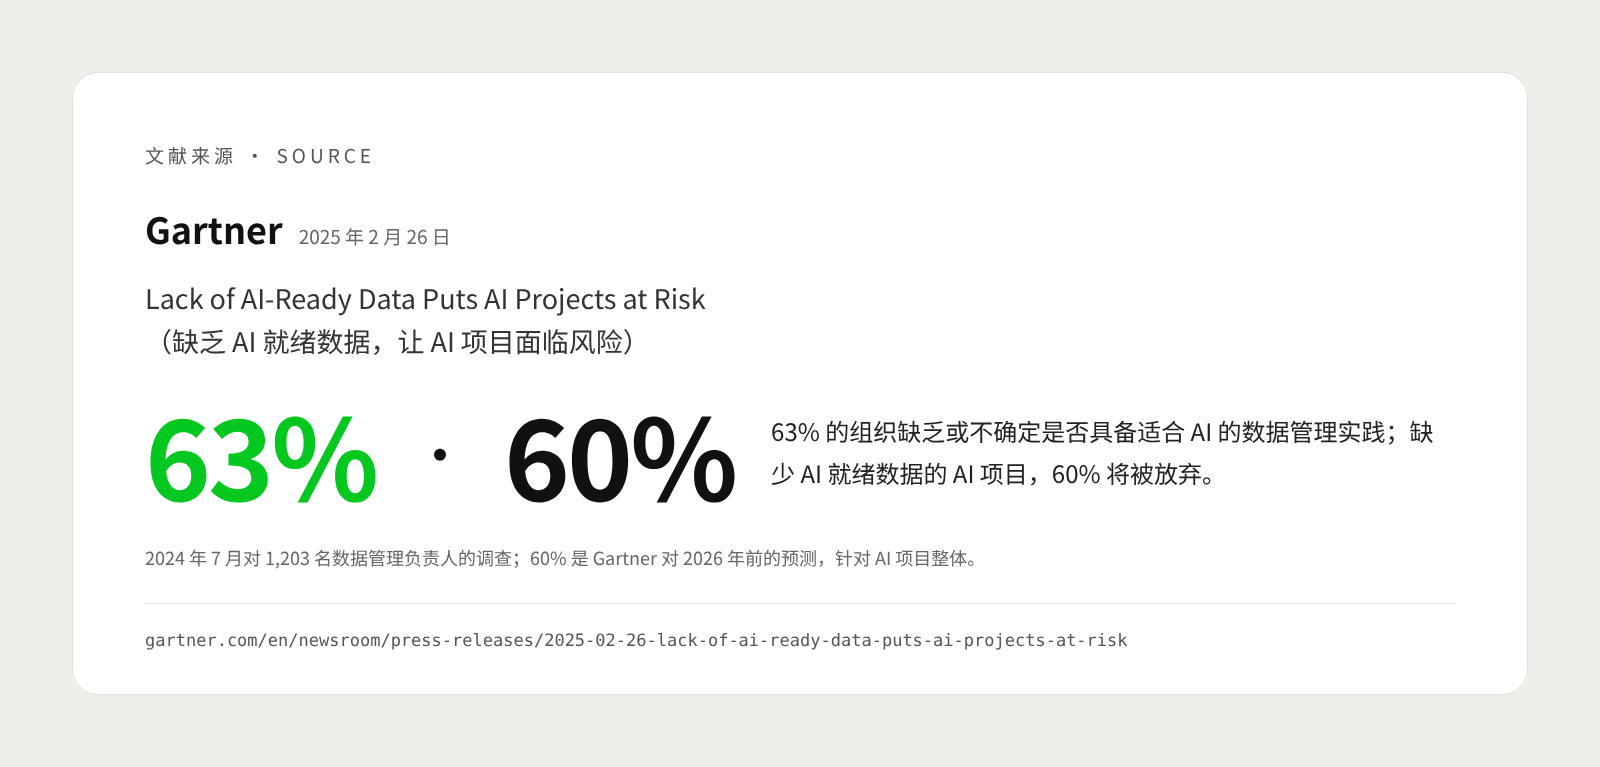
En juillet 2024, Gartner a interrogé 1 203 responsables de la gestion des données : 63 % des organisations déclarent ne pas disposer de pratiques de gestion des données adaptées à l'IA, ou ne pas savoir si elles en disposent ; Gartner en déduit que, d'ici 2026, 60 % des projets d'IA dépourvus de données « prêtes pour l'IA » seront abandonnés (source). Cette enquête porte sur l'ensemble des projets d'IA, mais elle s'applique tout autant aux bases de connaissances.
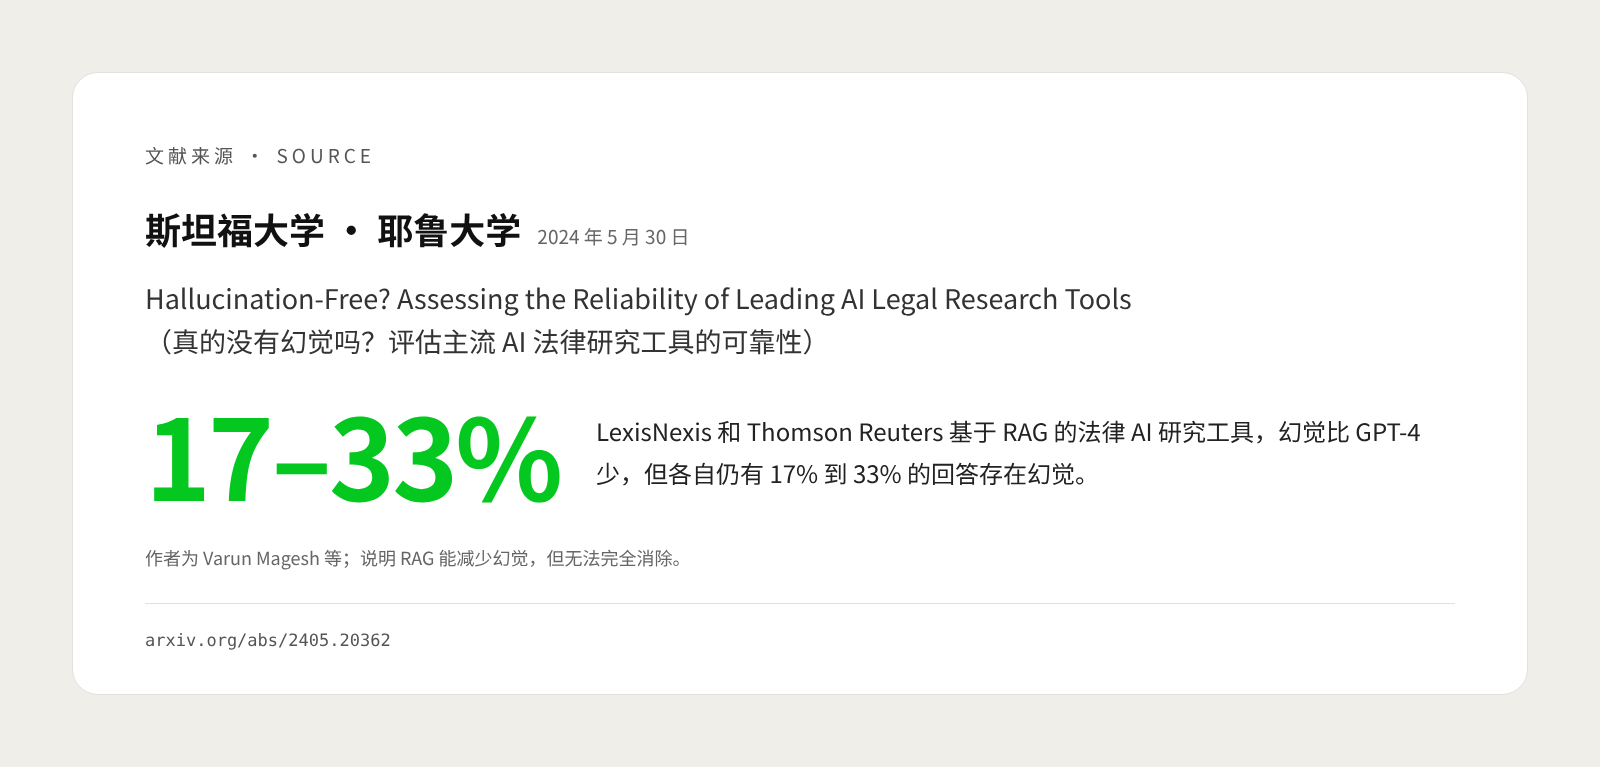
Même les produits d'éditeurs spécialisés ne doivent pas faire considérer le RAG comme une panacée. En 2024, des chercheurs des universités Stanford et Yale ont évalué les outils de recherche juridique par IA de LexisNexis et de Thomson Reuters, fondés sur le RAG : ils hallucinent moins que les chatbots généralistes (GPT-4), mais entre 17 % et 33 % de leurs réponses comportent encore des hallucinations (source).
Dans la pratique des entreprises, les mauvais résultats tiennent généralement à ces cinq causes :
- Des documents obsolètes, en double ou contradictoires. Sur le disque partagé, un même règlement peut exister à la fois en « version 2023 », en « version 2024 » et en « version finale (2) ». Si la recherche renvoie une ancienne version, la réponse sera fausse, et fausse de façon très convaincante.
- Des droits d'accès mal traités. Connecter une base de connaissances ne signifie pas que tout le monde peut en tirer la grille des salaires ou les devis clients. Dans son Top 10 2025 des risques des applications de grands modèles, l'OWASP consacre une entrée aux faiblesses liées aux vecteurs et aux embeddings : lorsque le contrôle d'accès est faible, le modèle peut retrouver et divulguer des informations personnelles ou des secrets d'affaires ; quand plusieurs groupes d'utilisateurs partagent une même base vectorielle, des fuites d'information d'un groupe à l'autre sont également possibles. L'OWASP recommande un stockage prenant en charge des droits fins et un partitionnement des données selon le niveau d'accès (source).
- Des formats de documents désordonnés. PDF numérisés, tableaux intégrés dans des images, fichiers Excel aux cellules fusionnées, organigrammes dessinés dans PowerPoint : après découpage, l'information se perd facilement.
- Un découpage qui fait perdre le contexte. Anthropic donne cet exemple : un fragment qui dit seulement « le chiffre d'affaires de l'entreprise a augmenté de 3 % par rapport au trimestre précédent », sans préciser de quelle entreprise ni de quel trimestre, sera difficile à retrouver lors de la recherche. Dans ses propres tests, elle a constaté qu'ajouter un contexte à chaque fragment et le combiner à la recherche par mots-clés réduit le taux d'échec de la recherche de 49 %, et de 67 % avec en plus un reclassement (source). Ce sont les résultats de tests de l'éditeur lui-même, mais ils montrent que la conception de la méthode de recherche influe sensiblement sur les résultats.
- L'absence d'évaluation. Sans un jeu de questions et de réponses de référence, après avoir modifié le découpage, changé de modèle ou ajouté des documents, personne ne peut dire si les résultats se sont améliorés ou dégradés, et l'on juge sur des impressions d'utilisation éparses.
Comment construire une base de connaissances d'entreprise fiable ? Guide pas à pas
Pour construire une base de connaissances d'entreprise, le choix technique est souvent la partie la plus facile. Commencez par un cas d'usage fréquent, aux documents clairement délimités ; mettez d'abord de l'ordre dans les documents et définissez clairement les droits d'accès, puis parlez technique.
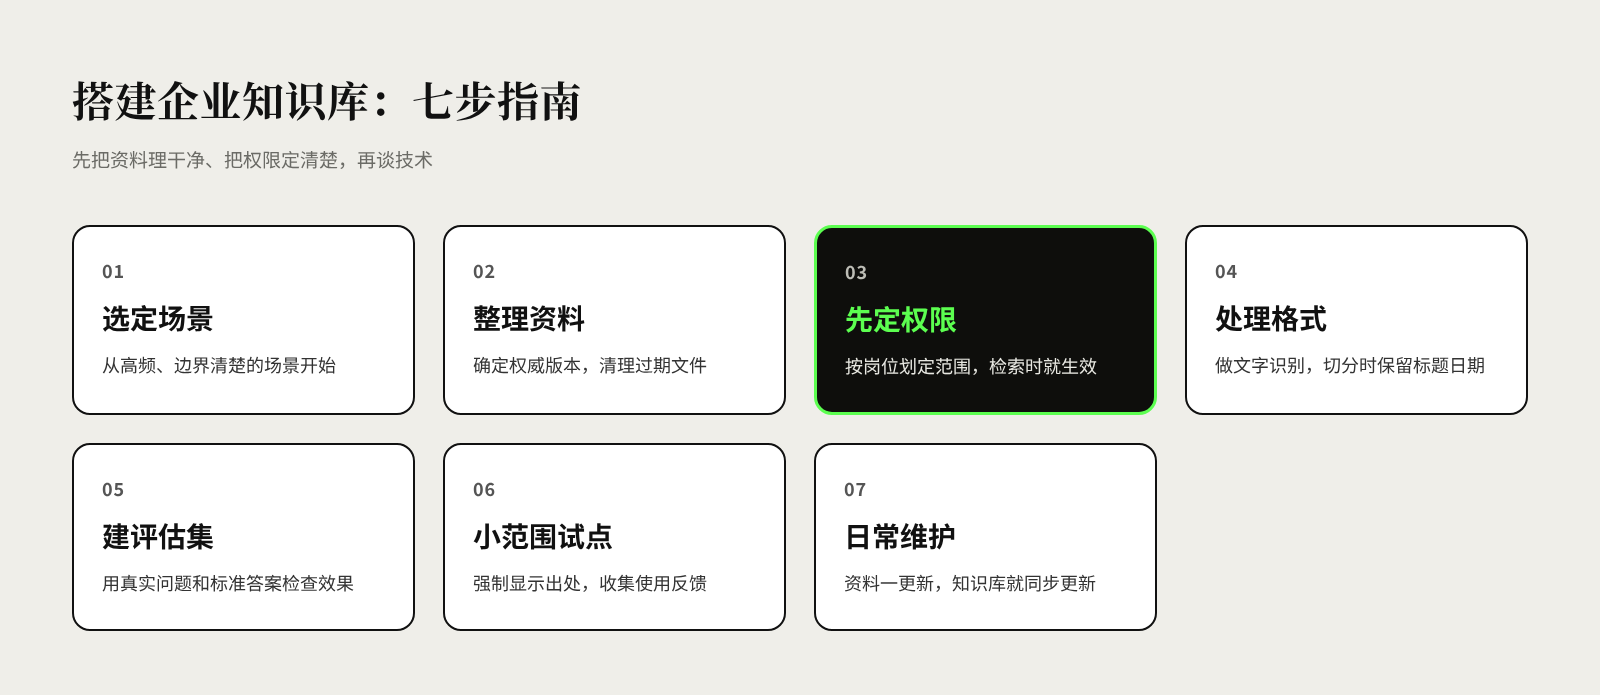
Étape 1 : choisir un cas d'usage précis et définir qui l'utilisera. Par exemple « les employés en magasin consultent la politique de retours et d'échanges » ou « le service client consulte les conditions de garantie des produits », plutôt qu'une « base de connaissances pour toute l'entreprise » dès le départ. Plus le cas d'usage est précis, plus le périmètre documentaire et les critères de réussite sont clairs.
Étape 2 : recenser et organiser les documents. Identifiez la version de référence de chaque type de document, supprimez les doublons et les fichiers périmés, et désignez pour chaque document un responsable et une périodicité de mise à jour. C'est l'étape la plus lourde, mais c'est elle qui détermine le plafond de la base de connaissances.
Étape 3 : définir d'abord les règles de droits d'accès. Répartissez la visibilité des documents par service, poste, magasin ou client, en reprenant autant que possible les paramètres de droits des systèmes existants. Les droits doivent s'appliquer au moment de la recherche : le système ne recherche que dans les documents que la personne qui interroge a le droit de consulter, et non dans tout, en demandant ensuite au modèle de « ne pas le dire ».
Étape 4 : traiter les formats et découper judicieusement. Appliquez la reconnaissance de texte aux documents numérisés, convertissez les tableaux importants en formats structurés ; au découpage, conservez pour chaque fragment des informations comme le nom du fichier, le titre de la section et la date d'entrée en vigueur, afin que les fragments ne soient pas coupés de leur contexte.
Étape 5 : constituer un jeu de questions d'évaluation. Collectez sur le terrain un ensemble de vraies questions, rédigez les réponses de référence et les sources correspondantes. Après chaque ajustement, contrôlez avec le même jeu de questions : les bons documents ont-ils été trouvés, la réponse est-elle correcte, la source est-elle exacte, le système répond-il honnêtement « rien trouvé » lorsque les documents ne contiennent pas la réponse ?
Étape 6 : lancer un pilote restreint en imposant l'affichage des sources. Commencez avec une équipe ou quelques magasins, affichez la source de chaque réponse et proposez un bouton de retour « utile / pas utile ». Examinez régulièrement les questions restées sans réponse ou mal traitées, et complétez ou corrigez les documents en conséquence.
Étape 7 : faire de la maintenance un processus quotidien. Dès qu'un règlement ou un document produit est mis à jour, la base de connaissances doit l'être aussi. Gartner souligne également que des données prêtes pour l'IA ne relèvent pas d'un travail « fait une fois pour toutes » (source). Vous pouvez inscrire la « synchronisation de la base de connaissances » dans la liste de contrôle des processus de publication des règlements et de lancement des produits.
Foire aux questions sur la base de connaissances d'entreprise et le RAG
Confier les documents de l'entreprise à l'IA, est-ce sûr ? Cela dépend du mode de déploiement et des conditions du fournisseur. Lors du choix, il faut au minimum vérifier quatre points : où les données sont stockées, si elles seront utilisées pour entraîner le modèle, combien de temps elles sont conservées, et qui peut y accéder. Pour les documents très sensibles, on peut envisager un déploiement privé, ou définir contractuellement le périmètre d'utilisation des données.
Les employés peuvent-ils voir, via la base de connaissances, des documents qu'ils ne devraient pas voir ? Sans contrôle des droits d'accès, c'est effectivement possible. La bonne pratique consiste à filtrer à la recherche selon les droits de la personne qui interroge, et à ne transmettre au modèle que les fragments qu'elle a le droit de consulter. On ne peut pas attendre du modèle qu'il juge lui-même qui doit voir quoi.
Faut-il forcément la construire soi-même ? Pas nécessairement. De nombreux logiciels bureautiques et systèmes de service client intègrent déjà des fonctions de questions-réponses sur base de connaissances ; quand le volume de documents est modeste et le cas d'usage standard, on peut d'abord valider les résultats avec un produit existant ; lorsqu'il faut se connecter à plusieurs systèmes internes, que les droits d'accès sont complexes ou qu'un déploiement privé est exigé, on envisage alors un développement sur mesure ou en interne. Dans tous les cas, l'organisation des documents et l'évaluation des résultats sont incontournables.
Avec le RAG, l'IA ne dira-t-elle plus n'importe quoi ? Non. Le RAG réduit nettement les hallucinations, mais ne peut pas les éliminer complètement, comme l'illustre l'évaluation des outils juridiques évoquée plus haut. Il faut exiger que chaque réponse soit accompagnée de sa source, et maintenir une relecture humaine pour les questions à risque élevé comme les contrats et la finance.
Références
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis et al. (Facebook AI Research, University College London, New York University), NeurIPS 2020, mai 2020
- Why language models hallucinate, OpenAI, septembre 2025
- 2024: The State of Generative AI in the Enterprise, Menlo Ventures, novembre 2024
- Introducing Contextual Retrieval, Anthropic, septembre 2024
- Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu et al., Transactions of the Association for Computational Linguistics, juillet 2023
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, février 2025
- Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Varun Magesh et al. (Stanford University, Yale University), mai 2024
- LLM08:2025 Vector and Embedding Weaknesses, OWASP, 2025


