Viele Unternehmen stoßen beim Testen allgemeiner Sprachmodelle auf dasselbe Problem: Das Modell schreibt E-Mails und fasst Texte zusammen, doch sobald es nach der unternehmenseigenen Reisekostenrichtlinie, den Garantiebedingungen eines bestimmten Modells oder den Zahlungsbedingungen eines Kundenvertrags gefragt wird, kann es entweder nicht antworten oder erfindet eine Antwort, die täuschend echt klingt. Der Grund ist einfach: Diese Unterlagen waren nie Teil der Trainingsdaten des Modells. Damit KI die internen Unternehmensunterlagen wirklich versteht, kommt es nicht auf ein noch leistungsstärkeres Modell an, sondern darauf, dass es vor der Antwort die richtigen Unterlagen findet und klar benennt, woher die Antwort stammt.
Genau dieses Problem löst Retrieval-Augmented Generation (RAG). Dieser Beitrag erläutert, warum allgemeine Sprachmodelle Ihr Unternehmen nicht kennen, wie RAG funktioniert, worin es sich von Fine-Tuning und langem Kontext unterscheidet und woran es liegt, dass Unternehmenswissensdatenbanken oft schlecht funktionieren. Dazu gibt es eine Schritt-für-Schritt-Anleitung für den Aufbau und Antworten auf häufige Fragen.
Warum kennen allgemeine Sprachmodelle Ihr Unternehmen nicht – und erzählen trotzdem mit ernster Miene Unsinn?
Das Wissen allgemeiner Sprachmodelle stammt aus öffentlichen Daten, die beim Training verwendet wurden, und bleibt auf dem Stand des Trainingsabschlusses stehen. Ihre internen Richtlinien, Produkthandbücher und Kundenverträge hat das Modell nie gesehen, dennoch liefert es auf Nachfrage häufig trotzdem eine Antwort.
Dieses „selbstbewusste Falschantworten“ nennt man Halluzination (Hallucination). In seinem im September 2025 veröffentlichten Forschungsbeitrag „Why language models hallucinate“ definiert OpenAI Halluzinationen als „plausibel klingende, aber falsche Aussagen“ des Modells und nennt einen wichtigen Grund: Gängige Trainings- und Bewertungsverfahren messen nur die Trefferquote – wer richtig rät, erhält Punkte, wer „Ich weiß es nicht“ antwortet, erhält null. So lernt das Modell, eher zu raten, als Unsicherheit einzuräumen (Quelle). Der Beitrag weist außerdem darauf hin, dass Wissen mit Regelmäßigkeiten wie Rechtschreibung und Grammatik mit wachsender Modellgröße immer zuverlässiger wird, seltene Fakten ohne erkennbares Muster, etwa der Geburtstag einer bestimmten Person, sich aus Mustern jedoch nicht ableiten lassen. Interne Richtlinienklauseln, Preispolitik und Kundenvereinbarungen gehören genau zu dieser Kategorie.
Fragt etwa ein Mitarbeiter: „Wie hoch ist die Erstattungsobergrenze für eine Hotelübernachtung auf Dienstreisen?“, nennt ein allgemeines Modell womöglich einen nach üblicher Praxis plausibel klingenden Betrag. Weicht dieser von der Unternehmensrichtlinie ab und rechnet der Mitarbeiter danach ab, sind die Folgen unangenehmer als eine fehlende Antwort.
Zusammengefasst haben allgemeine Sprachmodelle im Unternehmenseinsatz drei systembedingte Lücken:
- Sie sehen keine internen Unterlagen. Richtlinien, Produktunterlagen, Ticketverläufe und Verträge des Unternehmens sind in keinen öffentlichen Trainingsdaten enthalten.
- Ihr Wissen hat ein Stichtagsdatum. Nach einer Preislistenanpassung oder Richtlinienänderung weiß das Modell nichts davon und antwortet möglicherweise weiter nach altem Stand.
- Sie können ihre Grundlage nicht benennen. Antworten haben keine Quelle, Mitarbeitende können sie nicht nachprüfen, und Führungskräfte können nicht beurteilen, ob sie ihnen trauen sollen.
Was ist Retrieval-Augmented Generation (RAG)? Wie funktioniert es?
Der Ansatz von RAG (Retrieval-Augmented Generation, retrieval-gestützte Generierung) lässt sich als „erst nachschlagen, dann antworten“ zusammenfassen. Das Modell muss die Unternehmensunterlagen nicht „auswendig lernen“, es muss vor der Antwort nur die relevanten Passagen finden und auf deren Grundlage antworten.
Das Konzept stammt aus einer Arbeit von 2020. Forschende von Facebook AI Research, dem University College London und der New York University, darunter Patrick Lewis, stellten RAG in der Arbeit „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“ vor, die auf der NeurIPS 2020 erschien. Das in den Modellparametern gespeicherte Wissen nennen sie „parametrisches Gedächtnis“, die jederzeit abfragbare externe Dokumentensammlung (im Experiment Wikipedia) „nichtparametrisches Gedächtnis“. Sie weisen darauf hin, dass ein Modell allein mit Ersterem kaum erklären kann, woher eine Antwort stammt, und sein Wissen auch nur schwer aktualisieren kann (Quelle). Genau diese beiden Punkte sind für Unternehmen besonders wichtig.
In nichttechnischer Sprache besteht ein Frage-Antwort-System auf Basis einer Unternehmenswissensdatenbank üblicherweise aus vier Schritten:
- Aufbereitung der Unterlagen. Richtliniendokumente, Produkthandbücher, Verträge und Ähnliches werden in kurze Abschnitte (Chunks) zerlegt, und für jeden Abschnitt wird ein Index angelegt, damit er später inhaltlich gefunden werden kann.
- Retrieval. Nach der Frage eines Mitarbeiters sucht das System im Index die zur Frage passendsten Abschnitte heraus. Üblich ist, die „Suche nach Bedeutung“ (Vektorsuche) mit der „Suche nach Schlüsselwörtern“ zu kombinieren. Anthropic weist darauf hin, dass die Schlüsselwortsuche besonders bei Zeichenfolgen nützlich ist, die exakt übereinstimmen müssen, etwa Produktmodellen oder Fehlercodes (Quelle).
- Antworten mit Unterlagen. Das System übergibt die gefundenen Abschnitte zusammen mit der Frage an das Sprachmodell und verlangt, ausschließlich auf Basis dieser Unterlagen zu antworten; was nicht enthalten ist, wird klar mit „Keine einschlägige Regelung gefunden“ beantwortet.
- Quellenangabe. Die Antwort enthält Quelldatei, Kapitel oder Seitenzahl, sodass Mitarbeitende das Original mit einem Klick öffnen und prüfen können.
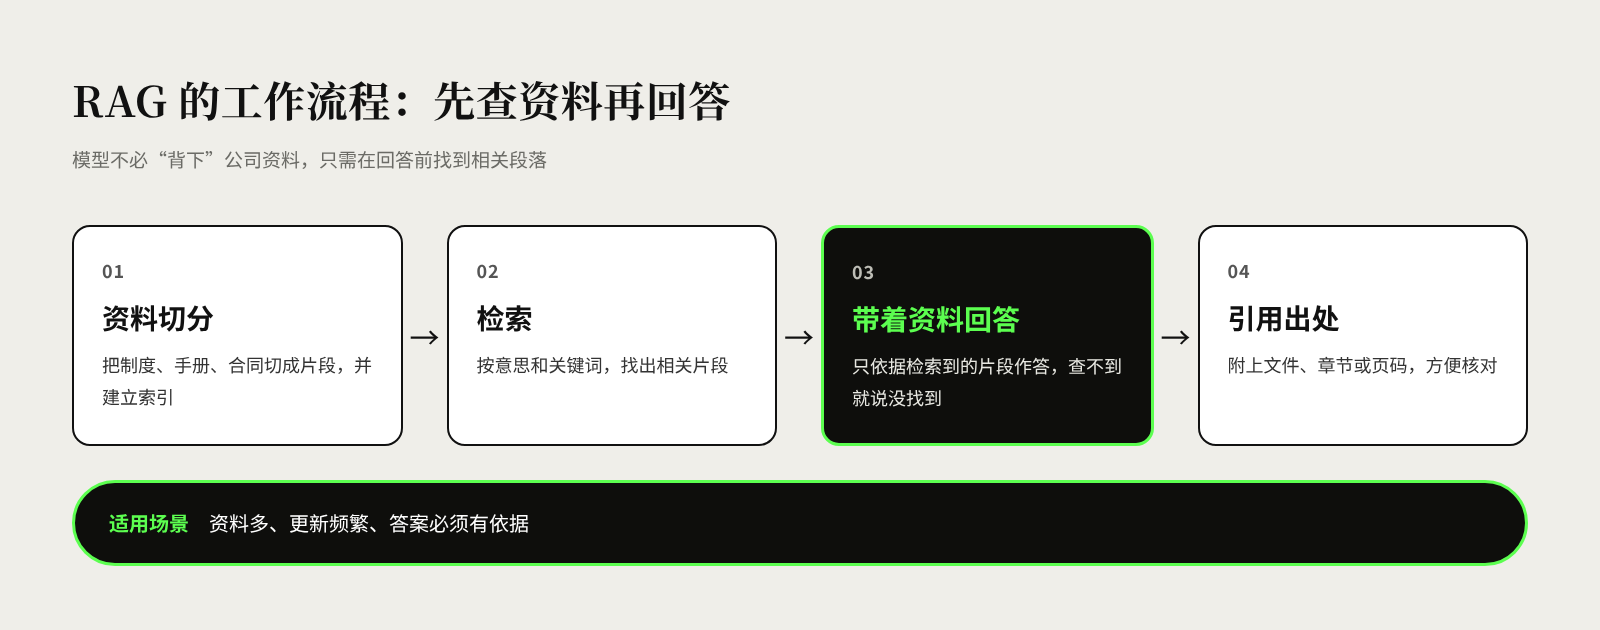
Fragt zum Beispiel ein Servicemitarbeiter: „Wie viele Jahre Garantie gilt für den Motor dieses Produktmodells?“, findet das System zunächst die einschlägige Klausel in den Produkthandbüchern und der Garantierichtlinie, erzeugt dann die Antwort und vermerkt, aus welchem Punkt der „Garantierichtlinie“ sie stammt. Der Servicemitarbeiter muss nicht das gesamte Laufwerk durchsuchen und kann dem Kunden dennoch die Grundlage klar benennen.
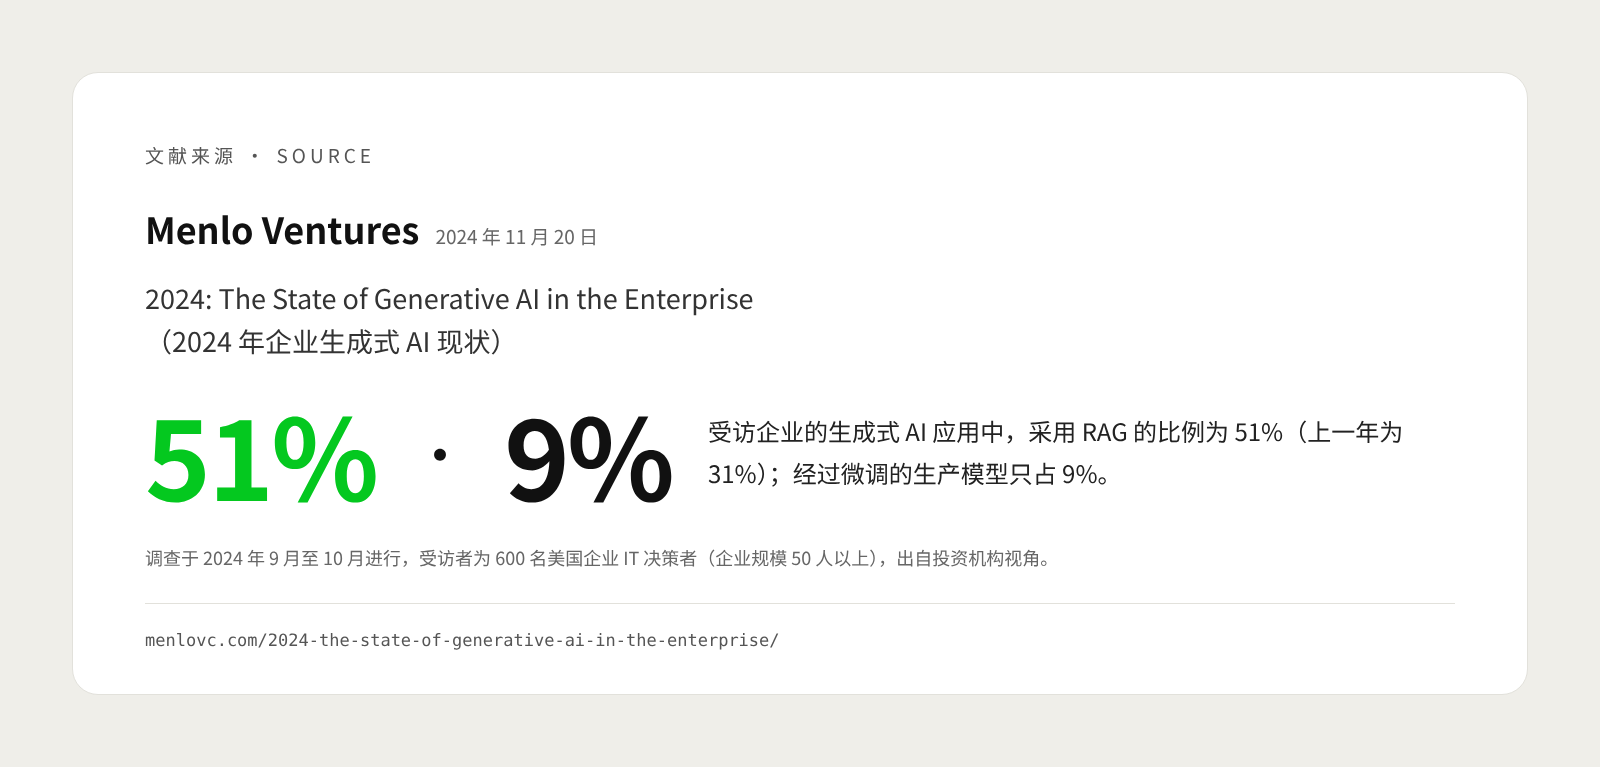
Dieses Vorgehen ist in Unternehmen bereits weit verbreitet. Die Investmentgesellschaft Menlo Ventures befragte von September bis Oktober 2024 600 IT-Entscheider in US-Unternehmen (mit mindestens 50 Beschäftigten) und stellte fest, dass unter den befragten Unternehmen 51 % bei ihren Anwendungen generativer KI auf RAG setzten, gegenüber 31 % im Vorjahr; feinabgestimmte Produktivmodelle machten nur 9 % aus (Quelle). Zu beachten ist, dass diese Umfrage nur US-Unternehmen erfasst und aus der Perspektive eines Investors stammt.
Im Unternehmen gibt es für RAG vier besonders häufige Einsatzbereiche:
- Fragen zu internen Richtlinien. Erstattungssätze, Urlaubsabläufe, Genehmigungsbefugnisse im Einkauf und Ähnliches. Neue Mitarbeitende müssen nicht ständig bei Personal- und Finanzabteilung nachfragen, und die Antworten fallen einheitlicher aus.
- Abfrage von Produktunterlagen. Vertrieb und Kundenservice finden schnell technische Daten, kompatible Modelle und Preisrichtlinien. Ein Beispiel: Der Außendienstmitarbeiter eines Großhändlers sucht beim Kunden vor Ort ein Ersatzmodell für eine bestimmte SKU.
- After-Sales-Wissensdatenbank. Werden Störungsbehebungshandbücher, frühere Tickets und Reparaturprotokolle angebunden, können Servicemitarbeitende oder Servicetechniker anhand des Störungsbilds ähnliche Fälle und Lösungswege recherchieren.
- Vertragsrecherche. Juristen und Einkäufer finden Zahlungsbedingungen, Haftung bei Vertragsverletzung und Verlängerungsklauseln oder vergleichen die Unterschiede zwischen Lieferantenverträgen. Hier ist das Risiko höher, die Antworten sollten von Menschen geprüft werden.
Gemeinsam ist ihnen: viele Unterlagen, häufige Aktualisierungen, Antworten müssen belegt sein. Das ist auch ein einfaches Kriterium dafür, ob sich ein Szenario für RAG eignet.
Worin unterscheiden sich RAG, Fine-Tuning und langer Kontext?
Es gibt drei gängige Wege, ein Modell Unternehmensunterlagen nutzen zu lassen: RAG, Fine-Tuning und langen Kontext. Für die meisten Anforderungen des Typs „nachschlagen und Fragen beantworten“ ist RAG der sicherere Ausgangspunkt; Fine-Tuning eignet sich eher dazu, dem Modell feste Formate und Ausdrucksweisen beizubringen, nicht dazu, ihm Fakten einzuflößen.
Beim Fine-Tuning (Feinabstimmung) wird das Modell mit unternehmenseigenen Beispieldaten weitertrainiert; beim langen Kontext (Long Context) wird die gesamte Unterlage direkt in den Prompt gelegt, sodass das Modell sie auf einmal liest. Die Unterschiede im Überblick:
| Vergleichspunkt | RAG (Retrieval-Augmented Generation) | Fine-Tuning | Langer Kontext |
|---|---|---|---|
| Grundprinzip | Vor der Antwort werden relevante Abschnitte abgerufen | Das Modell wird mit Beispieldaten nachtrainiert | Die gesamte Unterlage wird auf einmal in den Prompt gelegt |
| Geeigneter Bedarf | Viele Unterlagen, häufige Aktualisierung, Quellenangabe erforderlich | Feste Formate, Tonalität, Fachterminologie, Klassifikationsaufgaben | Geringe Datenmenge oder einmalige Analyse eines langen Dokuments |
| Aktualisierung der Unterlagen | Dokumente und Index aktualisieren genügt | Erfordert oft erneutes Training | Muss bei jedem Aufruf erneut eingefügt werden |
| Quellenangabe | Leicht umzusetzen | Kaum umzusetzen | Möglich, muss aber über den Prompt vorgegeben werden |
| Berechtigungssteuerung | Beim Retrieval nach fragender Person filterbar | Kaum möglich, das Wissen ist in die Modellparameter eingeflossen | Muss vor dem Einfügen manuell ausgewählt werden |
| Hauptkosten | Aufbereitung der Unterlagen, Aufbau und Pflege von Index und Retrieval | Datenaufbereitung, Training und wiederholte Evaluierung | Kosten und Wartezeit für die Verarbeitung großer Textmengen bei jedem Aufruf |
| Hauptgrenze | Was nicht gefunden wird, wird schlecht beantwortet | Halluziniert weiterhin, einzelne Wissenseinträge lassen sich kaum löschen | Bei zu vielen Unterlagen reicht der Platz nicht, Informationen mitten in langen Texten werden leicht übersehen |
Der Vergleich in der Tabelle gilt für den Normalfall; die konkrete Abwägung hängt zusätzlich von Datenumfang und Nutzungshäufigkeit ab.
Bei geringer Datenmenge ist langer Kontext eine einfache Lösung, die man in Betracht ziehen sollte. In einem Fachbeitrag vom September 2024 empfiehlt Anthropic: Ist die Wissensdatenbank kleiner als etwa 200.000 Token (ein Token ist die Grundeinheit, in der das Modell Text verarbeitet; diese Größenordnung entspricht etwa 500 Seiten Material), kann man den gesamten Inhalt direkt in den Prompt legen, ohne RAG aufzubauen; erst bei größeren Wissensdatenbanken braucht es eine skalierbarere Lösung (Quelle).
Doch „hineinpassen“ heißt nicht „sorgfältig gelesen“. Forschende der Stanford University und weiterer Einrichtungen stellten in der Arbeit „Lost in the Middle“ fest: Befindet sich die entscheidende Information am Anfang oder Ende einer langen Eingabe, ist die Leistung des Modells am besten; in der Mitte lässt sie deutlich nach, selbst bei Modellen, die eigens für langen Kontext entwickelt wurden (Quelle). In der Praxis werden die drei Methoden daher oft kombiniert. Beispielsweise findet man zunächst per RAG den zur Frage passenden Vertrag und legt dann den gesamten Vertrag in den Kontext, um ihn Klausel für Klausel zu lesen.
Warum funktionieren viele Unternehmenswissensdatenbanken schlecht?
Wenn eine Wissensdatenbank schlecht antwortet, liegt das Problem meist nicht beim Modell, sondern bei den Unterlagen und ihrer Pflege. RAG verstärkt nur die Qualität der Unterlagen selbst: Sind sie unordentlich, werden auch die Antworten nicht präzise.
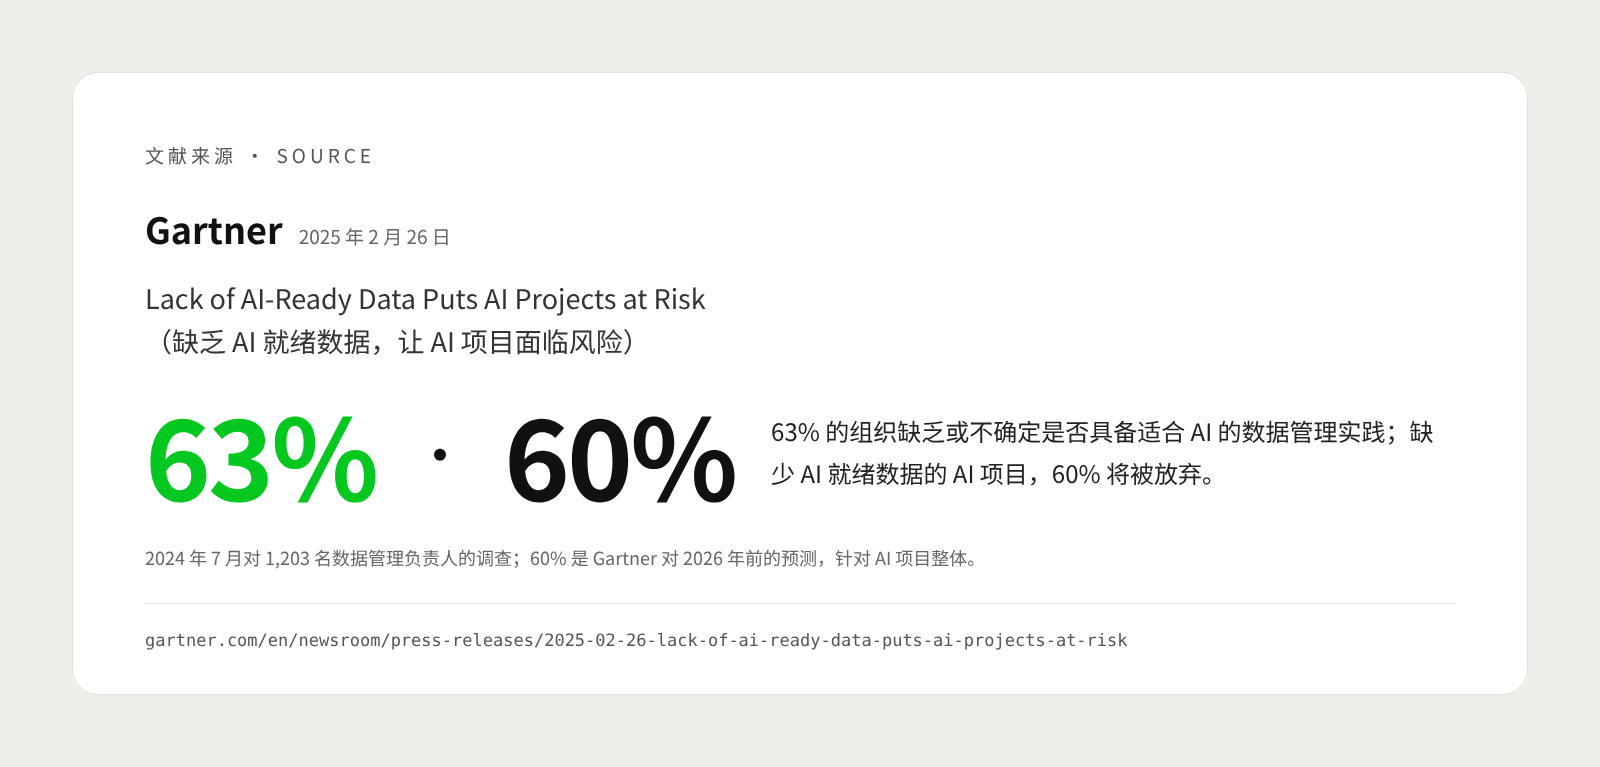
Gartner befragte im Juli 2024 1.203 Verantwortliche für Datenmanagement: 63 % der Organisationen gaben an, keine für KI geeigneten Datenmanagementpraktiken zu haben oder nicht sicher zu sein, ob sie diese haben. Gartner prognostiziert daraufhin, dass bis 2026 60 % der KI-Projekte, denen „KI-taugliche Daten“ fehlen, aufgegeben werden (Quelle). Die Umfrage bezog sich auf KI-Projekte insgesamt, gilt aber ebenso für Wissensdatenbanken.
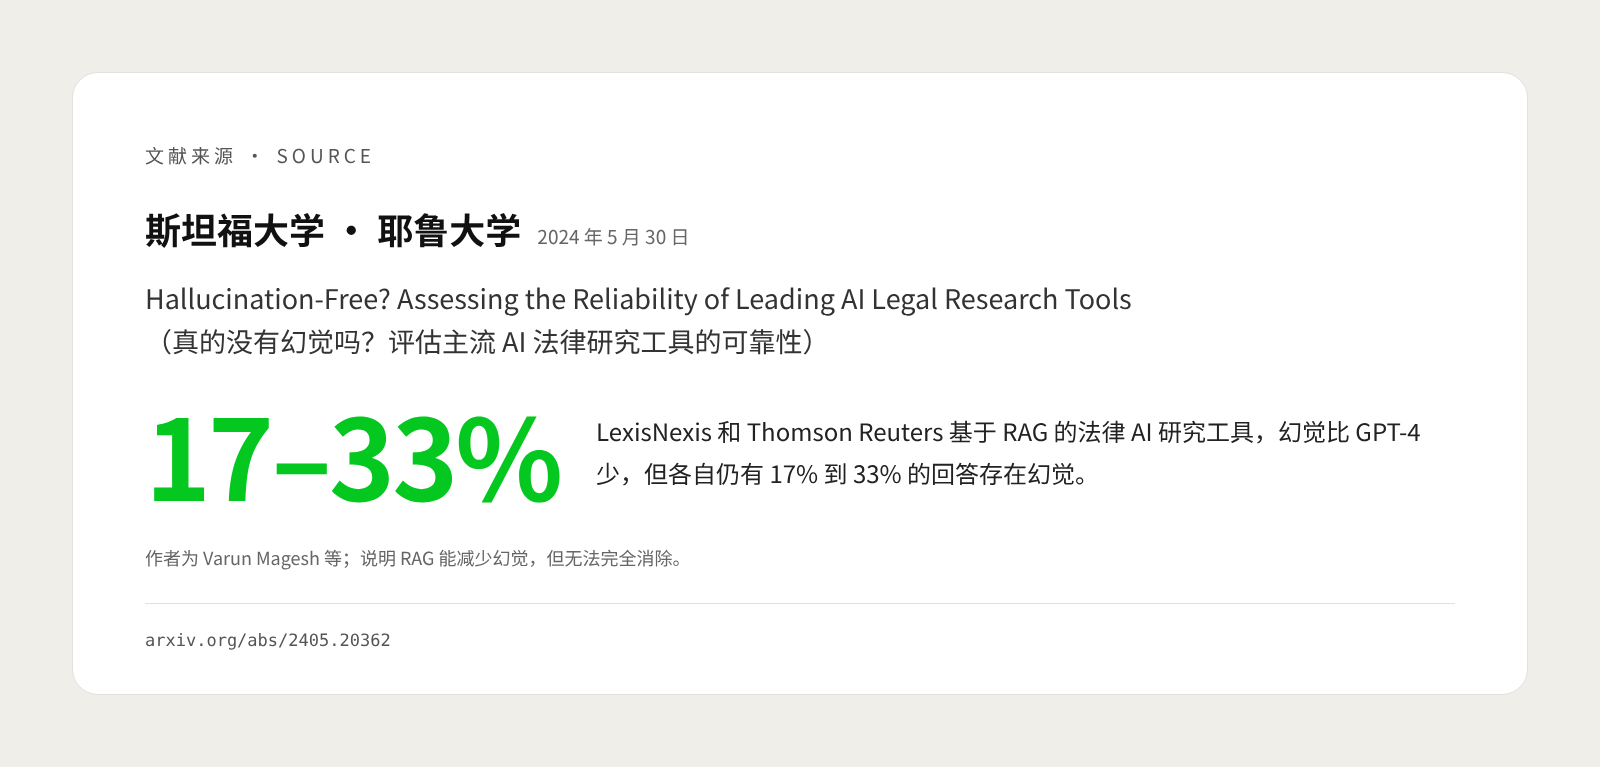
Auch Produkte spezialisierter Anbieter sind mit RAG kein Allheilmittel. Forschende der Stanford University und der Yale University evaluierten 2024 die auf RAG basierenden juristischen KI-Recherchewerkzeuge von LexisNexis und Thomson Reuters und stellten fest, dass diese zwar weniger halluzinieren als ein allgemeiner Chatbot (GPT-4), bei beiden aber dennoch 17 % bis 33 % der Antworten Halluzinationen enthielten (Quelle).
In der Unternehmenspraxis gibt es für schlechte Ergebnisse meist die folgenden fünf Gründe:
- Unterlagen sind veraltet, doppelt vorhanden oder widersprechen sich. Auf dem Laufwerk liegt dieselbe Richtlinie möglicherweise gleichzeitig als „Version 2023“, „Version 2024“ und „Final (2)“. Findet das Retrieval die alte Version, wird die Antwort falsch – und zwar sehr überzeugend falsch.
- Berechtigungen sind nicht sauber geregelt. Dass eine Wissensdatenbank angebunden ist, heißt nicht, dass jeder Gehaltstabellen oder Kundenangebote abfragen darf. Die OWASP führt in ihrer Top-10-Liste der Risiken für LLM-Anwendungen von 2025 eigens Schwachstellen bei Vektoren und Embeddings auf: Bei schwacher Zugriffskontrolle kann das Modell personenbezogene Daten oder Geschäftsgeheimnisse abrufen und preisgeben; wenn mehrere Nutzergruppen dieselbe Vektordatenbank teilen, kann es zudem zu gruppenübergreifenden Informationslecks kommen. Empfohlen wird ein Speicher, der feingranulare Berechtigungen unterstützt, und die Partitionierung der Daten nach Zugriffsstufen (Quelle).
- Chaotische Dokumentformate. Gescannte PDFs, in Bildern eingebettete Tabellen, Excel-Dateien mit verbundenen Zellen oder in PowerPoint gezeichnete Ablaufdiagramme verlieren nach der Aufteilung leicht Informationen.
- Die Aufteilung verliert den Kontext. Anthropic nennt ein Beispiel: Ein Abschnitt lautet nur „Der Umsatz des Unternehmens ist gegenüber dem Vorquartal um 3 % gestiegen“, ohne dass steht, um welches Unternehmen und welches Quartal es geht – beim Retrieval ist er dann kaum zu finden. In eigenen Tests stellte Anthropic fest, dass sich die Quote fehlgeschlagener Abrufe um 49 % senken lässt, wenn jeder Abschnitt um Kontext ergänzt und mit Schlüsselwortsuche kombiniert wird, und um 67 %, wenn zusätzlich neu gerankt wird (Quelle). Das sind Testergebnisse des Anbieters selbst, sie zeigen aber, dass die Gestaltung des Abrufverfahrens die Wirkung erheblich beeinflusst.
- Es gibt keine Evaluierung. Ohne einen Satz Standardfragen mit Standardantworten kann nach einer geänderten Aufteilung, einem Modellwechsel oder ergänzten Unterlagen niemand sagen, ob das Ergebnis besser oder schlechter geworden ist; man urteilt nur nach vereinzelten Nutzungseindrücken.
Wie baut man eine verlässliche Unternehmenswissensdatenbank auf? Schritt-für-Schritt-Anleitung
Beim Aufbau einer Unternehmenswissensdatenbank ist die Technologieauswahl oft der leichteste Teil. Beginnen Sie mit einem häufig genutzten Szenario mit klar abgegrenztem Datenbestand, bereinigen Sie zuerst die Unterlagen, legen Sie die Berechtigungen fest und sprechen Sie erst dann über Technik.
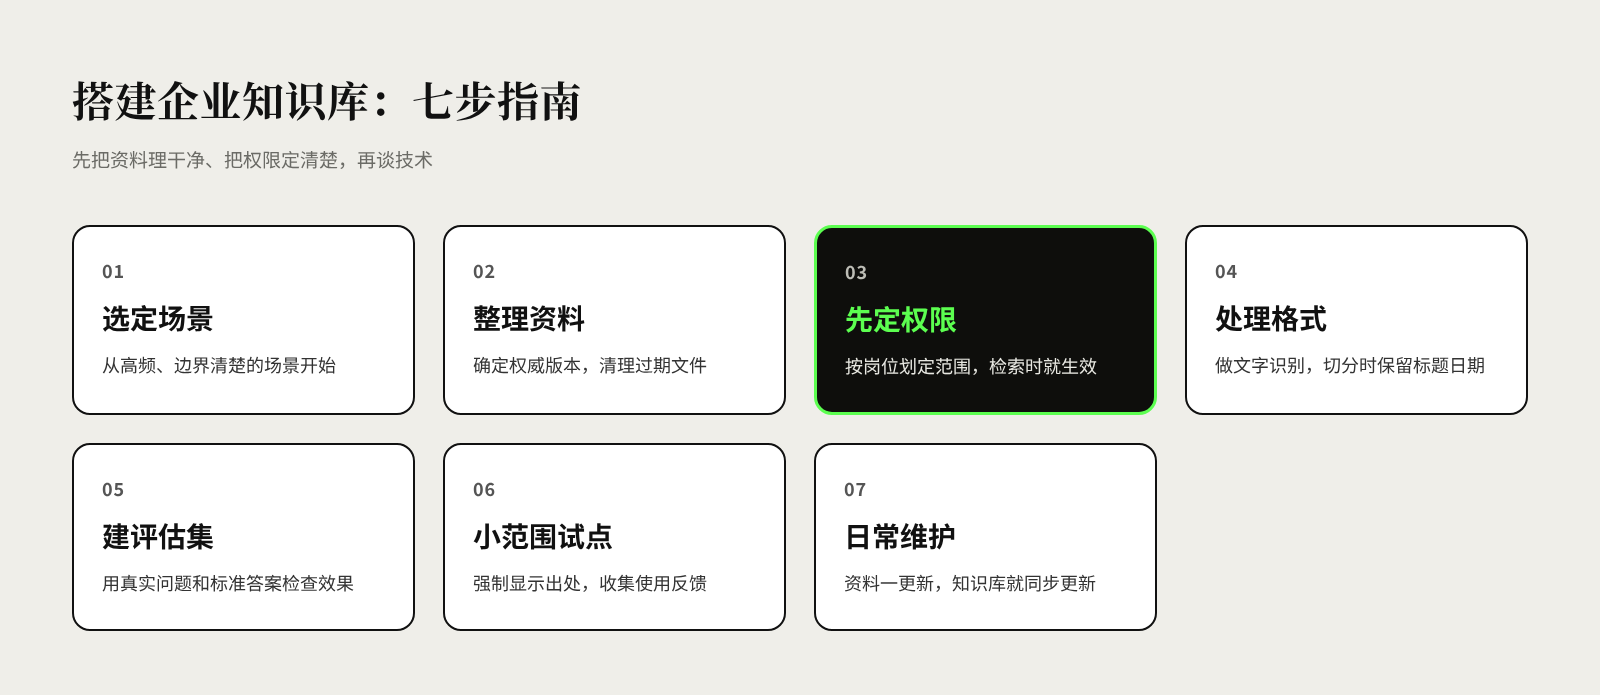
Schritt 1: Ein konkretes Szenario wählen und festlegen, wer es nutzt. Zum Beispiel „Filialmitarbeitende fragen die Rückgabe- und Umtauschrichtlinie ab“ oder „der Kundenservice fragt Produktgarantiebedingungen ab“, statt von Anfang an eine „Wissensdatenbank für das gesamte Unternehmen“ zu bauen. Je konkreter das Szenario, desto klarer sind Datenumfang und Erfolgskriterien.
Schritt 2: Unterlagen erfassen und ordnen. Ermitteln Sie für jede Art von Unterlagen die maßgebliche Version, löschen Sie Duplikate und veraltete Dateien und benennen Sie für jedes Dokument eine verantwortliche Person und einen Aktualisierungsrhythmus. Dieser Schritt ist am aufwendigsten, bestimmt aber die Obergrenze der Wissensdatenbank.
Schritt 3: Zuerst die Berechtigungsregeln festlegen. Teilen Sie die Sichtbarkeit der Unterlagen nach Abteilung, Funktion, Filiale oder Kunde auf und übernehmen Sie dabei möglichst die bestehenden Berechtigungseinstellungen der Ursprungssysteme. Berechtigungen sollten bereits beim Retrieval greifen: Das System durchsucht nur Unterlagen, die die fragende Person einsehen darf, statt erst abzurufen und das Modell dann zu bitten, „nichts zu sagen“.
Schritt 4: Formate aufbereiten und sinnvoll aufteilen. Wenden Sie auf gescannte Dokumente Texterkennung an und wandeln Sie wichtige Tabellen in ein strukturiertes Format um; behalten Sie bei der Aufteilung für jeden Abschnitt Angaben wie Dateiname, Kapitelüberschrift und Gültigkeitsdatum bei, damit Abschnitte nicht aus dem Zusammenhang gerissen werden.
Schritt 5: Einen Evaluierungsfragensatz aufbauen. Sammeln Sie an der Basis eine Reihe realer Fragen und notieren Sie Standardantworten samt zugehöriger Quelle. Prüfen Sie nach jeder Anpassung mit demselben Satz: Wurden die richtigen Unterlagen gefunden? Ist die Antwort korrekt? Stimmt die Quellenangabe? Wird wahrheitsgemäß „Nichts gefunden“ geantwortet, wenn die Unterlagen nichts hergeben?
Schritt 6: Pilot im kleinen Rahmen, Quellenanzeige erzwingen. Lassen Sie zunächst ein Team oder einige Filialen die Lösung nutzen, zeigen Sie bei jeder Antwort die Quelle an und bieten Sie Feedback-Schaltflächen „hilfreich / nicht hilfreich“ an. Prüfen Sie regelmäßig die unbeantworteten und falsch beantworteten Fragen und ergänzen oder korrigieren Sie darauf aufbauend die Unterlagen.
Schritt 7: Die Pflege zum Alltagsprozess machen. Sobald Richtlinien und Produktunterlagen aktualisiert werden, muss auch die Wissensdatenbank mitziehen. Auch Gartner betont, dass KI-taugliche Daten keine „einmalige“ Aufgabe sind (Quelle). Nehmen Sie „Wissensdatenbank synchronisieren“ in die Checklisten für die Veröffentlichung von Richtlinien und die Einführung neuer Produkte auf.
Häufige Fragen zu Unternehmenswissensdatenbanken und RAG
Sind die Daten sicher, wenn ich Unternehmensunterlagen an KI übergebe? Das hängt von der Bereitstellungsart und den Vertragsbedingungen des Anbieters ab. Bei der Auswahl sollten mindestens vier Punkte geklärt werden: wo die Daten gespeichert werden, ob sie zum Training von Modellen verwendet werden, wie lange sie aufbewahrt werden und wer darauf zugreifen kann. Bei hochsensiblen Unterlagen lässt sich ein On-Premises-Betrieb erwägen oder der Verwendungsumfang der Daten vertraglich eindeutig festlegen.
Können Mitarbeitende über die Wissensdatenbank Unterlagen sehen, die sie nicht sehen sollen? Ohne Berechtigungssteuerung ist das tatsächlich möglich. Richtig ist, beim Retrieval nach den Berechtigungen der fragenden Person zu filtern und dem Modell nur Abschnitte zu übergeben, die sie einsehen darf. Man darf nicht darauf bauen, dass das Modell selbst beurteilt, wer was sehen darf.
Muss man sie unbedingt selbst aufbauen? Nicht unbedingt. Viele Office-Programme und Kundenservicesysteme bringen bereits eine Frage-Antwort-Funktion für Wissensdatenbanken mit; bei geringer Datenmenge und Standardszenarien können Sie die Wirkung zunächst mit einem fertigen Produkt prüfen. Müssen mehrere interne Systeme angebunden werden, sind die Berechtigungen komplex oder wird ein On-Premises-Betrieb verlangt, kommt eine individuelle Lösung oder Eigenentwicklung in Betracht. In beiden Fällen lassen sich Aufbereitung der Unterlagen und Wirkungsevaluierung nicht überspringen.
Hört die KI mit RAG auf, Unsinn zu erzählen? Nein. RAG kann Halluzinationen deutlich verringern, aber nicht vollständig beseitigen; die zuvor erwähnte Evaluierung der juristischen Werkzeuge belegt das. Verlangen Sie bei jeder Antwort eine Quellenangabe und behalten Sie bei Hochrisikofragen wie Verträgen und Finanzen die menschliche Prüfung bei.
Quellen
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis et al. (Facebook AI Research, University College London, New York University), NeurIPS 2020, Mai 2020
- Why language models hallucinate, OpenAI, September 2025
- 2024: The State of Generative AI in the Enterprise, Menlo Ventures, November 2024
- Introducing Contextual Retrieval, Anthropic, September 2024
- Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu et al., Transactions of the Association for Computational Linguistics, Juli 2023
- Lack of AI-Ready Data Puts AI Projects at Risk, Gartner, Februar 2025
- Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Varun Magesh et al. (Stanford University, Yale University), Mai 2024
- LLM08:2025 Vector and Embedding Weaknesses, OWASP, 2025


