Was passiert ist
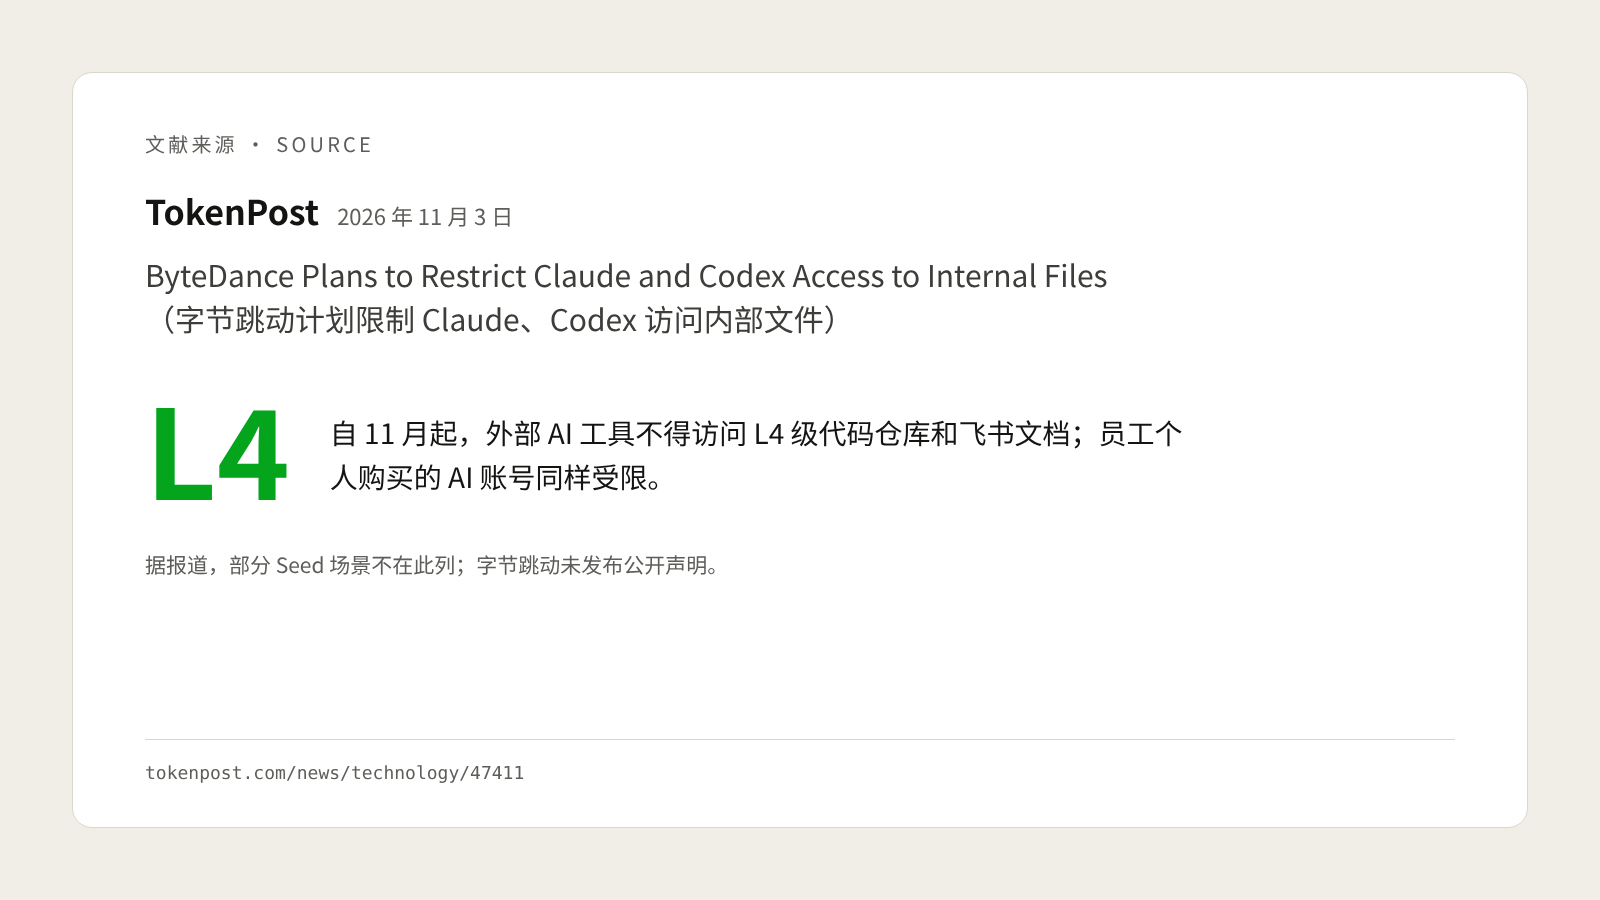
Am 3. November berichtete „Dachang Ribao“ (大厂日爆), ByteDance habe neue Regeln erlassen, die die Nutzung externer KI-Tools wie Claude und Codex im Unternehmen einschränken. Auch TokenPost berichtete am selben Tag darüber (Quelle). ByteDance hat sich dazu bislang nicht öffentlich geäußert; alle folgenden Angaben stammen aus Medienberichten.
Die neuen Regeln umfassen im Wesentlichen drei Punkte:
- Umfang der Beschränkung: Seit November wird unternehmensweit der Zugriff externer KI auf Code-Repositories und Lark-Dokumente der Stufe L4 beschränkt. Laut TokenPost sind einzelne Seed-Szenarien ausgenommen.
- Auch private Konten sind betroffen: Auch von Mitarbeitenden selbst erworbene private KI-Konten wie Claude oder Codex dürfen nicht für den Zugriff auf diese Inhalte genutzt werden.
- Kein generelles Verbot: Die Regeln verbieten den Mitarbeitenden die Nutzung externer KI nicht; im Mittelpunkt steht die Beschränkung des Zugriffs auf sensible interne Daten.
Die neuen Regeln lösten intern Diskussionen aus. Berichten zufolge antwortete Dingkun Hong, Vice President Technology bei ByteDance, im Intranet: „Wenn Inhalte der Stufe L3 und höher durchsickern, sind die Folgen sehr gravierend.“ Zu Spekulationen von außen, es gehe darum, die eigenen KI-Produkte zu fördern, sagte er: „Um ein Produkt zu fördern, muss man nicht andere Optionen verbieten und die Nutzung erzwingen, denn das wirkt sehr schlecht.“
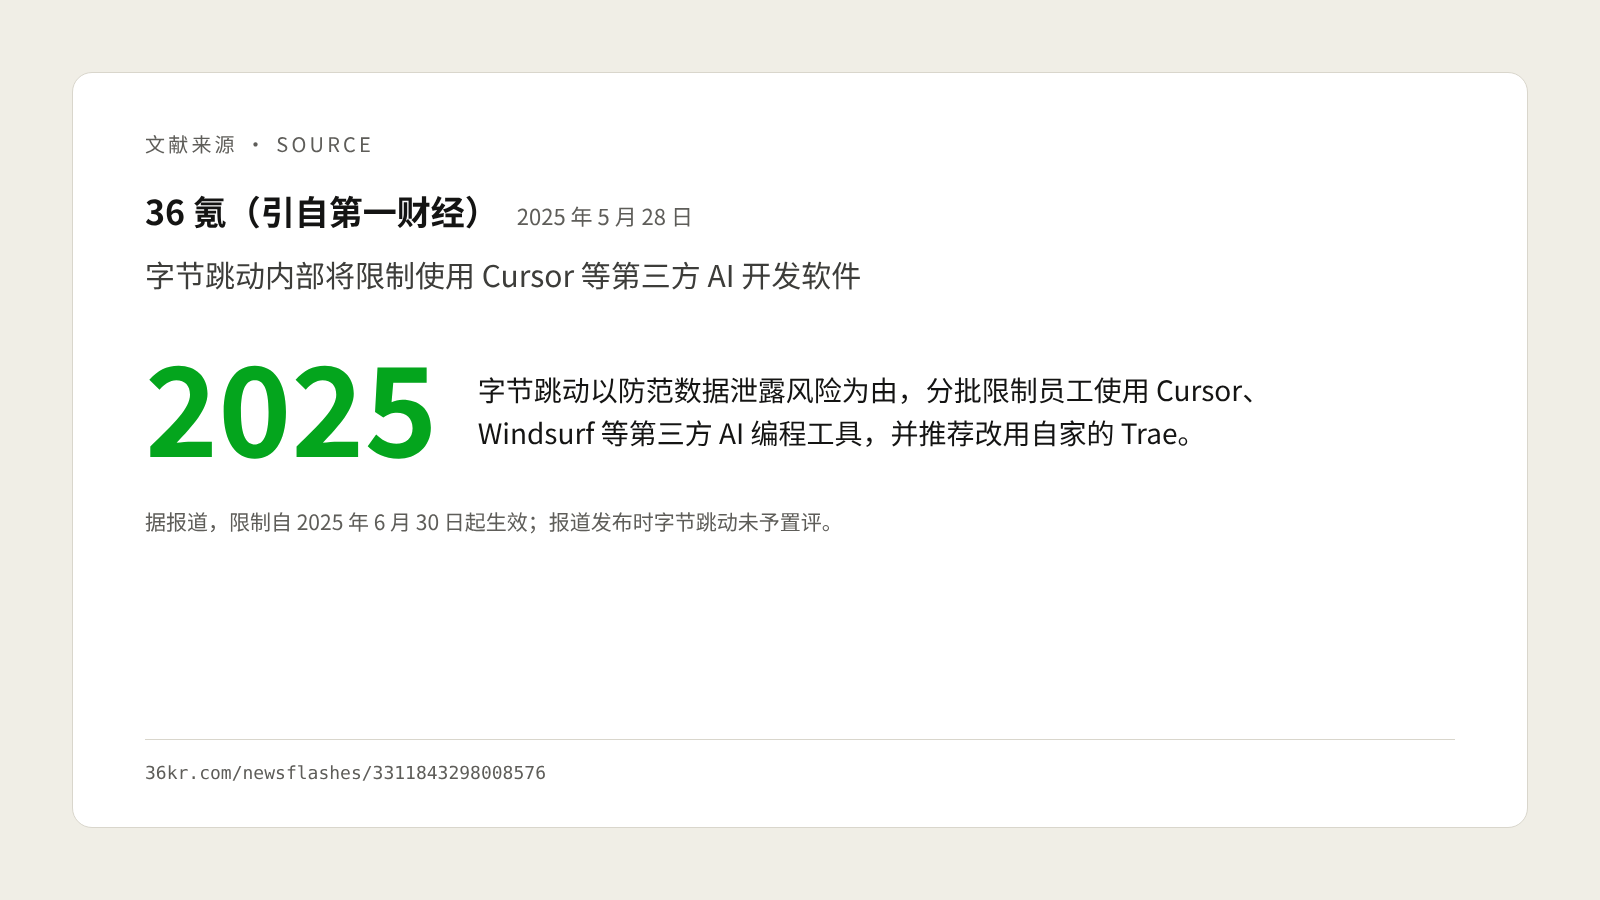
Es ist auch nicht das erste Mal, dass ByteDance externe KI-Tools beschränkt. Im Mai 2025 begrenzte ByteDance laut Yicai mit Verweis auf das Risiko von Datenabflüssen schrittweise die Nutzung von KI-Programmierwerkzeugen Dritter wie Cursor und Windsurf durch die Mitarbeitenden und empfahl stattdessen das hauseigene Trae (Quelle). Von der Einschränkung einer Werkzeugkategorie hin zu Grenzen nach Datenstufen ist der Steuerungsansatz erkennbar feiner geworden.
Die Regeln steuern nicht die KI, sondern die Grenzen der Daten
Bemerkenswert an der neuen Regelung ist nicht das Wort „Beschränkung“, sondern die Art, wie beschränkt wird.
Erstens: Sie richtet sich nach Datenstufen, nicht pauschal nach Tools. Gegenstand der Regelung sind Code-Repositories und Lark-Dokumente der Stufe L4; Inhalte anderer Stufen sind nicht mit untersagt. Das bedeutet, dass ByteDance intern zunächst ein Datenklassifizierungssystem etabliert hat und weiß, welche Inhalte öffentlich sind, welche intern und bei welchen ein Abfluss schwerwiegende Folgen hätte. Die Kontrolle baut auf der Klassifizierung auf.
Zweitens: Sie bezieht auch private Konten ein. Viele Unternehmensregelungen zu KI betreffen nur die vom Unternehmen beschafften Tools, nicht aber Konten, die Mitarbeitende selbst bezahlen. Sobald Daten aber in ein privates Konto gelangen, verlassen sie den Kontrollbereich des Unternehmens: Es weiß nicht, wo sie gespeichert sind, und kann sie auch bei einem Weggang der Mitarbeitenden nicht zurückholen. Als ByteDance 2025 Tools wie Cursor beschränkte, war laut TokenPost der Auslöser, dass Geschäftsdaten in privaten Konten abgelegt worden waren.
Drittens: Sie stellt die Mitarbeitenden nicht gegen sich. In Hongs Antwort steckt ein entscheidender Satz: Wer Mitarbeitende durch das Verbot anderer Optionen zur Nutzung eines bestimmten Tools zwingt, erreicht damit „sehr wenig“. Darin liegt das Eingeständnis, dass Mitarbeitende externe KI nutzen, weil sie wirklich gut ist. Ein pauschales Verbot drängt die Nutzung nur in den Untergrund, und das Unternehmen sieht die Risiken dann noch weniger.
Anders gesagt: Die neue Regelung beantwortet nicht die Frage, ob KI genutzt werden soll, sondern die, auf welche Daten KI zugreifen darf.
Warum selbst große Konzerne die Zügel anziehen
Das Risiko externer KI-Tools liegt nicht darin, dass die Tools selbst unzuverlässig wären, sondern darin, dass das Unternehmen nicht mehr kontrolliert, wohin die Daten gehen. In dem Moment, in dem Mitarbeitende einen Codeabschnitt, einen Vertrag oder eine Kundentabelle in ein Chatfenster kopieren, verlassen diese Inhalte die Systeme des Unternehmens. Wo sie gespeichert werden, wie lange und ob sie den Bedingungen Dritter unterliegen, kann oft niemand genau sagen.
ByteDance ist nicht das erste große Unternehmen, das deshalb Grenzen zieht:
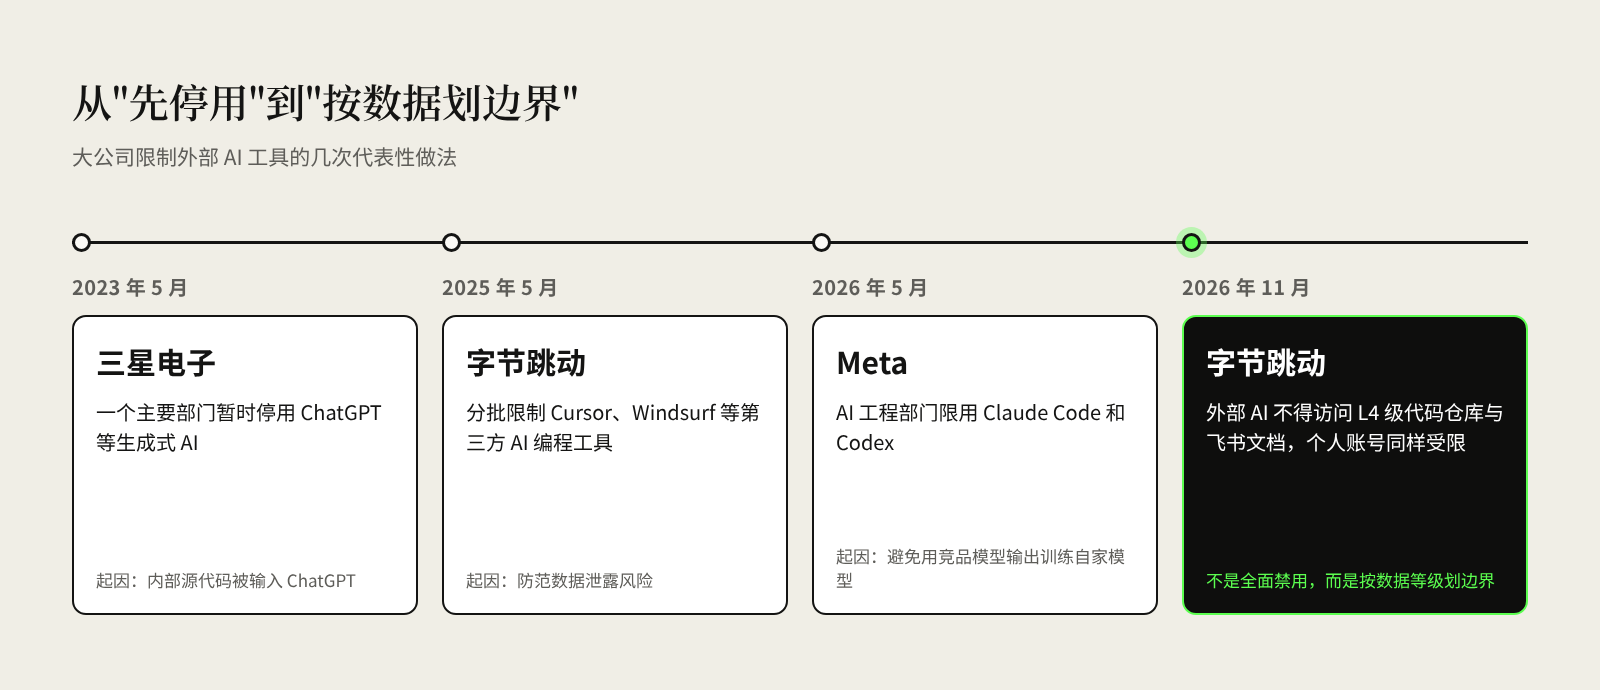
| Zeitpunkt | Unternehmen | Maßnahme | Hauptgrund |
|---|---|---|---|
| Mai 2023 | Samsung Electronics | Vorübergehendes Verbot generativer KI wie ChatGPT für Mitarbeitende in einem wichtigen Geschäftsbereich | Berichten zufolge hatten Ingenieure beim Debugging internen Quellcode in ChatGPT eingegeben (Quelle) |
| Mai 2025 | ByteDance | Schrittweise Beschränkung von KI-Programmierwerkzeugen Dritter wie Cursor und Windsurf | Vorbeugung von Datenabflüssen (Quelle) |
| Mai 2026 | Meta | Beschränkung der Nutzung von Claude Code und Codex im KI-Engineering-Bereich | Vermeidung, dass mit Ausgaben von Modellen der Konkurrenz versehentlich die eigenen Modelle trainiert werden (Quelle) |
| November 2026 | ByteDance | Beschränkung des Zugriffs externer KI auf Code-Repositories und Lark-Dokumente der Stufe L4, einschließlich privater Konten | Verhinderung des Abflusses sensibler Daten (Quelle) |
Die Beweggründe sind nicht überall dieselben, doch der Trend ist klar: Vom „erst einmal alles abschalten“ bei Samsung damals bis zur heutigen „Grenze nach Datenstufen“ bei ByteDance gehen große Unternehmen von groben Verboten zu feiner Governance über.
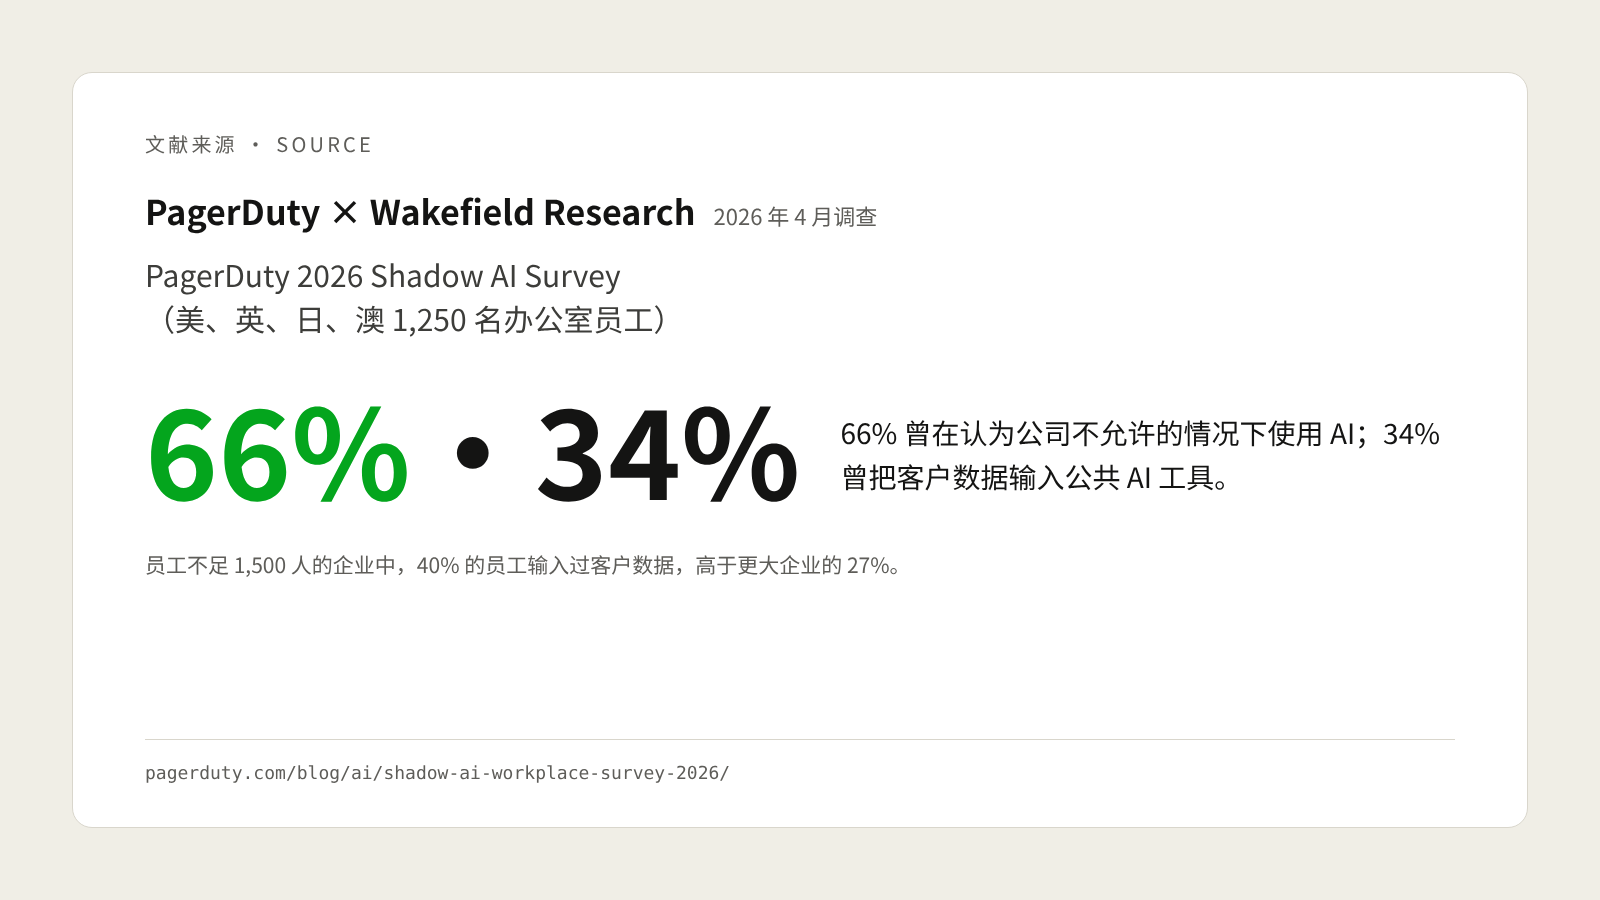
Das Problem betrifft auch nicht nur Konzerne. Eine von PagerDuty bei Wakefield Research in Auftrag gegebene Umfrage vom April 2026 ergab, dass 34 % der Büroangestellten schon einmal Kundendaten in öffentliche KI-Tools eingegeben haben; in Unternehmen mit weniger als 1.500 Beschäftigten sind es 40 % und damit mehr als in größeren Unternehmen (Quelle). Große Unternehmen haben zumindest Sicherheitsteams und Klassifizierungssysteme, kleine und mittlere haben oft gar nichts davon.
Was kleine und mittlere Unternehmen übernehmen können
Kleine und mittlere Unternehmen müssen die Regelwerke der Konzerne nicht kopieren, doch der Gedanke hinter ByteDances neuer Regelung lässt sich leicht übernehmen. Im Kern geht es um drei Dinge.
Erstens: Daten in Stufen einteilen. Dafür braucht es kein kompliziertes System, eine Tabelle genügt. Hier ein Vorschlag zur Orientierung:
| Stufe | Typische Inhalte | Dürfen an externe KI-Tools übergeben werden? |
|---|---|---|
| Öffentlich | Texte der Website, veröffentlichte Produktbeschreibungen, öffentliche Richtlinien | Ja |
| Intern | Allgemeine Arbeits-E-Mails, Besprechungsprotokolle, interne Prozessbeschreibungen | Nur über vom Unternehmen freigegebene Tools und ohne Namen und Beträge |
| Sensibel | Kundenlisten und personenbezogene Daten, Angebote und Kosten, Verträge, Beschäftigtendaten | Nicht in externe öffentliche Tools, nur in der eigenen Umgebung des Unternehmens verarbeiten |
| Kritisch | Finanzdaten, Lieferantenkonditionen, Quellcode, Geschäftsstrategie | Grundsätzlich nicht in externe Tools; Zugriff auf einen eingeschränkten Personenkreis begrenzen |
Für Unternehmen, die in Spanien und der EU tätig sind, unterliegen personenbezogene Daten von Kunden und Beschäftigten zudem der Datenschutz-Grundverordnung (DSGVO). Sie in nicht geprüfte externe Tools einzugeben, ist nicht nur eine Frage der Steuerung, sondern kann auch ein Compliance-Problem sein.
Zweitens: Eine Liste zugelassener Tools festlegen und den Umgang mit privaten Konten klären. Führen Sie die vom Unternehmen freigegebenen KI-Tools auf und bevorzugen Sie Unternehmensversionen: Sie erlauben in der Regel eine zentrale Kontenverwaltung und regeln im Vertrag den Umgang mit Daten; die konkreten Bedingungen sind jeweils zu prüfen. Sagen Sie den Mitarbeitenden zugleich klar: Private Konten dürfen zum Lernen und für öffentliche Unterlagen genutzt werden, sensible und kritische Daten gehören jedoch nicht in private Konten.
Drittens: Den Mitarbeitenden eine gute Alternative bieten. Das wird am leichtesten übersehen, und es ist auch der Sinn von Hongs Satz: Nur zu verbieten, ohne etwas anzubieten, wirkt schlecht. Brauchen Mitarbeitende KI wirklich, um Kundenanliegen zu bearbeiten, Aufträge aufzubereiten oder Buchungen abzugleichen, sollte das Unternehmen ein Tool bereitstellen, das in seinem eigenen Kontrollbereich liegt: angebunden an die eigenen Daten und die Wissensdatenbank, mit rollenbasierten Berechtigungen und nachvollziehbaren Nutzungsprotokollen. Haben die Mitarbeitenden eine bessere Option, kopieren sie Unterlagen nicht mehr heimlich in externe Tools.
Das ist auch der erste Schritt, den SHEPHARD beim Entwurf intelligenter Lösungen für Unternehmen geht: erst Datengrenzen und Berechtigungen klären, dann die KI an das Geschäft anbinden – sicher und kontrollierbar.
Fazit: Erst Grenzen ziehen, dann loslassen
Die neuen Regeln von ByteDance sind dem Anschein nach eine „Verschärfung“, in Wahrheit aber eine „Grenzziehung“: KI darf genutzt werden, doch es muss klare Grenzen geben, welche Daten ihr übergeben werden dürfen und an welches Tool.
KI-Tools werden nur besser werden, und die Mitarbeitenden werden sie nur häufiger nutzen. Aufgabe des Unternehmens ist nicht, diese Kraft aufzuhalten, sondern zuerst die Datengrenzen klar zu ziehen und dann beruhigt KI ins Geschäft zu lassen. Große Unternehmen holen diese Lektion bereits nach; kleine und mittlere müssen nicht warten, bis etwas passiert ist.
Wenn Sie die Datenklassifizierung und die Regeln für den KI-Einsatz in Ihrem Unternehmen ordnen möchten, buchen Sie gerne eine kostenlose Beratung.
Quellen
- ByteDance Plans to Restrict Claude and Codex Access to Internal Files, TokenPost, 3. November 2026
- ByteDance wird intern die Nutzung von KI-Entwicklungssoftware Dritter wie Cursor einschränken, 36Kr (zitiert Yicai), Mai 2025
- Meta schränkt die Nutzung von Claude und Codex durch KI-Ingenieure ein, um die Destillation von Drittmodellen zu verhindern, ITHome (zitiert The Information), Juni 2026
- Samsung bans staff from using generative AI after privacy gaffe, The Register, Mai 2023
- PagerDuty 2026 Shadow AI Survey, PagerDuty, 2026


