Che cosa è successo
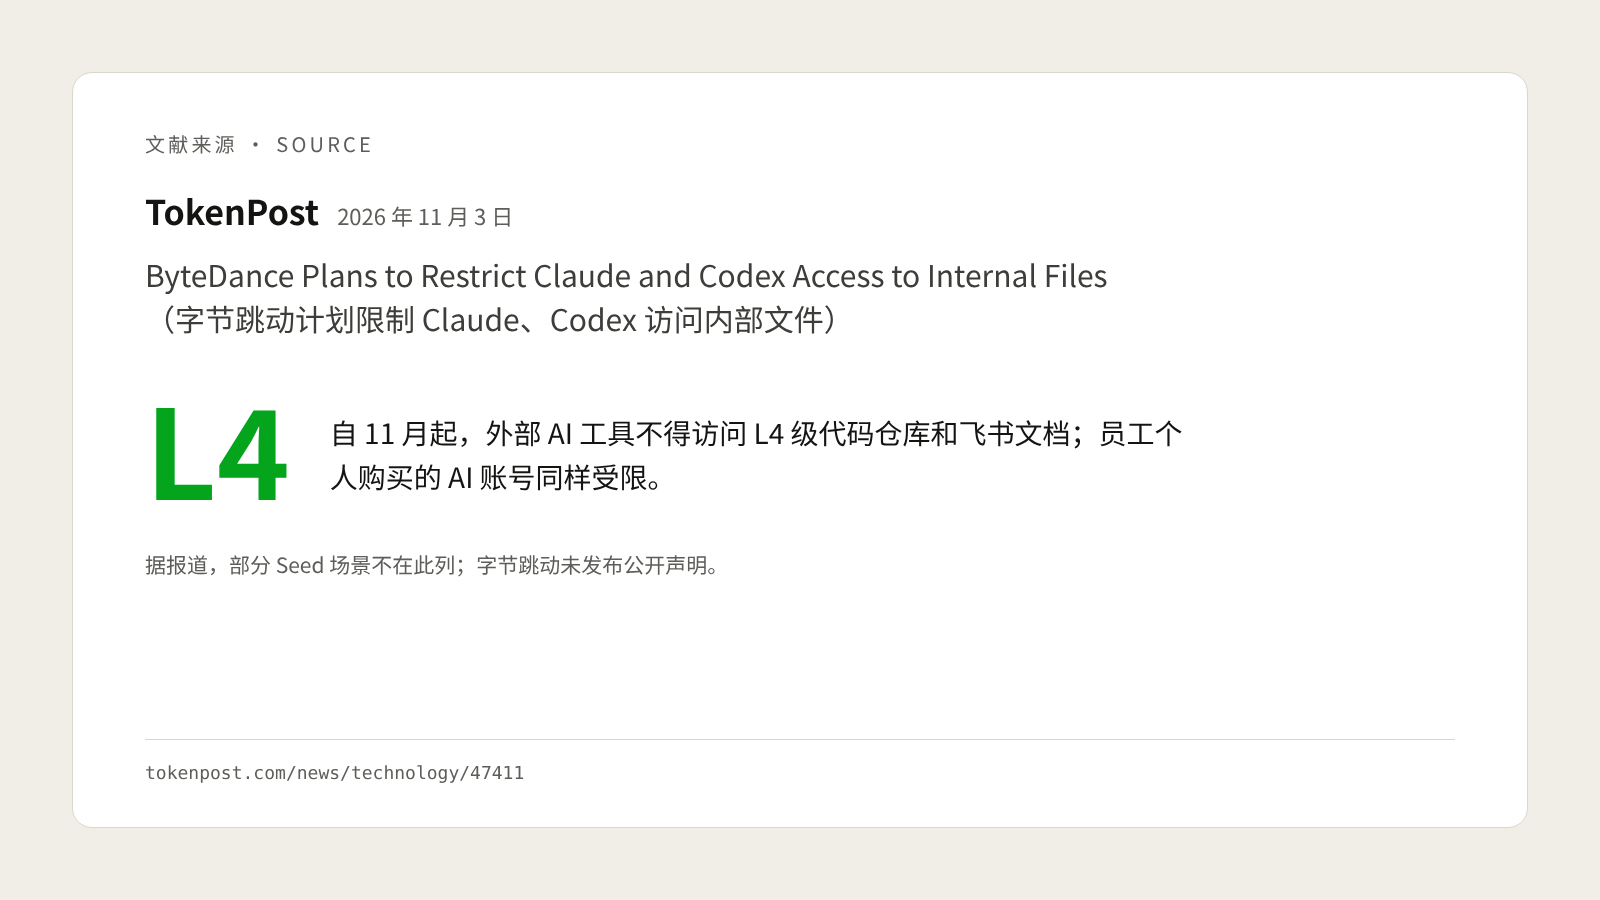
Il 3 novembre, secondo Dachang Ribao, ByteDance ha introdotto nuove regole che restringono i permessi di utilizzo, all'interno dell'azienda, di strumenti di IA esterni come Claude e Codex. Lo stesso giorno anche TokenPost ha riportato la notizia (fonte). ByteDance al momento non ha rilasciato alcuna dichiarazione pubblica: quanto segue proviene interamente da notizie di stampa.
Le nuove regole prevedono tre punti principali:
- Ambito delle restrizioni: da novembre, in tutta l'azienda, l'accesso di IA esterne ai repository di codice e ai documenti Lark di livello L4 è limitato. Secondo TokenPost, alcuni scenari di Seed sono esclusi.
- Limiti anche per gli account personali: gli account di IA personali acquistati autonomamente dai dipendenti, come Claude e Codex, non possono essere usati per accedere a tali contenuti.
- Non è un divieto generalizzato: le regole non vietano ai dipendenti di usare IA esterne; l'obiettivo è limitare il loro accesso ai dati interni sensibili.
Le nuove regole hanno suscitato discussione all'interno dell'azienda. Secondo quanto riportato, il vicepresidente tecnico di ByteDance, Dingkun Hong, ha risposto sulla intranet: «Se i contenuti di livello L3 e superiori dovessero essere divulgati, le conseguenze sarebbero molto gravi». Alle voci esterne secondo cui l'obiettivo sarebbe «promuovere i propri prodotti di IA», ha replicato: «Per promuovere un prodotto non serve imporne l'uso eliminando le altre opzioni, perché l'effetto sarebbe pessimo».
Non è la prima volta che ByteDance pone limiti agli strumenti di IA esterni. Nel maggio 2025, secondo Yicai, ByteDance aveva limitato a scaglioni l'uso da parte dei dipendenti di strumenti di programmazione con IA di terze parti come Cursor e Windsurf, con la motivazione di prevenire il rischio di fuga di dati, raccomandando di passare a Trae, di produzione propria (fonte). Dalla limitazione di una categoria di strumenti alla definizione dei confini in base al livello dei dati, l'approccio gestionale è chiaramente diventato più raffinato.
Le nuove regole non riguardano l'IA, ma i confini dei dati
Ciò che più colpisce di queste regole non è la parola «restrizione», ma il modo in cui restringono.
Primo: classificano per livello di dati, non vietano gli strumenti in blocco. Le regole riguardano i repository di codice e i documenti Lark di livello L4; i contenuti degli altri livelli non vengono vietati nel loro insieme. Ciò significa che ByteDance dispone già al proprio interno di un sistema di classificazione dei dati: sa quali contenuti sono pubblici, quali interni e quali, se divulgati, avrebbero conseguenze gravi. Il controllo si fonda sulla classificazione.
Secondo: includono anche gli account personali. Molte aziende regolamentano l'IA solo per gli strumenti acquistati dall'azienda, ma non riescono a controllare gli account che i dipendenti pagano di tasca propria. Eppure, una volta che i dati entrano in un account personale, escono dal perimetro di controllo dell'azienda: l'azienda non sa dove vengano conservati e non può recuperarli quando il dipendente se ne va. Secondo TokenPost, quando nel 2025 ByteDance ha limitato strumenti come Cursor, la causa era stata proprio il salvataggio di dati di business in account personali.
Terzo: non spingono i dipendenti sul fronte opposto. Nella risposta di Dingkun Hong c'è una frase decisiva: imporre un certo strumento eliminando le altre opzioni ha un effetto «pessimo». Di fatto è il riconoscimento di un dato di fatto: i dipendenti usano le IA esterne perché sono davvero utili. Un divieto generalizzato non fa che spingerne l'uso nell'ombra, e l'azienda finisce per vedere ancora meno dove sia il rischio.
In altre parole, le nuove regole non rispondono alla domanda «usare o no l'IA», ma a quella «a quali dati può accedere l'IA».
Perché persino i grandi gruppi stringono le maglie
Il rischio degli strumenti di IA esterni non sta nel fatto che gli strumenti siano inaffidabili, ma nel fatto che la destinazione dei dati non è più sotto il controllo dell'azienda. Nel momento in cui un dipendente incolla in una finestra di chat un frammento di codice, un contratto o una tabella di clienti, quei contenuti escono dai sistemi dell'azienda. Dove verranno conservati, per quanto tempo, se saranno soggetti a condizioni di terzi: spesso nessuno sa dirlo.
ByteDance non è la prima grande azienda a porre dei limiti:
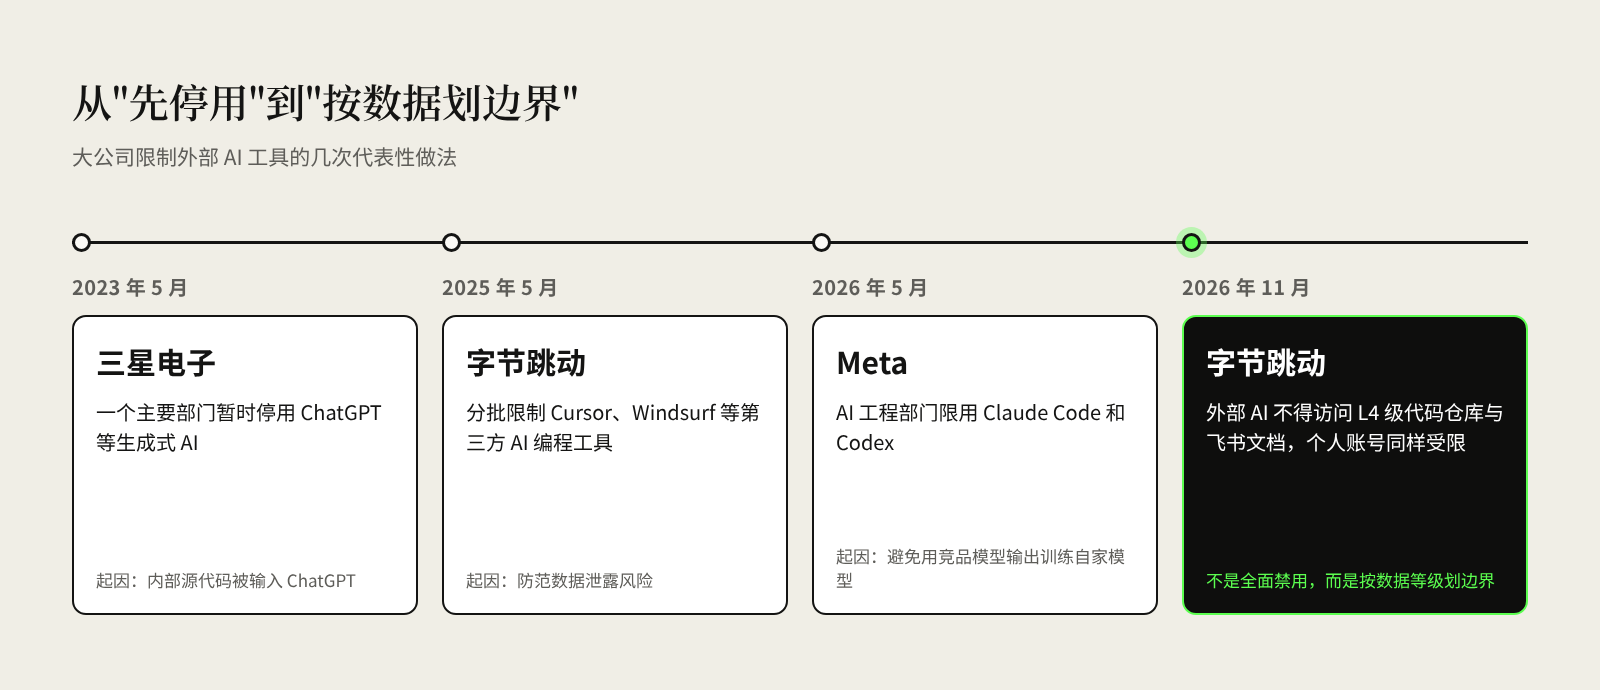
| Data | Azienda | Misura | Motivo principale |
|---|---|---|---|
| Maggio 2023 | Samsung Electronics | Divieto temporaneo, in una divisione importante, di usare IA generativa come ChatGPT | Secondo quanto riportato, alcuni ingegneri avevano inserito in ChatGPT codice sorgente interno durante il debug (fonte) |
| Maggio 2025 | ByteDance | Limitazione a scaglioni di strumenti di programmazione con IA di terze parti come Cursor e Windsurf | Prevenire il rischio di fuga di dati (fonte) |
| Maggio 2026 | Meta | Limitazione dell'uso di Claude Code e Codex nel reparto di ingegneria dell'IA | Evitare di addestrare inavvertitamente i propri modelli con gli output di modelli concorrenti (fonte) |
| Novembre 2026 | ByteDance | Limitazione dell'accesso di IA esterne ai repository di codice e ai documenti Lark di livello L4, compresi gli account personali | Prevenire la fuga di dati sensibili (fonte) |
Le motivazioni delle singole aziende non coincidono del tutto, ma la tendenza è chiara: dal «fermiamo tutto» di Samsung di allora al «confini in base al livello dei dati» di ByteDance di oggi, i grandi gruppi stanno passando da divieti grossolani a una governance più fine.
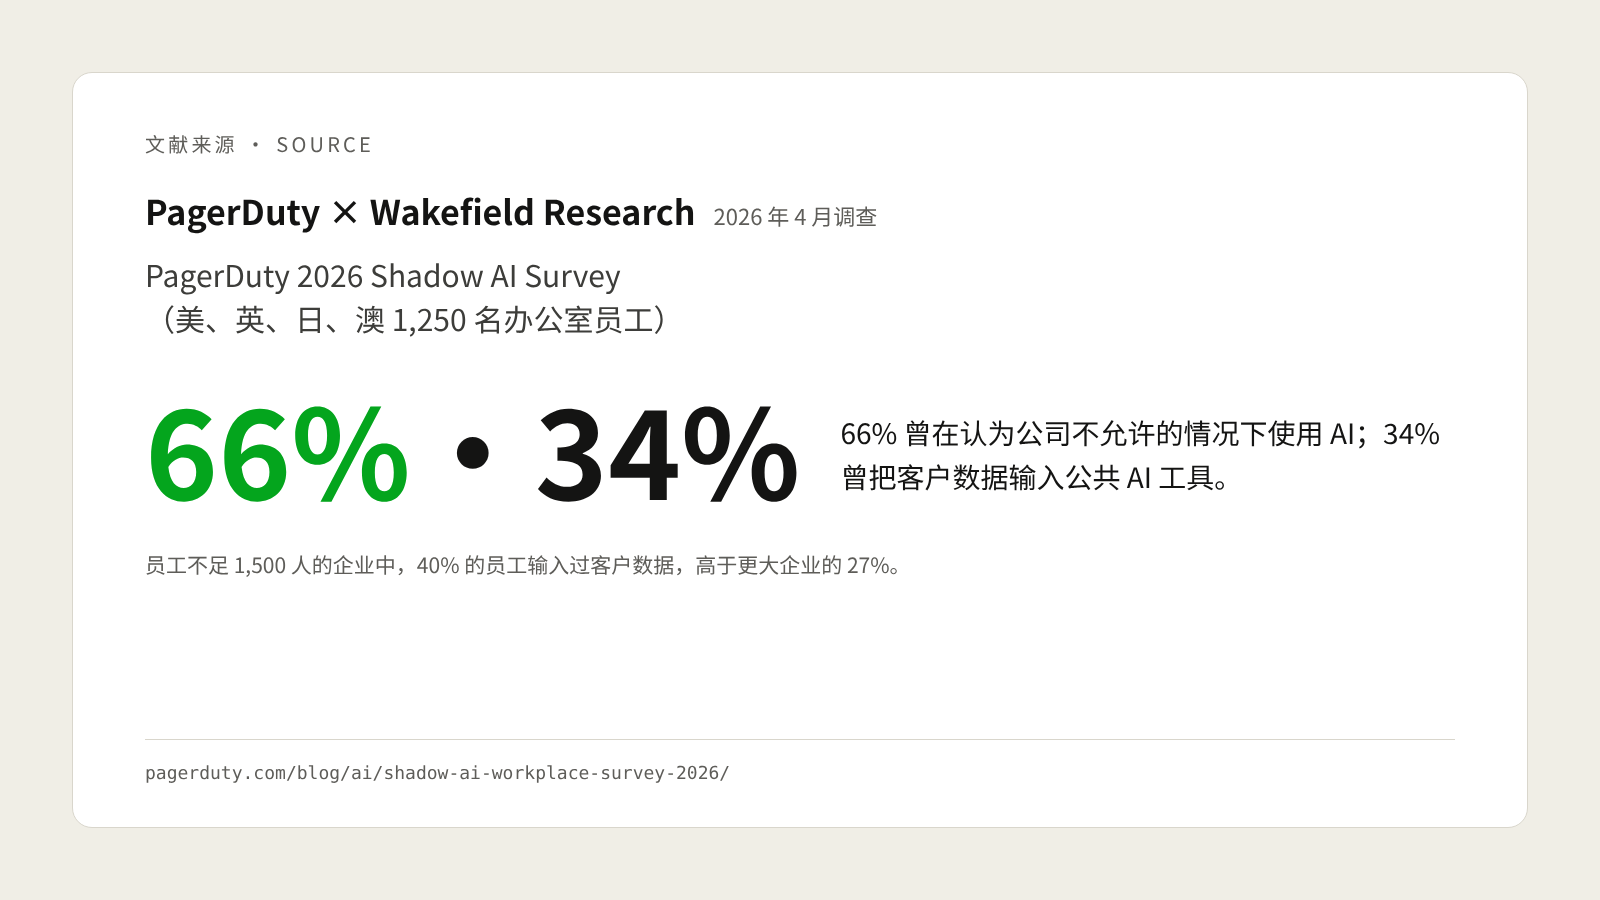
Il problema, inoltre, non riguarda solo le grandi aziende. Secondo l'indagine commissionata da PagerDuty a Wakefield Research nell'aprile 2026, il 34% dei dipendenti d'ufficio ha inserito dati dei clienti in strumenti di IA pubblici; nelle aziende con meno di 1.500 dipendenti la quota sale al 40%, più che nelle aziende più grandi (fonte). I grandi gruppi hanno almeno un team di sicurezza e un sistema di classificazione; le piccole e medie imprese spesso non hanno nulla.
Che cosa possono imitare le PMI
Le PMI non hanno bisogno di copiare il sistema dei grandi gruppi, ma la logica che sta dietro a queste regole di ByteDance è facile da adottare. Si riduce a tre cose.
Primo: classifica i dati per livello. Non serve un sistema complesso: basta una tabella. Ecco una possibile suddivisione di riferimento:
| Livello | Contenuti tipici | Si possono affidare a strumenti di IA esterni? |
|---|---|---|
| Pubblico | Testi del sito web, presentazioni di prodotto già pubblicate, politiche pubbliche | Sì |
| Interno | E-mail di lavoro ordinarie, verbali di riunione, descrizioni di processi interni | Solo con strumenti approvati dall'azienda, rimuovendo nomi di persona e importi |
| Sensibile | Elenchi clienti e dati personali, preventivi e costi, contratti, informazioni sui dipendenti | Non vanno in strumenti pubblici esterni, si trattano solo nell'ambiente dell'azienda |
| Critico | Dati finanziari, condizioni dei fornitori, codice sorgente, strategia aziendale | Mai in strumenti esterni, con accesso limitato a poche persone |
Per le aziende che operano in Spagna e nell'Unione europea, i dati personali di clienti e dipendenti sono inoltre soggetti al Regolamento generale sulla protezione dei dati (GDPR). Inserirli in strumenti esterni non valutati non è solo una questione gestionale, ma può essere anche un problema di conformità.
Secondo: definisci una whitelist di strumenti e chiarisci la questione degli account personali. Elenca gli strumenti di IA approvati dall'azienda, privilegiando le versioni aziendali: di norma consentono di gestire gli account in modo centralizzato e di stabilire per contratto come vengono trattati i dati, ma le clausole vanno verificate una per una. Al tempo stesso, spiega chiaramente ai dipendenti che gli account personali si possono usare per imparare e per trattare materiali pubblici, ma che i dati sensibili e critici non devono entrare negli account personali.
Terzo: offri ai dipendenti un'alternativa valida. È il punto che più facilmente si trascura, ed è il senso della frase di Dingkun Hong: vietare senza offrire alternative ha un effetto pessimo. Se i dipendenti hanno davvero bisogno dell'IA per gestire le questioni dei clienti, riordinare gli ordini o riconciliare i conti, l'azienda deve mettere a disposizione uno strumento sotto il proprio controllo: collegato ai dati e alla knowledge base aziendali, con permessi assegnati per ruolo e un uso tracciabile. Quando i dipendenti hanno un'opzione migliore, non incolleranno più di nascosto i materiali in strumenti esterni.
È anche il primo passo che SHEPHARD compie quando progetta soluzioni intelligenti per le aziende: prima definire i confini dei dati e i permessi, poi far entrare l'IA nel business, in modo sicuro e controllabile.
Conclusioni: prima i confini, poi la libertà d'uso
Le nuove regole di ByteDance, in apparenza, sono una «stretta»; in realtà tracciano una «linea»: l'IA si può usare, ma ci devono essere confini chiari su quali dati le si possono affidare e a quale strumento.
Gli strumenti di IA non faranno che migliorare e i dipendenti non faranno che usarli di più. Ciò che l'azienda deve fare non è sbarrare la strada a questa forza, ma tracciare prima con chiarezza i confini dei dati e poi lasciare con tranquillità che l'IA entri nel business. I grandi gruppi stanno già recuperando questa lezione; le PMI non devono aspettare che nasca un problema per farlo.
Se vuoi mettere ordine nella classificazione dei dati e nelle regole d'uso dell'IA della tua azienda, prenota una consulenza gratuita.
Riferimenti
- ByteDance Plans to Restrict Claude and Codex Access to Internal Files, TokenPost, 3 novembre 2026
- 字节跳动内部将限制使用 Cursor 等第三方 AI 开发软件, 36Kr (citando Yicai), maggio 2025
- 防止蒸馏第三方模型,Meta 限制 AI 工程师使用 Claude 与 Codex, ITHome (citando The Information), giugno 2026
- Samsung bans staff from using generative AI after privacy gaffe, The Register, maggio 2023
- PagerDuty 2026 Shadow AI Survey, PagerDuty, 2026


